遇见数据集

xpertsystems/oil014-sample

收藏
Hugging Face2026-05-22 更新2026-05-31 收录
官方服务:

资源简介:

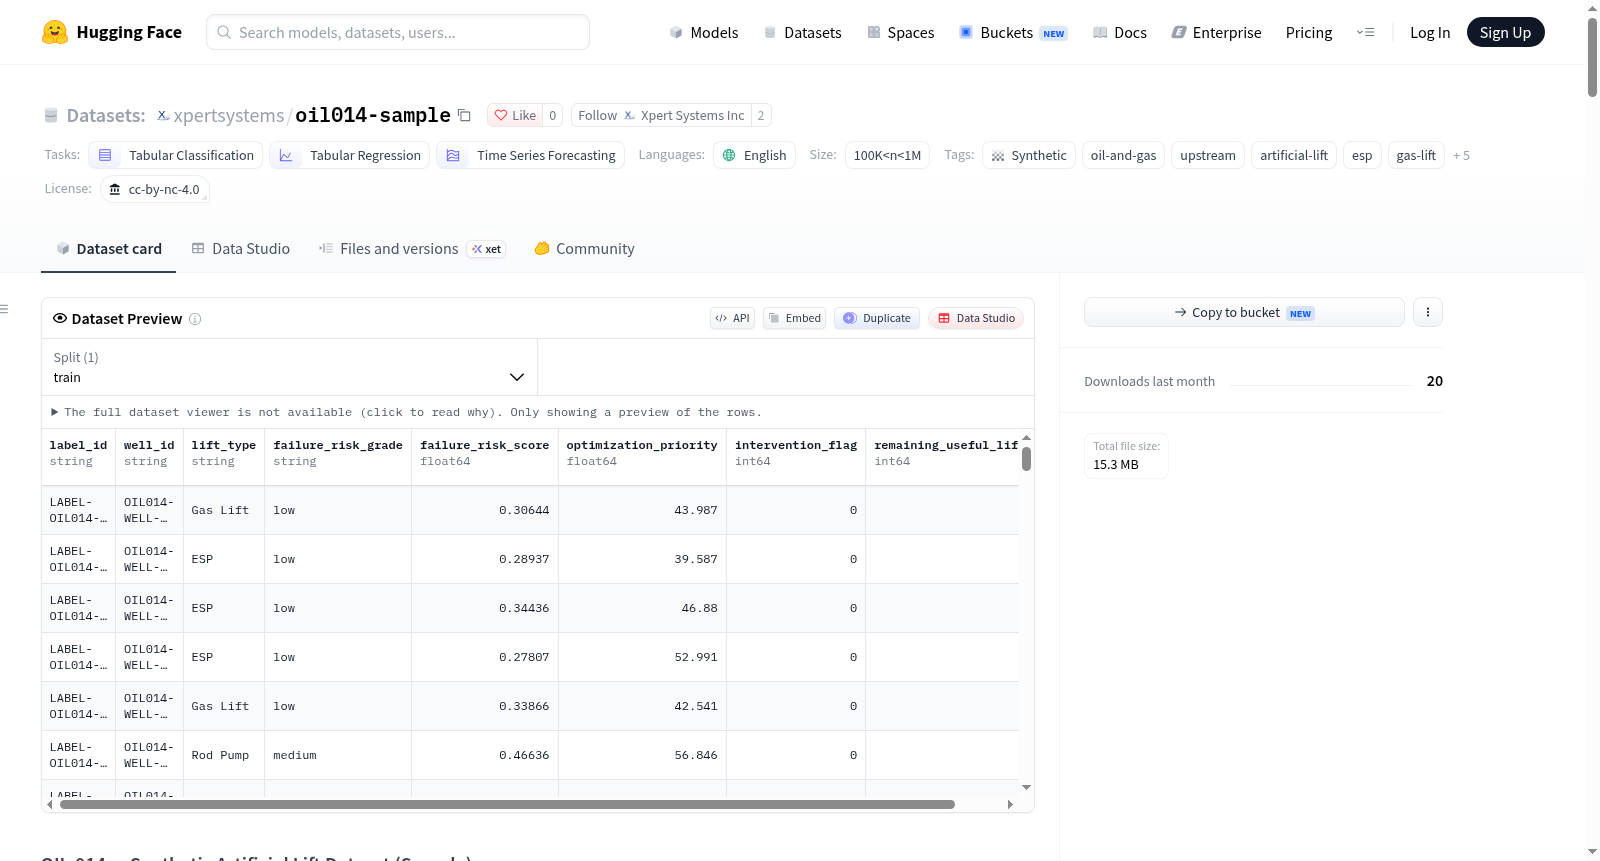
OIL-014是一个合成人工举升数据集(样本),由XpertSystems.ai提供的免费预览版本,专为ESP(电潜泵)/气举/抽油杆泵优化机器学习、故障预测、节点分析和干预优先级排序设计。该数据集模拟了全球10个盆地、5种井类型(非常规/致密/重油/海上/碳酸盐岩)的400口井,覆盖60天的操作数据,包含12个关联表格共121,707行数据。核心表格包括井主数据、ESP操作、气举操作、抽油杆泵操作、生产速率、设备健康、节点分析、功耗、故障事件、维护历史、优化建议和人工举升标签。数据生成基于行业标准(如SPE 174021、API RP-11ER等)校准,验证得分100/100(A+级),适用于多种机器学习任务,如故障预测、流体冲击检测、举升类型推荐等。

OIL-014 — Synthetic Artificial Lift Dataset (Sample) is a free, schema-identical preview of XpertSystems.ais enterprise artificial lift performance dataset for ESP/Gas Lift/Rod Pump optimization ML, failure prediction, nodal analysis, and intervention prioritization. The sample covers 400 wells across 10 global basins and 5 well classes (unconventional/tight/heavy/offshore/carbonate), simulated over 60 days, with 121,707 rows linked across 12 tables. Key tables include wells master, ESP operations, gas lift operations, rod pump operations, production rates, equipment health, nodal analysis, power consumption, failure events, maintenance history, optimization recommendations, and artificial lift labels. The dataset is calibrated to industry standards (e.g., SPE 174021, API RP-11ER) and validated with a 100.0/100 Grade A+ score, supporting ML tasks such as failure prediction, fluid-pound detection, lift-type recommendation, and more.
提供机构:
xpertsystems
搜集汇总
数据集介绍
xpertsystems/oil014-sample 数据集图片
构建方式
在油气上游人工举升领域,构建高保真合成数据集需兼顾物理机理与工业标准。该数据集以确定性种子驱动生成,覆盖10个全球盆地、5类井型与3种举升方式,模拟60天生产动态,形成12张可关联表、121,707行记录。其核心在于将SPE 174021、API RP-11ER、API 11L、SPE 14253等标准嵌入电潜泵、气举与杆泵的物理方程,如频率-负载耦合、填隙-液击反相关,并通过10指标评分卡验证,确保合成数据在统计规律与工程约束上贴近真实人工举升系统。
特点
该数据集以多表关系型结构为骨架,围绕井主数据表展开,涵盖举升操作、产量、设备健康、节点分析、能耗、故障事件、维护历史与优化建议等维度,支持多表关联机器学习。其突出特点在于物理耦合明确:电潜泵频率与负载相关系数约0.94,杆泵填隙与液击概率相关系数约-0.97,节点平衡误差约1.85%,均优于工业阈值。同时,数据规模适中而标签体系丰富,包含三分类风险等级、干预标志与剩余寿命,并提供连续性风险分数,兼顾分类与回归任务。
使用方法
在使用方法上,该数据集可通过Hugging Face datasets库按文件加载,亦可借助pandas读取CSV,并以well_id与timestamp进行多表连接。典型应用包括电潜泵故障预测、杆泵液击检测、举升方式推荐、泵抽空与气锁识别、优化优先级排序、剩余寿命回归及三分类风险评级。需注意样本规模下高风险类别稀缺,建议将failure_risk_score作为连续目标或对正例过采样;同时区分时序表与标签表中两种风险分数尺度,避免混用。对于节点分析与产量预测,可基于IPR斜率、压差与VFP压损特征构建回归模型。
背景与挑战
背景概述
石油天然气上游人工举升系统的智能化管理是提高采收率与降低运营成本的关键环节。2026年,XpertSystems.ai发布了OIL-014合成人工举升数据集,旨在为电潜泵、气举与杆泵的优化、故障预测及节点分析提供高保真基准。该数据集以SPE 174021、API RP-11ER等十余项行业标准为校准依据,包含400口井、10个全球盆地、60天模拟的121,707条记录,覆盖12张关联表。其核心研究问题在于解决真实人工举升数据稀缺且敏感所导致的机器学习模型泛化难题,通过物理耦合生成可复现的合成数据,对推动预测性维护与干预优先级排序研究具有重要影响力。
当前挑战
人工举升领域长期面临数据获取与建模的双重困境。就领域问题而言,故障预测、液击检测与气锁识别等任务需在真实工况下捕捉复杂物理信号,但实际数据因商业保密与安全限制难以公开,且故障事件稀疏导致类别极度不平衡。在构建过程中,合成数据须同时满足多表关联一致性、物理规律保真度与统计分布合理性,例如ESP频率-负载相关性、杆泵充满度-液击反相关均需严格锚定行业标准。样本规模还带来高风险等级样本缺失、电压未按电机尺寸分层等局限,对模型泛化与迁移构成挑战。
常用场景
经典使用场景
在人工举升系统智能化管理的浪潮中,OIL-014样本数据集凭借其多表关联架构与物理机理耦合特性,成为机器学习模型开发与验证的典型试验场。该数据集最经典的使用场景聚焦于故障预测与异常检测,例如基于ESP运行参数(频率、载荷因子、进气压力)构建二分类器以预警设备失效,或利用杆泵充满度与液击概率的强负相关(r≈-0.97)实现液击精准识别;同时,气锁检测、泵抽空判别及举升方式推荐等任务亦广泛采用该数据集作为基准,支撑从特征工程到模型评估的全流程研究。
衍生相关工作
OIL-014样本的发布催生了一系列围绕人工举升智能化的衍生研究。典型工作包括基于图神经网络的多表关系学习,用以捕捉井-时间-设备间的复杂依赖;结合物理信息神经网络(PINN)的液击与气锁混合诊断模型,提升了小样本下的泛化能力;此外,部分研究将其与OIL-013全Arps递减数据集联合使用,构建从举升优化到递减分析的联合工作流。这些工作不仅验证了数据集的扩展性,也推动了合成数据在油气工程领域的可信度评估与迁移学习范式的发展。
数据集最近研究
最新研究方向
在油气上游人工举升领域,设备失效预测与剩余使用寿命估计是当前研究的热点。OIL-014样本数据集通过多表关联架构,为机器学习模型提供了涵盖电潜泵、气举和杆式泵的物理耦合特征,推动了基于连续风险评分与干预优先级排序的预测性维护研究。该数据集融合SPE 174021等工业标准校准,支持节点分析与多表关系学习,为复杂举升系统优化和故障诊断提供了高保真基准,显著促进了数据驱动决策在人工举升管理中的前沿探索。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务