
GO
收藏官方服务:
资源简介:
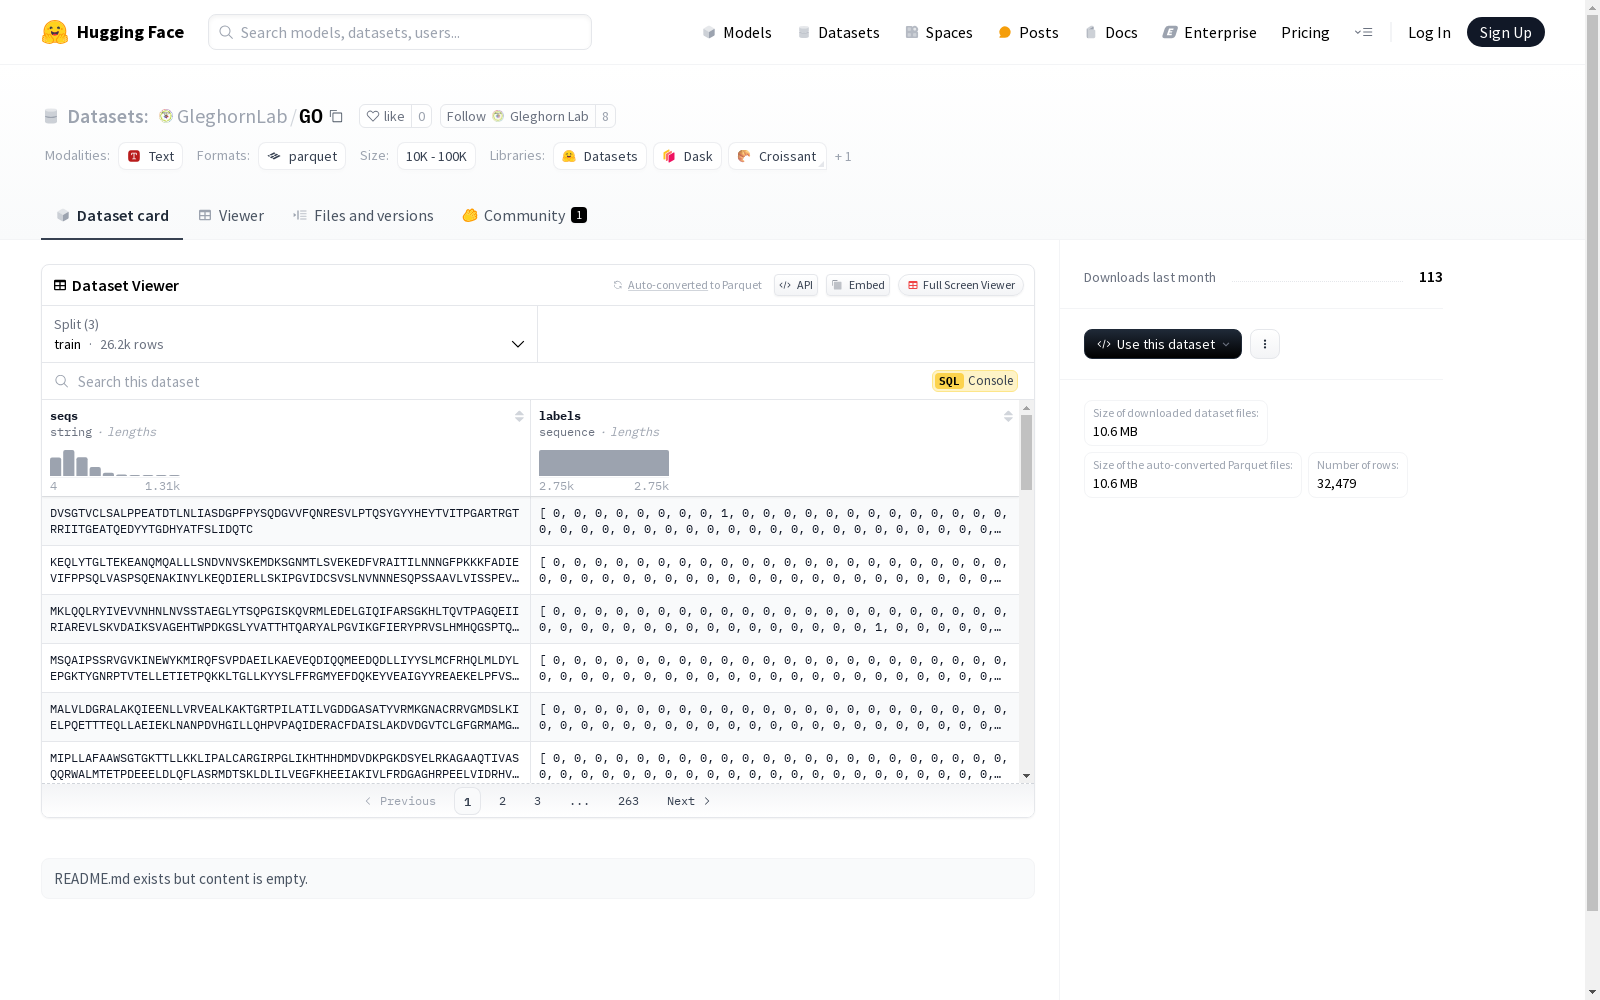
该数据集包含两个主要特征:'seqs'(字符串类型)和'labels'(整数序列类型)。数据集分为训练集、验证集和测试集,分别包含26225、2904和3350个样本。数据文件路径已指定。
This dataset includes two core features: 'seqs' (string type) and 'labels' (integer sequence type). The dataset is split into training, validation, and test sets, which contain 26225, 2904, and 3350 samples respectively. The file paths of the dataset have been specified.
提供机构:
Gleghorn Lab创建时间:
2024-11-28
搜集汇总
数据集介绍
构建方式
GO数据集的构建基于生物信息学领域中的基因本体论(Gene Ontology),通过整合多种生物数据源,提取基因序列及其对应的功能标签。数据集分为训练集、验证集和测试集,分别包含26225、2904和3350个样本,确保了数据的多样性和代表性。数据的预处理包括序列标准化和标签编码,以适配机器学习模型的输入要求。
特点
GO数据集的核心特征在于其包含的基因序列(seqs)和功能标签(labels),其中序列以字符串形式存储,标签则以整数序列表示。数据集规模庞大,总大小超过724MB,涵盖了广泛的基因功能类别。其分层的训练、验证和测试集设计,为模型训练和评估提供了坚实的基础。
使用方法
使用GO数据集时,用户可通过加载训练集、验证集和测试集进行模型训练和评估。数据文件以分片形式存储,路径分别为data/train-*、data/valid-*和data/test-*。用户可根据需求选择特定分片进行加载,并利用序列和标签数据进行基因功能预测等任务的建模与分析。
背景与挑战
背景概述
GO数据集是一个专注于序列标注任务的数据集,广泛应用于生物信息学和自然语言处理领域。该数据集由多个研究机构联合开发,旨在通过序列数据与标签的对应关系,推动序列分析技术的发展。自发布以来,GO数据集在蛋白质功能预测、基因序列分析等任务中发挥了重要作用,成为相关领域研究的重要基准。其核心研究问题在于如何通过序列数据准确预测其功能或类别,为生物信息学中的复杂问题提供了数据支持。
当前挑战
GO数据集在应用过程中面临多重挑战。首先,序列数据的复杂性和多样性使得模型在捕捉关键特征时存在困难,尤其是在处理长序列或高维数据时,模型的泛化能力受到限制。其次,标签的稀疏性和不均衡性进一步增加了预测的难度,导致模型在某些类别上的表现不佳。在构建过程中,数据收集和标注的准确性也是一个重要挑战,尤其是在生物信息学领域,序列数据的标注需要高度专业的领域知识,确保数据的可靠性和一致性成为构建过程中的关键问题。
常用场景
经典使用场景
GO数据集在生物信息学领域中被广泛用于蛋白质功能预测的研究。通过提供大量的蛋白质序列及其对应的功能标签,该数据集为机器学习模型提供了丰富的训练和测试资源,帮助研究者深入理解蛋白质的功能特性。
衍生相关工作
基于GO数据集,研究者们开发了多种先进的机器学习算法和深度学习模型,如卷积神经网络和循环神经网络,这些模型在蛋白质功能预测任务中表现出色。此外,该数据集还催生了一系列相关研究,进一步拓展了生物信息学的研究边界。
数据集最近研究
最新研究方向
在生物信息学领域,GO(Gene Ontology)数据集作为基因功能注释的重要资源,近年来在深度学习模型的训练与优化中发挥了关键作用。随着基因组数据的爆炸式增长,研究者们开始探索如何利用GO数据集中的序列和标签信息,构建更为精准的基因功能预测模型。特别是在多标签分类任务中,GO数据集的应用显著提升了模型对复杂生物过程的理解能力。此外,结合图神经网络(GNN)和注意力机制,研究者们进一步挖掘了基因之间的相互作用网络,为揭示基因功能的深层次关联提供了新的视角。这些研究不仅推动了生物信息学领域的技术进步,也为精准医学和个性化治疗提供了重要的理论支持。
以上内容由遇见数据集搜集并总结生成


