
line.10.9.10.10000
收藏官方服务:
资源简介:
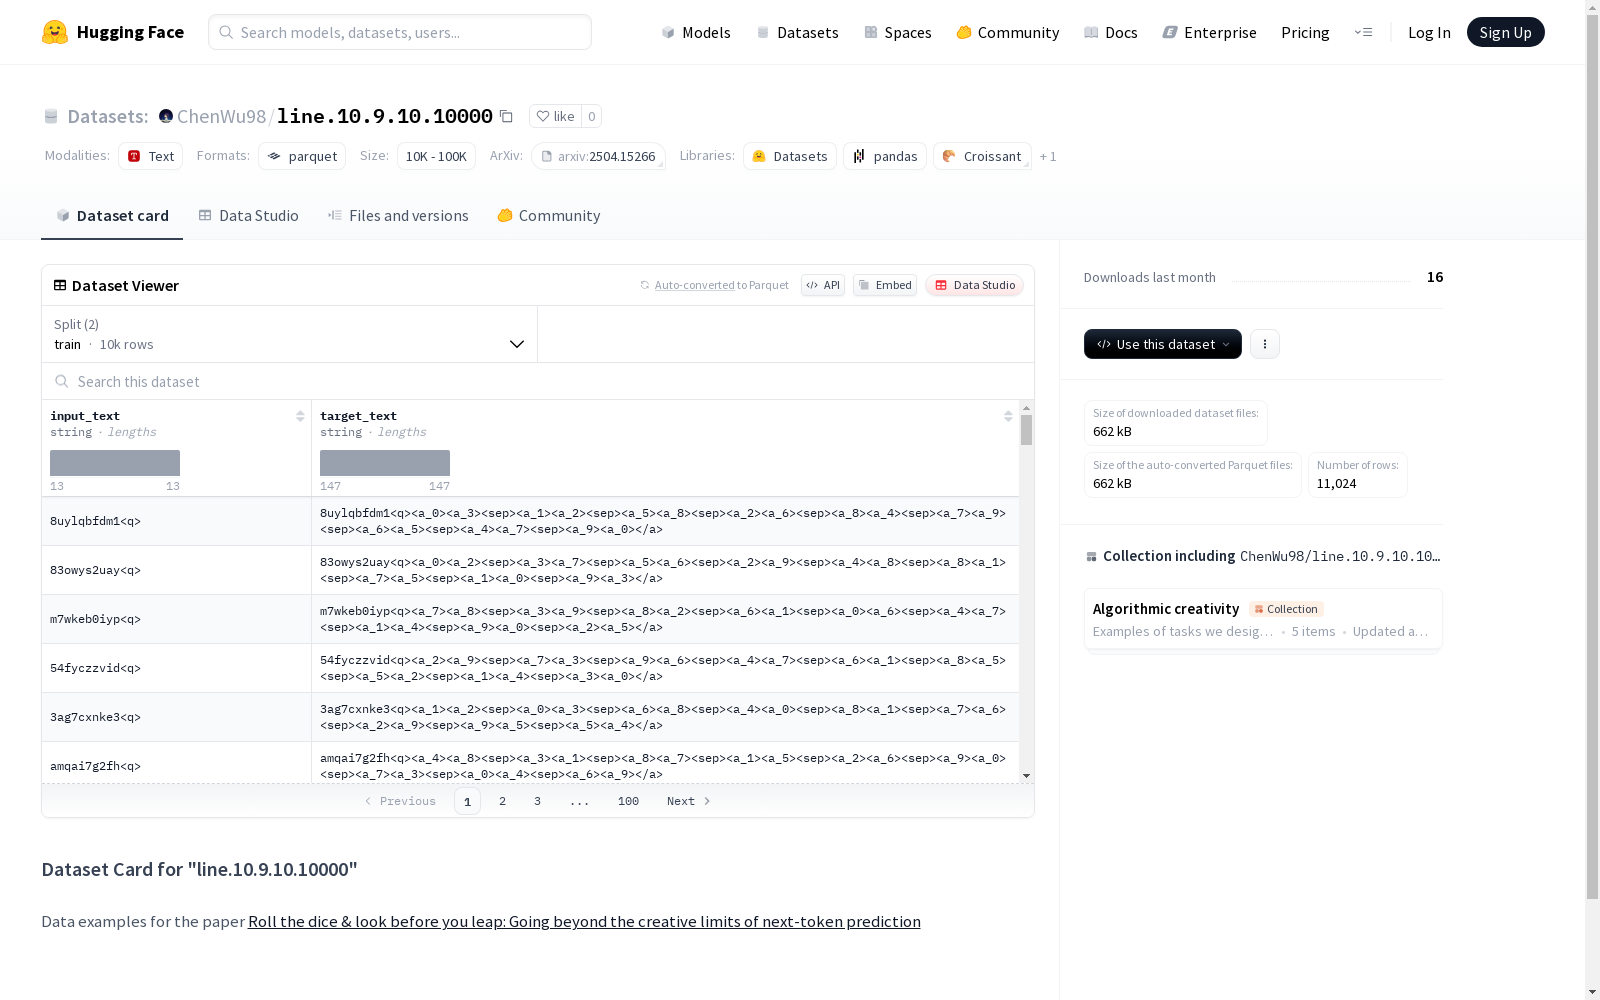
该数据集包含输入文本(input_text)和目标文本(target_text)两个字段,适用于研究文本生成任务。数据集分为训练集和验证集,其中训练集有10000个样本,验证集有1024个样本。数据集用于支持论文《Roll the dice & look before you leap: Going beyond the creative limits of next-token prediction》的研究。
This dataset comprises two fields, namely input_text and target_text, and is designed for research on text generation tasks. The dataset is split into training and validation subsets, with 10,000 samples in the training set and 1,024 samples in the validation set. This dataset supports the research reported in the paper titled "Roll the dice & look before you leap: Going beyond the creative limits of next-token prediction".
创建时间:
2025-05-27
原始信息汇总
数据集概述
基本信息
- 数据集名称: line.10.9.10.10000
- 下载大小: 662456字节
- 数据集大小: 1718912字节
数据集特征
- 输入文本:
- 名称: input_text
- 数据类型: string
- 目标文本:
- 名称: target_text
- 数据类型: string
数据划分
- 训练集:
- 样本数量: 10000
- 数据大小: 1680000字节
- 验证集:
- 样本数量: 1024
- 数据大小: 38912字节
相关论文
- 论文标题: Roll the dice & look before you leap: Going beyond the creative limits of next-token prediction
- 论文链接: https://huggingface.co/papers/2504.15266
搜集汇总
数据集介绍
构建方式
在自然语言处理领域,line.10.9.10.10000数据集的构建体现了对文本生成任务的前瞻性思考。该数据集源自研究论文《Roll the dice & look before you leap: Going beyond the creative limits of next-token prediction》,通过精心设计的文本对采集流程,收录了10,000组训练样本和1,024组验证样本。每个样本包含input_text和target_text两个字符串字段,形成完整的文本对结构,为探索超越传统token预测的创造性语言模型提供了实验基础。
使用方法
使用该数据集时,建议采用端到端的文本生成任务框架。研究者可将input_text作为生成模型的输入序列,target_text作为预期输出目标,通过对比生成结果与目标文本的差异来评估模型性能。验证集的独立设置允许进行可靠的泛化能力测试。数据集采用标准HuggingFace格式存储,可直接通过load_dataset方法加载,其轻量级特性使得在常规计算资源下也能高效开展实验。
背景与挑战
背景概述
line.10.9.10.10000数据集诞生于2024年,作为研究论文《Roll the dice & look before you leap: Going beyond the creative limits of next-token prediction》的配套数据资源,旨在探索超越传统语言模型单步预测局限性的创新方法。该数据集由自然语言处理领域的前沿研究者构建,聚焦于文本生成任务中多步推理与创造性思维的建模挑战。通过提供包含输入-输出文本对的万级样本,该研究试图突破现有自回归模型在长程依赖和发散性思维方面的瓶颈,为可控文本生成领域提供了重要的基准测试平台。
当前挑战
该数据集的核心挑战在于解决语言模型创造性生成与逻辑连贯性之间的平衡问题。传统单步预测范式难以捕捉人类写作中的跳跃性思维和远距离语义关联,而多步推理机制又面临计算复杂度指数增长的困境。在构建过程中,研究者需设计特殊的文本采样策略,既要保证输入-输出对的语义相关性,又要体现创造性思维的突破性特征。数据标注环节存在人工评估标准难以量化的难题,同时大规模高质量创意文本的获取成本也成为制约数据集规模的关键因素。
常用场景
经典使用场景
在自然语言处理领域,line.10.9.10.10000数据集为研究文本生成模型的创造性边界提供了重要支持。该数据集通过包含大量输入文本与目标文本的配对,使得研究人员能够深入探索模型在预测下一个词时的表现,尤其是在需要创造性输出的场景中。经典使用场景包括训练和评估生成式语言模型,特别是在需要模型突破传统预测模式、生成更具创造性文本的任务中。
解决学术问题
该数据集解决了生成式语言模型在创造性文本生成中的关键问题。传统模型往往受限于下一个词的预测模式,难以生成具有高度创造性的文本。通过提供多样化的输入与目标文本配对,该数据集帮助研究人员探索如何让模型超越简单的词预测,实现更具创造性的输出。这在推动自然语言生成技术的发展方面具有重要意义,为突破模型创造性瓶颈提供了新的研究思路。
实际应用
在实际应用中,line.10.9.10.10000数据集可用于开发需要高度创造性文本生成的系统,如广告文案生成、诗歌创作辅助工具以及故事生成器等。这些应用场景要求模型不仅能够理解输入文本的语义,还需要具备一定的创造性思维来生成新颖且符合语境的输出。该数据集为这些应用的模型训练和评估提供了高质量的数据支持。
数据集最近研究
最新研究方向
在自然语言生成领域,line.10.9.10.10000数据集因其独特的输入-输出文本对结构,成为探索超越传统逐词预测范式的关键实验平台。相关研究聚焦于突破大语言模型在创造性任务中的固有局限,如论文提出的多模态思维链与前瞻性解码策略,通过该数据集验证了动态跳步生成对文本多样性和逻辑连贯性的提升效果。当前热点涉及将此类方法应用于开放式对话系统和文学创作,其突破性在于解决了神经网络长期存在的路径依赖问题,为可控文本生成提供了新的理论框架。
以上内容由遇见数据集搜集并总结生成


