cota-mantis
收藏资源简介:
TACO数据集包含293K条由GPT-4o生成的合成思维链和行动链,涉及15种行动,如OCR、深度估计、计算器等。这些数据用于微调多模态语言模型,以生成思维链和行动链来回答复杂的视觉问题。数据集的生成过程包括使用GPT-4o和Python程序生成大量的合成思维链和行动链,并通过数据过滤和混合技术获得高质量的子集。数据集的来源包括Cauldron和Mantis-Instruct,这些数据集收集自COCO、AOKVQA、ScienceQA、Visual Genome等。数据集的用途是训练多模态语言模型,特别是用于复杂的多步骤和多模态任务。
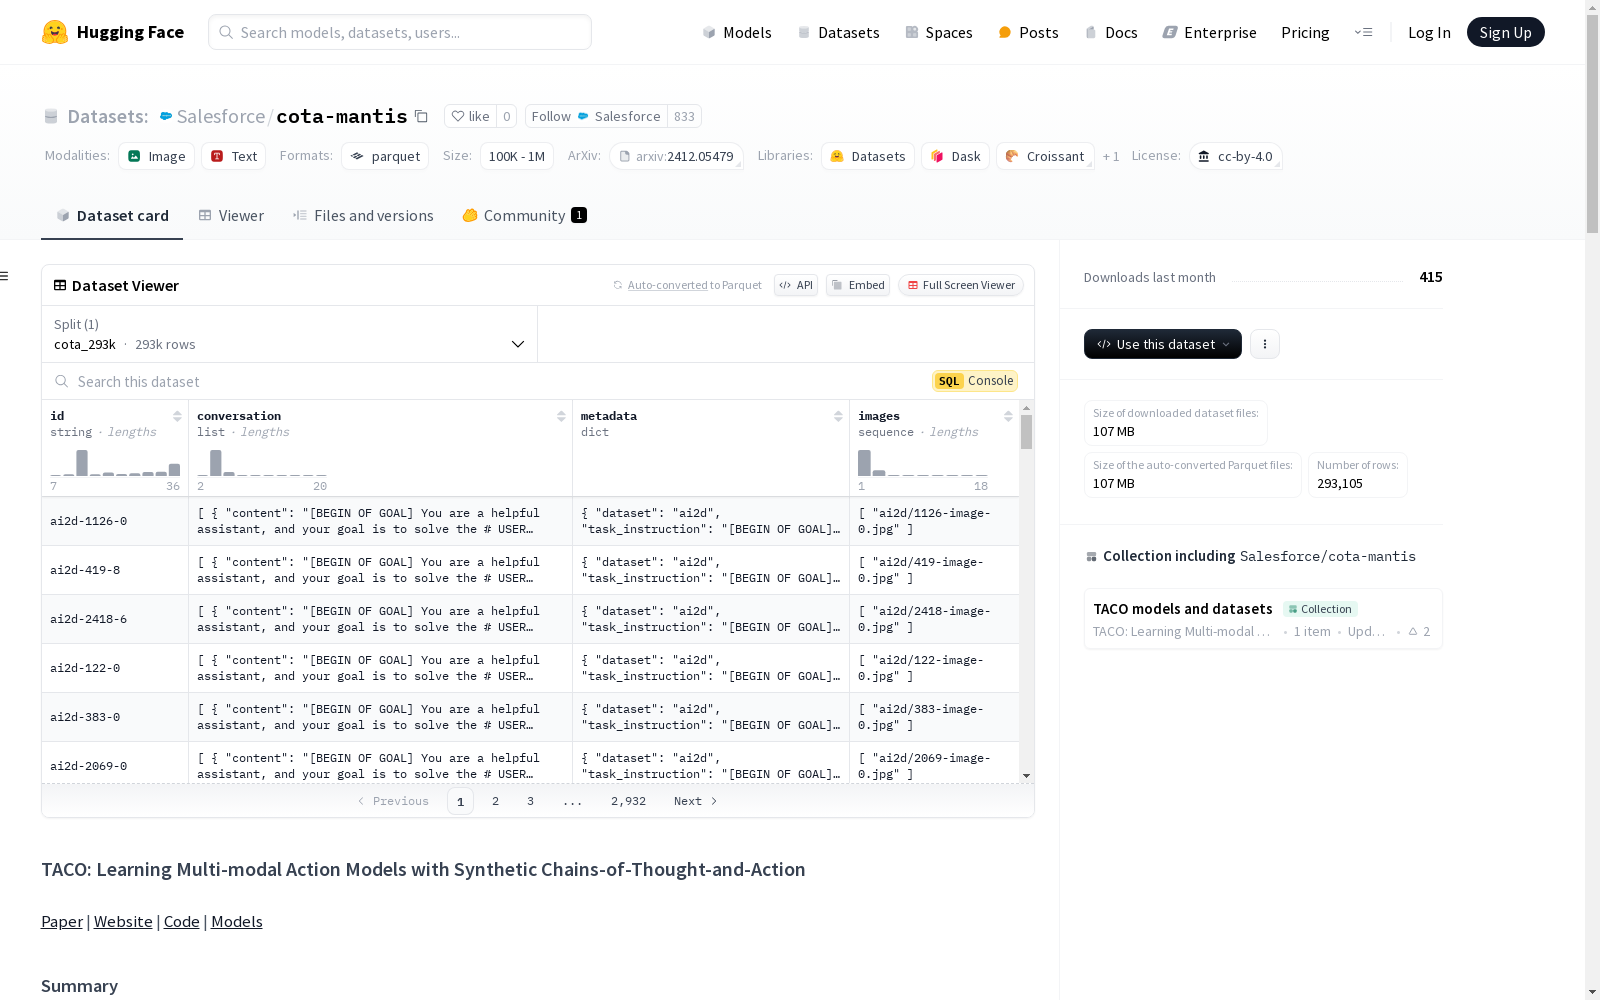
The TACO dataset contains 293K synthetic chain-of-thought and chain-of-action sequences generated by GPT-4o, covering 15 types of actions such as OCR, depth estimation, calculator invocation, and so on. These data are utilized to fine-tune multimodal large language models for generating chain-of-thought and chain-of-action sequences to answer complex visual questions. The dataset generation process involves using GPT-4o and Python programs to generate a large volume of synthetic chain-of-thought and chain-of-action sequences, and obtains high-quality subsets through data filtering and mixing techniques. The dataset sources include Cauldron and Mantis-Instruct, which are collected from COCO, AOKVQA, ScienceQA, Visual Genome, and other datasets. The primary purpose of this dataset is to train multimodal large language models, especially for complex multi-step and multimodal tasks.
数据集概述
数据集信息
- 许可证: CC BY 4.0
- 特征:
id: 字符串类型conversation: 列表类型,包含content(字符串类型)和role(字符串类型)metadata: 结构类型,包含dataset(字符串类型)和task_instruction(字符串类型)images: 序列类型,字符串
- 分割:
cota_293k: 包含 293105 个样本,占用 684640621 字节
- 下载大小: 107061603 字节
- 数据集大小: 684640621 字节
数据集详情
- 名称: CoTA 293K
- 描述: 该数据集包含 293K 个由 GPT-4o 生成的合成思维链和动作链(Chains-of-Thought-and-Action, CoTA)。
- 包含的动作: OCR, LocalizeObjects, GetObjects, EstimateRegionDepth, EstimateObjectDepth, Crop, ZoomIn, QueryLanguageModel, GetImageToImagesSimilarity, GetImageToTextsSimilarity, GetTextToImagesSimilarity, DetectFaces, QueryKnowledgeBase, Calculate, SolveMathEquation, Terminate
- 用途: 用于微调多模态语言模型,以生成思维链和动作链来回答复杂和困难的视觉问题。
- 数据来源: 来自 Cauldron 和 Mantis-Instruct,收集自 COCO, AOKVQA, ScienceQA, Visual Genome 等数据集。
数据集使用
- 直接使用: 可用于训练多模态语言模型,特别是使用 Mantis 代码库。
- 超出范围的使用: 不应用于测试模型。
数据集限制
- 偏见和风险: 思维链和动作链由 gpt-4o-2024-08-06 生成,因此继承了其偏见;动作主要集中在视觉工具和一些通用工具上。
引用
@misc{ma2024tacolearningmultimodalaction, title={TACO: Learning Multi-modal Action Models with Synthetic Chains-of-Thought-and-Action}, author={Zixian Ma and Jianguo Zhang and Zhiwei Liu and Jieyu Zhang and Juntao Tan and Manli Shu and Juan Carlos Niebles and Shelby Heinecke and Huan Wang and Caiming Xiong and Ranjay Krishna and Silvio Savarese}, year={2024}, eprint={2412.05479}, archivePrefix={arXiv}, primaryClass={cs.CV}, url={https://arxiv.org/abs/2412.05479}, }