遇见数据集

II-Bench

收藏
arXiv2024-06-11 更新2024-06-21 收录
官方服务:

资源简介:

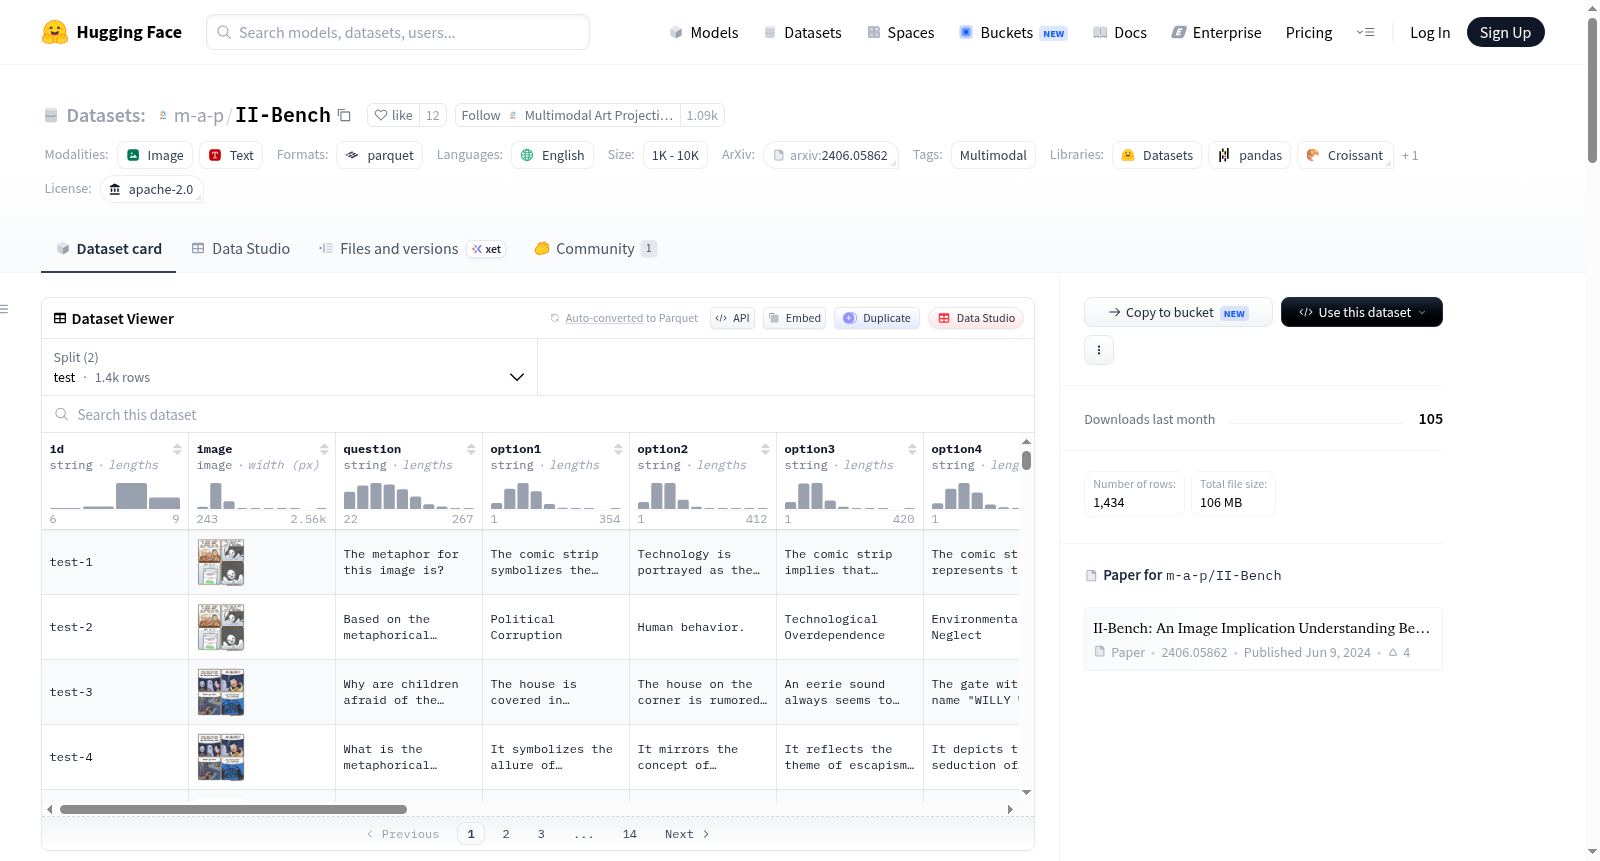
II-Bench是由深圳先进技术研究院和中国科学院联合创建的图像隐含理解基准数据集,旨在评估多模态大型语言模型(MLLMs)的高阶感知能力。该数据集包含1222张来自六个不同领域的图像,如生活、艺术、社会等,涵盖多种图像类型,包括插图、表情包、海报等。数据集的创建过程涉及从多个知名插图网站收集原始图像,并通过严格的数据筛选和标注流程,确保数据的质量和相关性。II-Bench的应用领域主要集中在评估和提升MLLMs在理解复杂图像隐含意义方面的能力,以推动人工智能向更高级的通用智能发展。

II-Bench is an image implicit understanding benchmark dataset jointly developed by the Shenzhen Institute of Advanced Technology and the Chinese Academy of Sciences, designed to evaluate the high-level perceptual capabilities of multimodal large language models (MLLMs). This dataset comprises 1,222 images spanning six distinct domains including daily life, art, and society, covering diverse image types such as illustrations, memes, posters, and more. The construction of II-Bench entails collecting raw images from multiple reputable illustration-related websites, followed by rigorous data filtering and annotation workflows to ensure the quality and relevance of the dataset. The primary application scope of II-Bench focuses on evaluating and enhancing the ability of MLLMs to comprehend the implicit semantics of complex images, thereby advancing the development of artificial intelligence toward more advanced general artificial intelligence (AGI).
创建时间:
2024-06-10
搜集汇总
数据集介绍
II-Bench 数据集图片
构建方式
在图像内涵理解这一高阶感知能力评估的空白领域,II-Bench应运而生。该数据集从多个知名插画网站收集了逾两万张原始图像,历经严格的三阶段筛选流程:首先利用图像相似度算法剔除重复内容,继而通过光学字符识别技术控制图文比例以确保视觉主导性,最后由人工进行视觉审查,剔除缺乏隐喻或暗示意味的图像,最终保留1222张高质量图像。来自不同学科背景的50名本科生依据精细标注协议,为每张图像标注难度、类型、领域及情感极性,并撰写人类解读说明,同时设计1至3道六选一的多选题,共计1434道题目,覆盖隐喻、象征等修辞手法。
特点
II-Bench的独到之处在于其聚焦于多模态大语言模型的高阶感知能力,而非浅层的图像识别或常识问答。数据集横跨生活、艺术、社会、心理、环境等六个领域,涵盖插画、表情包、海报、漫画、标志与绘画等多种图像类型,并依据人类理解划分为易、中、难三个难度层级。实验揭示,当前最先进模型在该基准上的最高准确率仅为74.8%,与人类平均90%的准确率存在显著鸿沟,尤其在艺术与心理等抽象领域表现欠佳。此外,模型对图像情感极性的理解存在明显不足,提示中加入情感信息可普遍提升其表现。
使用方法
II-Bench的使用旨在系统评估多模态大语言模型的图像内涵理解能力。研究者可直接采用零样本设置,向模型输入图像与六选一问题,通过提取模型输出的选项字母计算准确率。为深入剖析模型能力,数据集支持多种提示策略,包括提供图像领域、情感极性或修辞手法等元信息作为关键词,以及采用思维链提示引导模型逐步推理。此外,数据集内置了少量样本的开发集与验证集,可供少样本学习场景使用。评估时需注意,若模型输出无法匹配预定义的选项格式,则视为回答错误,这要求模型具备良好的指令遵循能力。
背景与挑战
背景概述
多模态大语言模型(MLLMs)在图像描述、视觉问答等任务中取得了显著进展,然而,现有基准测试多聚焦于基础感知与知识推理,对模型高阶感知能力——如隐喻理解、情感洞察与深层语义挖掘——的评估仍属空白。为填补这一空缺,中国科学院深圳先进技术研究院联合多所高校及机构于2024年提出了图像意蕴理解基准II-Bench。该基准由50名跨学科本科生精心构建,涵盖1,222幅图像与1,434道多选题,横跨生活、艺术、社会、心理、环境六大领域,旨在系统性评估MLLMs对图像隐含意义的理解能力。实验揭示,当前最优模型准确率仅达74.8%,而人类平均准确率为90%,峰值高达98%,凸显了机器与人类在高阶感知层面的显著鸿沟。II-Bench的发布为多模态人工智能向专家级通用智能迈进提供了关键评估工具。
当前挑战
II-Bench所面临的挑战兼具领域深度与构建难度。在领域层面,模型需突破对图像表面内容的理解,深入解析抽象艺术与心理学等复杂领域的隐喻、象征与情感极性,当前模型在抽象与高逻辑性图像上表现欠佳,且对负面情绪的感知远逊于人类,暴露出高阶语义理解与情感推理能力的不足。在构建过程中,团队从逾两万张原始图像中历经三重筛选——包括基于相似度算法的去重、光学字符识别控制文本占比,以及人工剔除缺乏隐喻价值的图像,最终仅保留不足两千张高质量样本,筛选率超过90%。此外,每张图像需由标注员设计1至3道包含一个正确答案与五个干扰项的精细题目,并标注修辞手法与情感倾向,确保数据质量与评估严谨性。这些挑战共同构成了对MLLMs高阶感知能力的严峻考验。
常用场景
经典使用场景
在多媒体大语言模型(MLLMs)蓬勃发展的浪潮中,II-Bench作为首个聚焦图像意涵理解的基准,开创性地评估模型对抽象与复杂图像的高阶感知能力。其经典应用场景为衡量MLLMs在隐喻、象征及情感深度上的推理水平,通过涵盖生活、艺术、社会等六大领域的1222幅图像,揭示模型在理解视觉细节与深层语义间的鸿沟。
解决学术问题
II-Bench填补了现有基准对MLLMs高阶感知能力探索的空白,系统解决了模型在图像隐喻理解、情感极性识别及多跳推理中的缺陷。研究发现,当前顶尖模型准确率(74.8%)远低于人类均值(90%),尤其在艺术与心理学领域表现薄弱,凸显了高阶语义理解与细节捕捉的瓶颈,为下一代专家级通用人工智能(AGI)的研发提供了关键评测方向。
衍生相关工作
II-Bench的提出催生了多项相关研究,包括对模型错误类型的系统分类(如隐喻误解、细节忽略),以及提示策略的优化探索(如情感极性提示显著提升准确率)。此外,其数据筛选与标注流程为构建高阶感知基准树立了范式,激发了诸如多模态推理增强、情感理解模块集成等后续工作,推动了MLLMs在抽象语义理解领域的迭代进化。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务