遇见数据集

xpertsystems/oil022-sample

收藏
Hugging Face2026-05-22 更新2026-05-31 收录
官方服务:

资源简介:

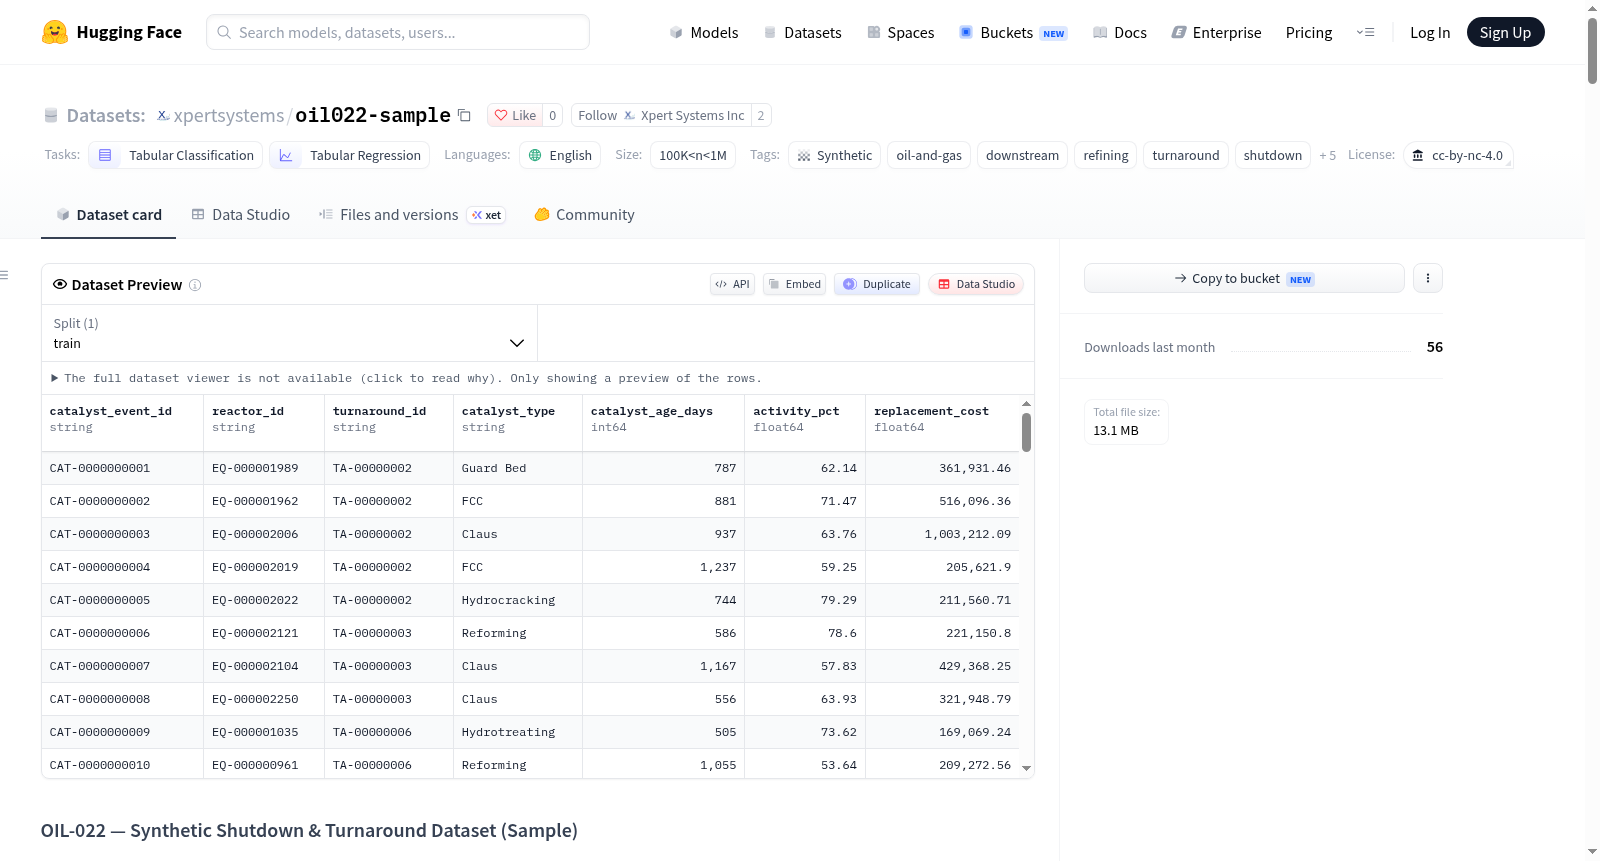
OIL-022是一个合成停机与周转数据集(样本),属于石油天然气下游精炼行业,专注于维护规划、检查优化和周转操作。该数据集是XpertSystems.ai企业级精炼厂停机与周转数据集的免费预览版,用于维护规划机器学习、检查优化、进度延误预测、重启准备评估、周转成本预测和基于风险的检查(RBI)分析。样本覆盖10个全球区域的15个精炼厂,包含2,250台设备和1,200个周转活动,共165,114行数据,分布在15个表格中。数据生成基于行业标准(如API 510、API 570、API 580/581、NACE TM0274、OSHA 1910.119等),并通过10个指标校准验证,确保数据真实性和行业相关性。数据集支持多种机器学习用例,包括API 510剩余寿命回归、可靠性等级分类、进度延误回归等。

OIL-022 is a synthetic shutdown and turnaround dataset (sample) for the oil and gas downstream refining sector, focusing on maintenance planning, inspection optimization, and turnaround operations. It is a free, schema-identical preview of XpertSystems.ais enterprise refinery shutdown and turnaround dataset for maintenance planning ML, inspection optimization, schedule slippage prediction, restart readiness assessment, turnaround cost forecasting, and RBI analytics. The sample covers 1,200 turnaround campaigns across 15 refineries with 2,250 pieces of equipment in 10 global regions, with 165,114 rows linked across 15 tables. Data generation is anchored to industry standards (e.g., API 510, API 570, API 580/581, NACE TM0274, OSHA 1910.119) and validated via a 10-metric scorecard for realism and industry alignment. The dataset supports various ML use cases, including API 510 remaining life regression, reliability grade classification, schedule slippage regression, and more.
提供机构:
xpertsystems
搜集汇总
数据集介绍
xpertsystems/oil022-sample 数据集图片
构建方式
在炼油行业停工检修(Turnaround)与基于风险的检验(RBI)分析领域,构建一个兼具工业标准锚定与机器学习可用性的合成数据集,需以权威规范为生成依据。OIL-022样本数据集以API 510、API 570、API 580/581、NACE TM0274、OSHA 1910.119 PSM及CCPS指南等标准为校准基准,通过确定性随机种子驱动生成过程,合成15座炼厂、2250台设备与1200次检修活动的关联数据,涵盖腐蚀监测、工单执行、检验发现、进度排程、人员配置、作业许可、设备失效、催化剂更换、启动就绪、成本核算及安全事件等15张可连接数据表,并利用十项行业指标评分卡对生成结果进行验证,确保各维度统计特征与真实工业基准高度吻合。
特点
该数据集的核心特征在于其标签与特征之间的强耦合性,区别于纯随机标签的合成数据。可靠性评分由进度偏差、高风险检验发现与完工率共同决定,腐蚀剩余寿命则依据壁厚与腐蚀速率的物理公式推导,样本中腐蚀速率与剩余寿命的皮尔逊相关系数约为-0.55,进度偏差与可靠性评分相关系数约为-0.64,均验证了API 510 RBI物理机制的有效性。数据规模达到165114行,覆盖10个全球区域、14类设备、5种停工类型与7类作业许可,并附带明确的不确定性披露说明,为模型学习提供了真实可辨的信号结构。
使用方法
研究者可通过Hugging Face datasets库或pandas直接加载各CSV文件,利用turnaround_id、equipment_id、refinery_id与work_order_id等键值实现多表关联,构建面向检修规划的特征工程流程。典型应用涵盖API 510剩余寿命回归、可靠性等级四分类、进度偏差回归、异常评分回归、重启成功二分类、成本超支预测、作业许可危险等级分类、检修成本回归及安全事件分类等任务。数据集支持基于种子的确定性复现,并建议在多表关系学习场景中结合图神经网络或实体解析方法,以充分挖掘跨表关联信息。对于类别不平衡的安全事件分析,需审慎评估样本量并考虑与完整产品或其他SKU数据合并使用。
背景与挑战
背景概述
炼油下游装置的停工检修(Turnaround)是流程工业中高风险、高成本且高度复杂的周期性活动,其规划质量直接关系到设备完整性、重启安全与经济效益。长期以来,该领域缺乏公开、标准化且与行业规范深度耦合的数据资源,制约了维护规划、检验优化与进度风险预测等机器学习研究的发展。XpertSystems.ai于2026年发布的OIL-022合成数据集,作为下游炼油三部曲中专注于维护、检验与大修运营的SKU,覆盖15座炼厂、1200次检修活动与2250台设备,包含16.5万余行跨15张关系表的数据,并以API 510、API 570、API 580/581、OSHA 1910.119 PSM及CCPS等权威标准为校准锚点,为风险检验(RBI)与检修决策智能提供了可复现、高保真的研究基座。
当前挑战
该数据集所面向的领域挑战,在于炼油检修规划固有的多源异构性、强不确定性以及安全与成本的本质张力——检修工期、腐蚀剩余寿命、重启就绪度与承包商资源配置相互耦合,传统经验驱动方法难以在动态风险场中实现最优决策。在构建层面,挑战同样显著:合成数据须在统计特征上忠实复现真实炼厂的复杂分布,同时避免标签与特征间的退化性关联;腐蚀-剩余寿命、进度偏差-可靠性等级等物理与业务耦合关系需通过公式化生成机制显式编码,并接受皮尔逊相关等定量验证;此外,样本规模对稀疏安全事件、临界性-失效耦合等统计信号的支撑有限,需在诚实披露局限的前提下,通过大规模产品版本或跨SKU数据融合加以缓解。
常用场景
经典使用场景
在炼油行业下游维护规划领域,该数据集最为经典的应用场景在于支持基于风险的检验(RBI)分析与停工检修排程优化。研究者可依托inspection_findings表中的壁厚、腐蚀速率与剩余寿命字段,结合API 580/581标准,构建监督学习模型以预测设备退化趋势;亦可利用turnaround_schedule表中的关键路径任务、计划工时与进度风险评分,训练回归模型以量化检修工期滑移概率。多表关联结构进一步支持跨实体特征工程,例如将停工类型、设备关键性等级与承包商分配信息融入统一学习框架,用于检修准备度评估与启动成功率预测,从而在计划阶段即识别高风险环节并优化资源配置。
衍生相关工作
围绕该数据集,已衍生出若干具有代表性的后续工作。一方面,研究者基于其特征耦合标签构建了API 510剩余寿命回归基线、四类可靠性分级序数分类器及检修成本回归模型,并探索了多表图神经网络在实体解析与跨表特征聚合中的应用。另一方面,该样本与同系列OIL-019、OIL-020及OIL-021形成下游炼油数据生态,催生了跨稳态运行与瞬态检修的统一维护决策框架、基于RBI的检验计划强化学习策略以及检修-启动全流程数字孪生仿真等延伸研究,为炼油资产管理领域提供了可扩展的研究基座。
数据集最近研究
最新研究方向
在炼油下游领域,基于风险的检验(RBI)与停工检修(Turnaround)的智能化决策正成为研究热点。OIL-022数据集凭借其严格遵循API 510/570/580/581、OSHA PSM及CCPS等工业标准的高保真合成数据,为设备剩余寿命回归、可靠性等级分类、进度延误预测及重启就绪评估等前沿任务提供了物理耦合的基准。其多表关联结构支持图神经网络与实体解析,推动了维护规划从经验驱动向数据驱动的范式转变,对提升炼厂运营安全性与经济性具有深远影响。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务