遇见数据集

xpertsystems/enr004-sample

收藏
Hugging Face2026-05-25 更新2026-05-31 收录
官方服务:

资源简介:

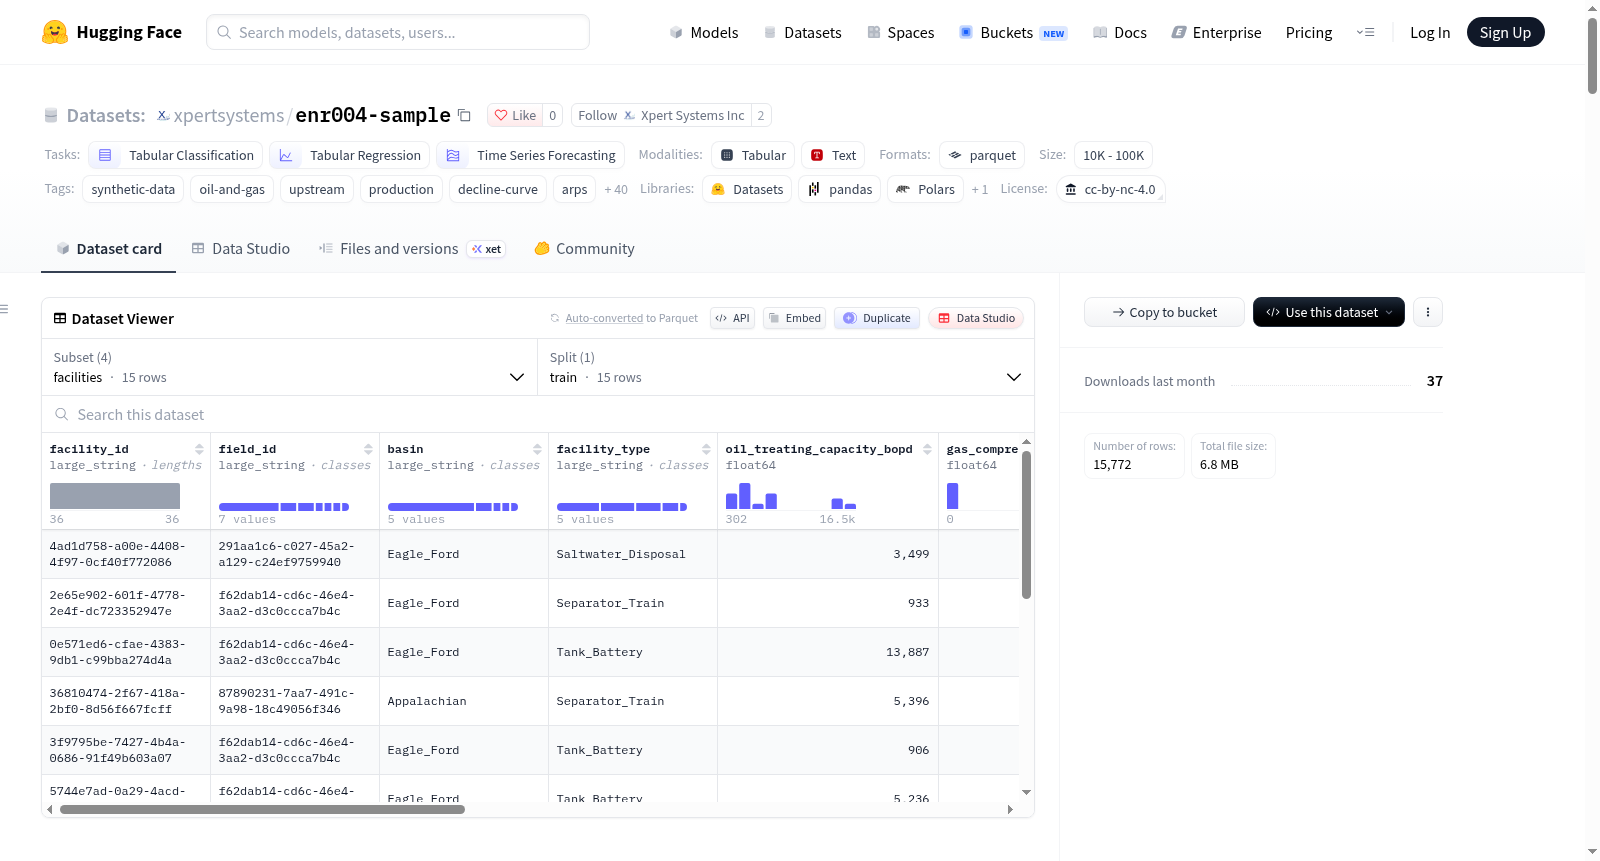
ENR004是一个合成上游石油和天然气生产数据集(样本预览),包含四个物理校准的表:生产数据、井元数据、油田元数据和设施数据。数据集覆盖美国五个盆地(二叠纪、鹰福特、巴肯、阿巴拉契亚/马塞勒斯、墨西哥湾海上),提供日分辨率的井级生产时间序列数据,集成Arps递减曲线物理、Standing(1947)和Vasquez-Beggs(1980)PVT相关性、Ornstein-Uhlenbeck商品价格以及EPA Subpart W甲烷强度。校准优先参考SPE石油资源管理系统、API生产报告、EPA Subpart W和EIA钻井生产力报告等行业标准。样本包含50口井、8个油田、2年日数据(约15,699条生产记录),适用于类型曲线/EUR预测、生产速率预测、井经济学ML、储层压力下降建模、GOR/WOR进展建模、ESP/抽油杆泵异常检测、甲烷排放强度基准测试、盆地分类、举升类型选择、商品价格压力测试、封堵和废弃预测以及多表关系ML等用例。

ENR004 is a synthetic upstream oil and gas production dataset (sample preview) comprising four physics-calibrated tables: production data, wells metadata, fields metadata, and facilities data. It spans 5 US basins (Permian, Eagle Ford, Bakken, Appalachian/Marcellus, GOM Offshore) with daily-resolution well-level production timeseries, incorporating Arps decline curve physics, Standing (1947) and Vasquez-Beggs (1980) PVT correlations, Ornstein-Uhlenbeck commodity prices, and EPA Subpart W methane intensity. Calibration is benchmark-first against SPE Petroleum Resources Management System, API production reporting, EPA Subpart W, and EIA Drilling Productivity Reports. The sample includes 50 wells, 8 fields, 2 years of daily data (~15,699 production records), and supports use cases such as type curve/EUR forecasting, production rate forecasting, well economics ML, reservoir pressure decline modeling, GOR/WOR progression modeling, ESP/rod pump anomaly detection, methane emissions intensity benchmarking, basin classification, lift type selection, commodity price stress testing, plug-and-abandon prediction, and multi-table relational ML.
提供机构:
xpertsystems
搜集汇总
数据集介绍
xpertsystems/enr004-sample 数据集图片
构建方式
该数据集立足于油气上游工程与数据科学的交叉领域,采用物理校准的合成数据生成范式,以Arps递减曲线方程、Standing与Vasquez-Beggs的PVT关联式以及Ornstein-Uhlenbeck均值回归价格过程为底层机制,按照SPE PRMS储量分类标准、API产量报告规范、EPA Subpart W甲烷排放核算方法及EIA钻探生产率报告等权威行业基准进行结构性验证,涵盖二叠纪、鹰滩、巴肯、阿巴拉契亚/马塞勒斯和墨西哥湾海上等五大美国盆地的井级日度生产时序,形成生产、井、油田和地面设施四表联动的数据架构。
特点
该数据集展现出多维度、高保真与强关联的鲜明特质。其以约一万五千条日度生产记录为核心,完整刻画油、气、水产量及气油比、含水率、井底压力、人工举升参数、经济指标与甲烷排放强度等三十六项变量,并辅以井元数据中的递减参数、EUR与权益结构、油田元数据中的储层物性与驱动类型、设施元数据中的处理能力与运行状态,四表通过field_id实现关系型联结。所有指标均通过十个校准维度的结构性检验,在六个标准随机种子下获得A+级验证评分,兼具合成数据的可复现性与行业物理规律的真实性。
使用方法
研究人员可借助HuggingFace datasets库的load_dataset接口直接加载生产配置表,或通过huggingface_hub下载Parquet格式的四张数据表进行联合分析。典型应用涵盖基于IP30/IP90与完井参数的递减曲线参数估计与EUR预测、多步时序产量预测、井 economics 机器学习建模、储层压力衰竭模拟、气油比与水油比演化分类、人工举升设备异常检测、甲烷排放强度基准测试以及盆地分类与举升方式选择等任务。建议在进行递减曲线建模时将日度数据聚合至月度频率,以契合行业标准分析节奏;对于价格敏感性回测,应结合well_status与production_date字段审慎构建日度连续序列。
背景与挑战
背景概述
上游油气生产数据的稀缺性与保密性长期制约着油气工程与能源经济领域的机器学习研究。2026年,XpertSystems.ai发布ENR004合成上游油气生产数据集,覆盖Permian、Eagle Ford、Bakken、Appalachian/Marcellus及墨西哥湾深水五大盆地,以物理校准方式融合Arps递减曲线、Standing与Vasquez-Beggs PVT关联式、Ornstein-Uhlenbeck商品价格及EPA Subpart W甲烷强度,并依据SPE PRMS、API生产报告与EIA钻井生产率报告进行基准验证。该数据集为递减曲线分析、EUR预测、井 economics 建模及甲烷排放基准测试提供了高保真、可复现的开放基准,对推动能源数据科学与油气工程交叉研究具有显著影响力。
当前挑战
该数据集所面对的领域挑战在于,真实上游生产数据受商业机密与监管限制而难以获取,现有公开数据多呈粗粒度或静态,无法支撑井级日度时序建模与多表关系学习。构建层面的挑战亦十分突出:需在合成过程中同时满足质量平衡、压力结构约束、Arps递减物理一致性及经济恒等式,并协调多盆地地质非均质性、人工举升动态、商品价格均值回归与排放强度校准。样本版本进一步面临日度递减曲线信噪比低、关井事件非均匀采样、GOR演化未覆盖气泡点以下行为、设施与井缺乏一一映射等局限,对模型的鲁棒性与泛化能力构成实质性考验。
常用场景
经典使用场景
在油气上游生产分析与油藏工程领域,递减曲线分析与单井最终可采储量评估构成核心工作流。ENR004数据集凭借其每日分辨率的生产时间序列、Arps递减物理参数以及完井特征,为训练递减参数估计器与EUR预测模型提供了理想的基准。研究者可基于IP30/IP90早期产量与水平段长度、压裂级数等变量,构建从早期生产数据推断递减类型、初始递减率及双曲递减因子的机器学习模型,进而外推单井最终可采储量,并借助SPE PRMS标准验证经济极限与储量分类的合理性。
实际应用
在油气公司实际运营中,该数据集可服务于井 economics 机器学习建模、盈亏平衡价格预测以及人工举升设备异常检测。工程师能够利用ESP频率、杆泵充满度等参数构建无监督异常检测模型,提前预警井下设备故障;经济分析师则可结合WTI与Henry Hub价格路径、权利金率及净收入权益,回归净现金流并开展商品价格压力测试。此外,甲烷排放强度基准建模亦可用于EPA Subpart W报告的方法学增强,辅助环境合规与减排策略制定。
衍生相关工作
围绕该数据集已衍生出多项经典工作方向,包括基于多表关联的产量预测与递减参数反演、利用Ornstein-Uhlenbeck价格过程进行经济敏感性分析、以及基于生存模型的关井与废弃时间预测。其配套的ENR系列数据集进一步将上游生产与发电、电网调度及电力需求衔接,形成完整能源价值链机器学习工作流。在油藏工程方向,OIL系列 subsurface 数据集亦与之互补,共同支撑从地震、测井到生产动态的一体化研究。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务