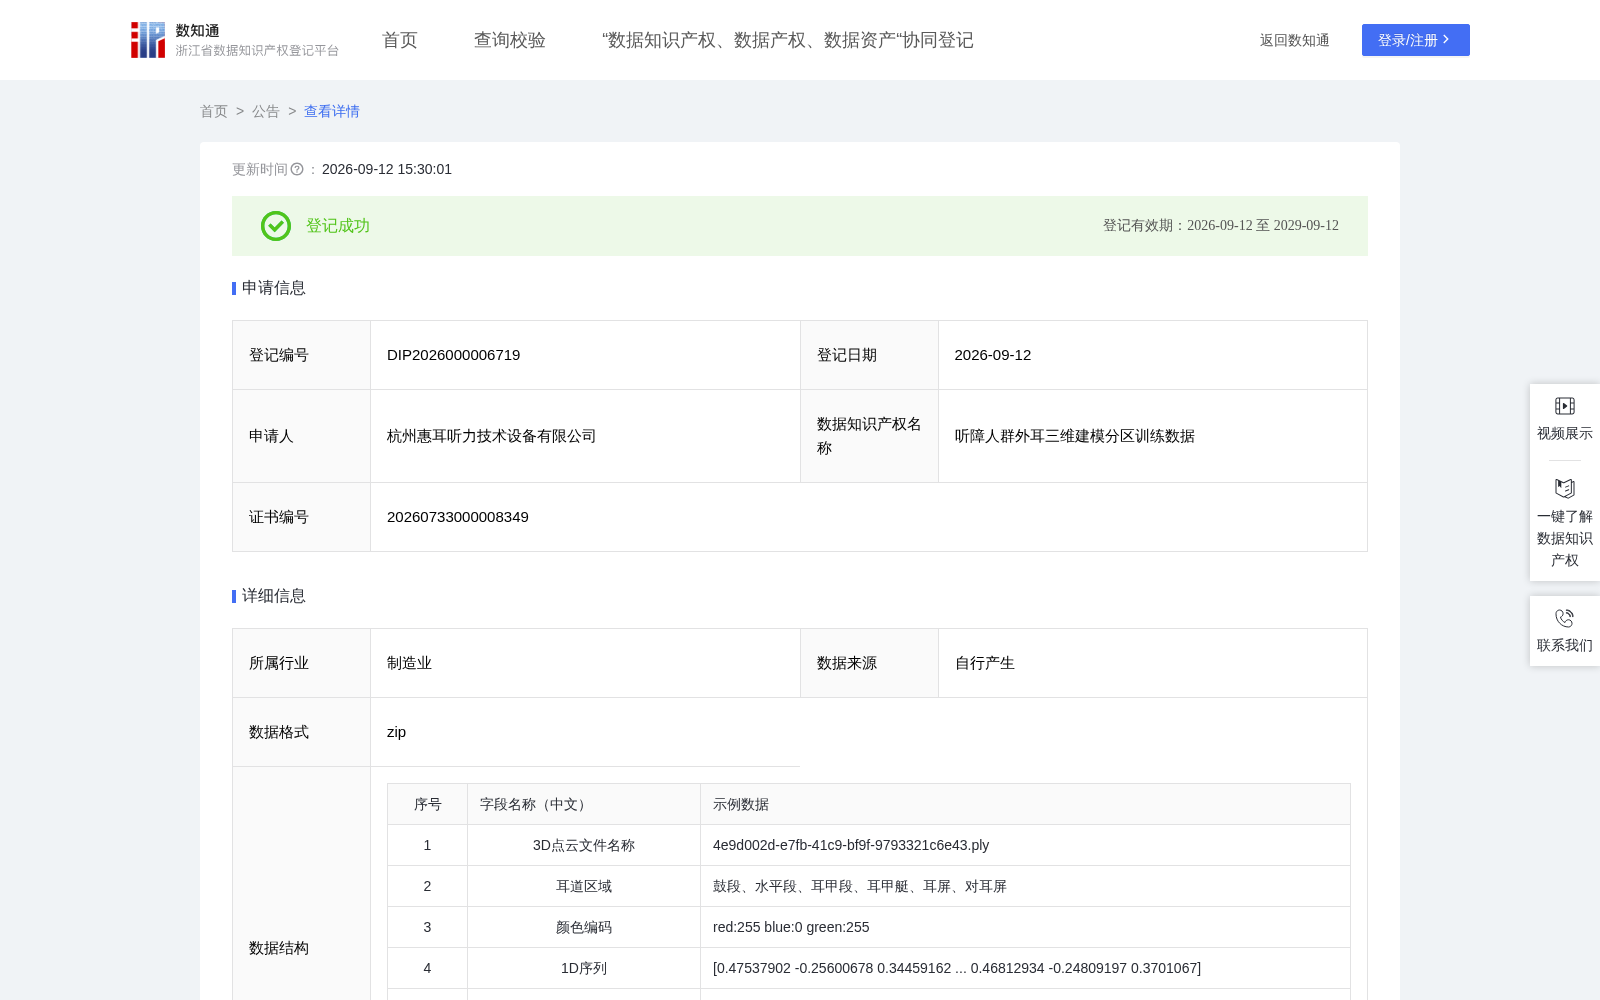
听障人群外耳三维建模分区训练数据
收藏资源简介:
本数据集通过将扫描采集的外耳三维建模原始数据与AI算法相结合,实现对外耳及耳道进行精准区域分割(包括鼓段、水平段、耳甲段、耳甲艇、耳屏、对耳屏等部位),并对同一区域进行标记,通过颜色编码的形式保存在数据集中。利用数据集中的分割信息可以对不同听障人士的外耳及耳道形状进行快速准确的定位,为后续不同外观大小、佩戴深度的助听器(如耳内式ITE、耳甲腔式ITC、完全耳道式CIC等)进行贴合度与声学特性仿真所使用的神经网络精准投喂训练数据,有效避免冗余数据造成的训练幻觉,加快收敛速度。同时,数据集支持快速计算出耳道容积、耳道投影面积等数据,为后续助听器数字孪生物理引擎研发提供了有力的数据支撑。一、加工前的数据说明 采用专业耳道3D扫描设备对用户耳道进行精准扫描,采集用户原始3D耳道影像数据。 二、处理规则 针对外耳三维建模数据,采用U-Net编码器-解码器结构,通过序列化编码将无序3D点云转化为有序1D序列,使用标准Transformer架构的神经网络进行特征学习,实现3D智能分割。 (一)编码器设计 编码器分5个阶段,每个阶段包含下采样层和多个Transformer块。下采样层利用序列化编码将邻近点分组并池化,点数逐级减半,通道数逐级翻倍。Transformer每个块包含条件位置编码,层归一化,多头自注意力,MLP(多层感知机),残差连接。每个块交替使用不同的排序策略(z-order、z-trans等),使模型从多方向捕捉空间结构。 (二)解码器设计 解码器分4个阶段,每个阶段包含上采样层和多个Transformer 块,利用编码器保存的逆映射信息将特征映射回高分辨率,并与编码器对应层跳跃连接融合,点数逐级恢复,通道数逐级减半。Transformer块结构与编码器的相同,进行特征精炼。分割头将解码器输出的特征映射为每个点的类别,完成逐点语义分割。 (三)模型训练 使用Diceloss作为损失函数,优化算法选择Adam,学习率设置为0.0001。将数据集划分为训练集、验证集和测试集,比例为7:2:1。使用训练集对神经网络进行训练,设置训练轮数为1000轮,批次大小为16。在训练过程中,实时监控验证集的损失,当验证集损失连续10轮没有下降时,提前停止训练,防止过拟合。对模型进行超参数调整,尝试不同的隐藏层节点数、学习率和批次大小等参数,找到最佳的模型性能。 三、数据内容描述 最终形成的数据集合包含以下内容:3D点云文件、文件名称、耳道区域、颜色编码、1D序列、损失函数、优化算法、学习率、训练轮数、批次大小、损失值、超参数调整策略等。 本数据集可用于精准定位、分割不同听障人士的外耳及耳道,后续还可用于相关神经网络模型的训练,未来可用于为助听器数字孪生物理引擎研发提供数据支撑。