遇见数据集

mm-eval/VisIT-Bench

收藏
Hugging Face2026-05-26 更新2026-05-31 收录
官方服务:

资源简介:

--- dataset_info: features: - name: id dtype: string - name: media list: image - name: messages dtype: string splits: - name: test num_bytes: 160967071 num_examples: 578 download_size: 160815617 dataset_size: 160967071 configs: - config_name: default data_files: - split: test path: data/test-* ---

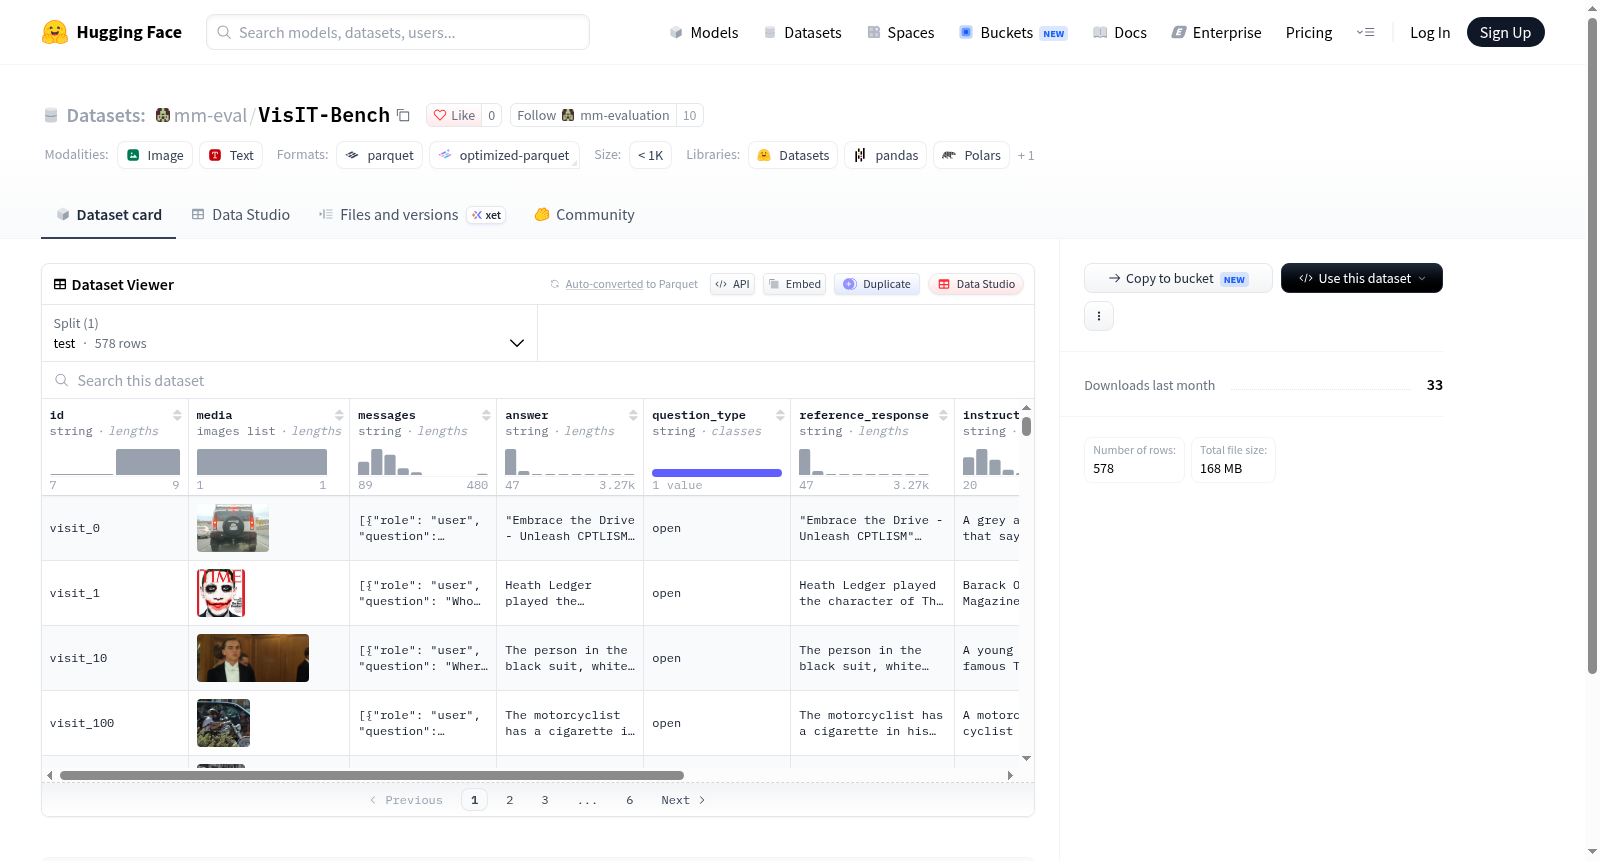
This dataset is a multimodal dataset containing images and text messages, primarily intended for testing purposes. It includes 578 examples, each consisting of a unique ID, a list of images (media), and a string message (messages). The data is provided in a test split format, with a total size of approximately 161MB and a similar download size. The dataset does not specify application scenarios or sources, but its structure suggests potential use in image-text interaction tasks, such as dialogue systems or visual question answering.
提供机构:
mm-eval
搜集汇总
数据集介绍
mm-eval/VisIT-Bench 数据集图片
构建方式
在视觉语言模型评测领域,VisIT-Bench的构建遵循严格的指令遵循评估范式,旨在精准衡量模型对复杂视觉指令的理解与响应能力。该数据集汇集了578个测试样本,每个样本包含图像媒体、用户消息、问题类型、参考答案以及指令条件下的描述性文本,通过人工标注与自动化流程相结合的方式,确保指令的多样性和语义丰富度,覆盖多种视觉问答场景,从而为模型提供全面的指令遵循挑战。
特点
VisIT-Bench展现出鲜明的指令导向特性,其数据组织以消息和答案为核心,辅以问题类型、指令类别和参考响应等多维元数据,支持细粒度的性能分析。数据集图像内容广泛,指令形式灵活,涵盖开放式生成与封闭式选择,能够有效区分模型在指令理解、视觉推理和语言生成方面的差异。此外,该数据集规模适中,便于快速评测且不牺牲评测深度,为研究提供了高质量的基准资源。
使用方法
使用VisIT-Bench时,研究者可通过HuggingFace平台加载测试分割,利用提供的图像、消息和指令条件字段构造模型输入,并参照答案或参考响应进行自动或人工评估。该数据集适用于零样本或少样本评测,支持对视觉语言模型的指令遵循能力进行量化比较。通过分析模型输出与参考答案的匹配程度,可系统评估模型在多样化视觉指令下的表现,推动指令调优与多模态理解的协同发展。
背景与挑战
背景概述
视觉语言模型(Vision-Language Models, VLMs)的评估长期依赖静态基准,难以反映真实世界指令的多样性与复杂性。2023年,来自加州大学洛杉矶分校、华盛顿大学等机构的研究者联合发布了VisIT-Bench,旨在系统评估VLMs对开放式视觉指令的遵循能力。该基准包含578个测试样本,涵盖多种问题类型与指令条件,并引入指令条件化描述作为参考。其核心研究问题在于:模型能否在无需微调的情况下,准确理解并执行结合图像与文本的复杂指令。VisIT-Bench的推出推动了多模态评估从封闭问答向开放式指令遵循的范式转变,为后续研究提供了关键诊断工具。
当前挑战
VisIT-Bench所应对的领域问题在于,现有视觉语言评估基准多局限于分类或固定答案的问答,无法衡量模型对灵活、多义指令的遵循程度。构建过程中,研究者需克服指令多样性匮乏、参考答案难以标准化、图像与文本组合的语义对齐等难题。具体而言,挑战包括:设计覆盖广泛语义的指令类别,确保每个样本的视觉内容与指令逻辑一致,以及建立可靠的自动评估指标以处理开放式回答。此外,数据集需避免偏见并保持规模适中,以平衡评估成本与代表性。这些挑战共同凸显了开放式视觉指令评估的固有复杂性。
常用场景
经典使用场景
VisIT-Bench作为一个多模态指令遵循基准数据集,其经典使用场景在于评估视觉语言模型对图文交错指令的理解与执行能力。研究者通常将模型置于零样本或少样本设定下,要求其根据给定的图像与自然语言指令生成恰当的回答,进而通过人工或自动指标衡量模型在指令遵循、视觉推理及内容生成方面的综合表现。该数据集涵盖多样化的指令类别,为模型能力的细粒度分析提供了标准化测试平台。
解决学术问题
该数据集有效缓解了视觉语言模型中指令遵循能力评估资源匮乏的问题,弥补了现有基准在指令多样性、任务复杂度和评价维度上的不足。它使得研究者能够系统探究模型在跨模态指令理解、上下文推理及生成一致性等方面的表现,为揭示模型的能力边界与失效模式提供了实证基础,推动了多模态指令微调与对齐研究的规范化发展。
衍生相关工作
围绕VisIT-Bench,研究者开展了多项衍生工作,包括基于该基准的模型能力对比分析、指令微调策略探索以及自动化评估方法的改进。部分工作进一步扩展了指令类别与图像领域,构建了更具挑战性的多模态评测变体,亦有研究利用其参考回答与指令条件描述来训练奖励模型或进行偏好对齐,推动了多模态大模型评估体系的持续演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务