遇见数据集

Ryoo72/MMBench-EN-Dev-V10

收藏
Hugging Face2026-05-26 更新2026-05-31 收录
官方服务:

资源简介:

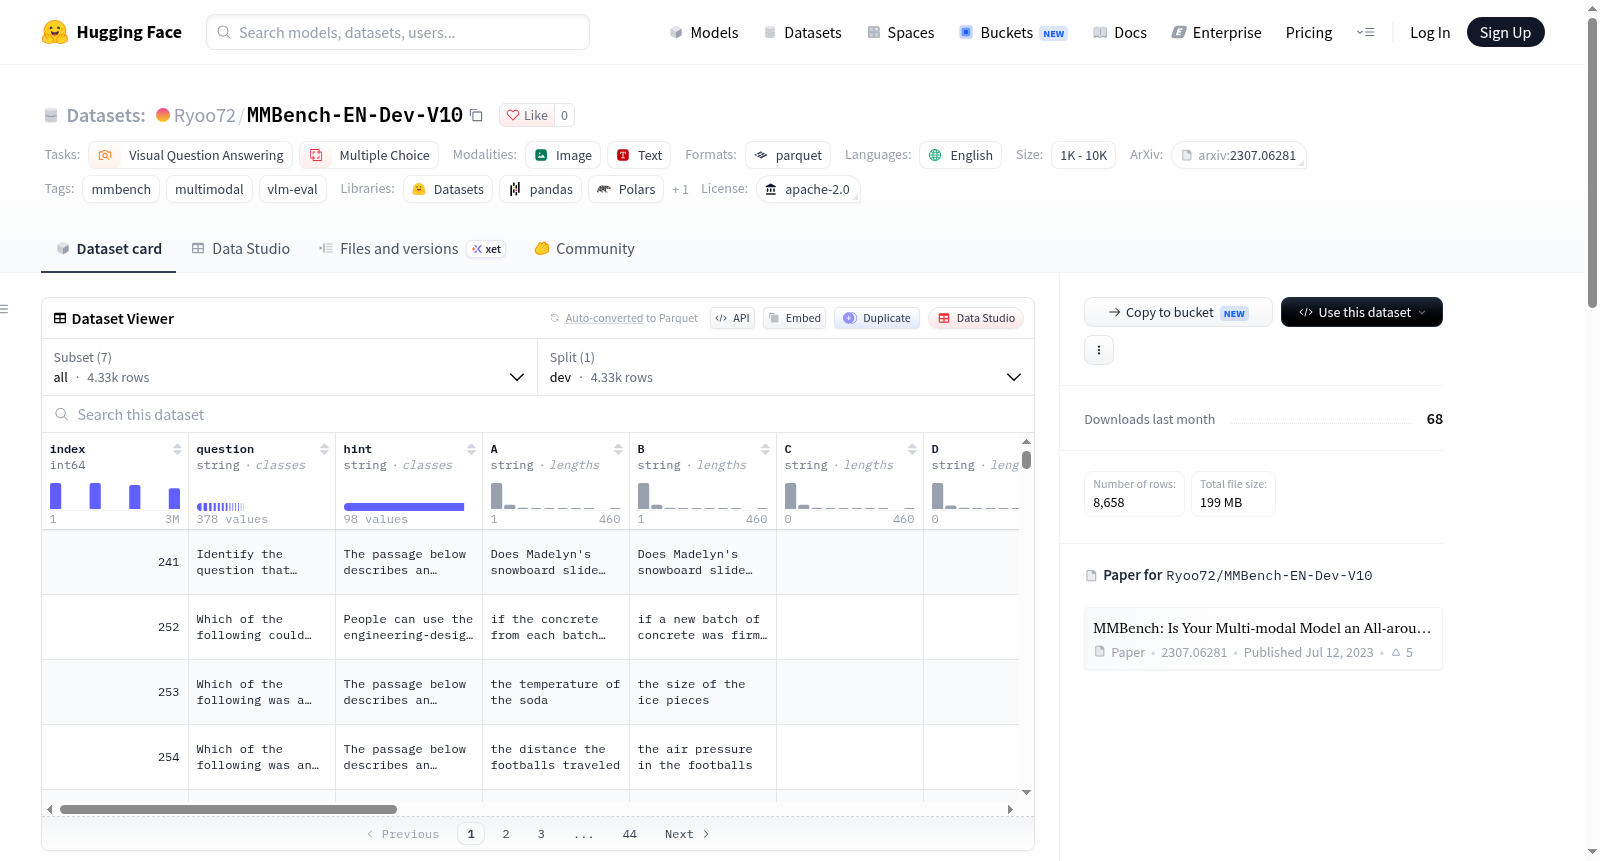
MMBench EN Dev V1.0 是一个多模态视觉问答评估数据集,专门用于测试和基准化多模态模型在多种感知和推理任务上的性能。该数据集基于原始MMBench开发集的英文版本(MMBench_DEV_EN.tsv),并按照L2类别字段预分割为6个子集,以方便在数据集查看器中浏览。数据集包含4,329个样本,每个样本包括问题、提示、四个选项(A、B、C、D)、答案、类别标签(L3细粒度类别,共20类)、图像(以PIL格式存储)、L2类别标签(6类)、分割信息、来源和注释。子集涵盖粗粒度感知、细粒度感知(单实例和跨实例)、属性推理、关系推理和逻辑推理等任务。数据格式经过解析,确保每行都包含其自身的解码图像,避免了原始TSV文件中的引用问题。该数据集适用于视觉语言模型的评估和比较,支持通过Hugging Face的datasets库加载使用。

The MMBench-EN-Dev-V1.0 dev split, pre-split into 6 subsets by the original l2-category field for convenient browsing in the dataset viewer. It is a multimodal visual question answering evaluation dataset designed for benchmarking multimodal models across various perception and reasoning tasks. The dataset is derived from the official OpenCompass TSV file (MMBench_DEV_EN.tsv) and contains 4,329 rows. Each row includes question, hint, options (A, B, C, D), answer, category (L3, 20 fine-grained classes), image (in PIL format), l2-category (L2, 6 classes), split, source, and comment. The subsets cover coarse perception, fine-grained perception (single-instance and cross-instance), attribute reasoning, relation reasoning, and logic reasoning. The format resolves references from the original compressed CircularEval format, ensuring each row carries its own decoded image. It is intended for evaluating and comparing vision-language models and can be loaded via the Hugging Face datasets library.
提供机构:
Ryoo72
搜集汇总
数据集介绍
Ryoo72/MMBench-EN-Dev-V10 数据集图片
构建方式
MMBench-EN-Dev-V10源自OpenCompass官方发布的MMBench_DEV_EN.tsv文件,该文件经MD5校验确保与VLMEvalKit中注册的原始版本一致。构建过程中,原本采用VLMEvalKit压缩的CircularEval格式,其中多行通过索引引用其他行的图像;此数据集对引用关系进行了完全解析,使每一行均包含解码后的独立图像。同时,基于原始l2-category字段将4329个样本划分为六个配置子集,并保留l3类别列中20个细粒度能力标签,从而形成层次化评估结构。
特点
该数据集聚焦于多模态视觉问答与多项选择任务,涵盖粗粒度感知、单实例细粒度感知、跨实例细粒度感知、属性推理、关系推理和逻辑推理六个二级类别,对应20个三级细粒度能力。每个样本提供问题、提示、四个选项、答案、图像及类别信息,便于细粒度诊断模型能力。图像数据已内嵌为PIL格式,消除了外部依赖,支持直接加载与浏览,且数据规模适中,适用于多模态大模型的快速评估与对比分析。
使用方法
使用者可通过HuggingFace的datasets库便捷加载,指定配置名称如'all'或'logic_reasoning',并选择'dev'划分即可获取相应子集。例如,load_dataset("Ryoo72/MMBench-EN-Dev-V10", "all", split="dev")返回完整开发集,而指定'logic_reasoning'则仅加载逻辑推理样本。该数据集与VLMEvalKit评估工具链兼容,可直接用于多模态模型的基准测试,亦支持按类别分层分析模型表现,助力细粒度能力诊断。
背景与挑战
背景概述
多模态大模型的能力评估长期依赖以图像分类或单一视觉问答为核心的基准,难以全面刻画模型在感知、推理与逻辑层面的综合表现。2023年,上海人工智能实验室OpenCompass团队发布MMBench,旨在通过层次化能力体系系统评估多模态模型的全方位表现,其成果发表于arXiv并迅速成为视觉语言模型评测的重要参照。MMBench-EN-Dev-V10作为该基准英文开发集的规范化版本,按L2类别预切分为六个子集,共4,329条样本,涵盖粗粒度感知、细粒度感知、属性推理、关系推理与逻辑推理等维度,为研究者提供了结构清晰、便于浏览的评测资源,推动了多模态评测从单一任务向多维能力诊断的范式转变。
当前挑战
视觉语言问答领域的核心难题在于如何公正衡量模型对图像内容的理解深度,而非仅依赖语言先验或表面匹配。MMBench-EN-Dev-V10所面对的挑战集中于两个层面:在领域问题层面,需在感知、属性、关系与逻辑等多个认知层级上设计具有区分度的题目,避免模型通过答案分布或常识捷径获得虚高成绩,同时保证英文语境下问题的文化中立与语义严谨;在构建过程中,原始TSV采用VLMEvalKit的压缩CircularEval格式,多行以索引引用他行图像而非内嵌base64数据,需逐一解析引用并还原为独立图像,同时校验MD5以确保与官方注册值一致,并按L2类别精确切分六个子集,保留20类L3能力标签,对数据完整性与结构一致性提出了较高要求。
常用场景
经典使用场景
在多模态大模型评测领域,MMBench-EN-Dev-V10常被用作衡量模型综合视觉-语言理解能力的基准工具。其经典使用场景聚焦于通过选择题形式,系统评估模型在粗粒度感知、细粒度感知、属性推理、关系推理和逻辑推理等维度的表现。研究者通常加载全部4329个样本或特定子集,以标准化流程检验模型对图像内容与文本问题的联合理解能力,并借助CircularEval等策略消除选项位置偏差,从而获得稳定可靠的性能排名。
解决学术问题
该数据集有效解决了多模态评测中维度单一、偏差显著和复现性不足等常见学术问题。通过将能力划分为6个二级类别和20个三级类别,它提供了细粒度的诊断信号,帮助研究者定位模型在感知与推理上的具体短板。同时,其严格的数据来源、MD5校验和引用解析机制保障了评测的公平性与可复现性,推动了多模态理解研究从粗放式评分向精细化分析转变,对领域内基准建设具有示范意义。
衍生相关工作
围绕该数据集,学术界与工业界衍生了一系列经典工作。例如,MMBench论文本身提出了CircularEval评测策略,后续研究在此基础上发展出多模态思维链、视觉提示调优等方法。VLMEvalKit将其作为核心基准之一,推动了统一评测框架的建立。此外,V1.1版本的发布以及多个中文、多语言变体的出现,进一步拓展了基准的覆盖范围,激发了大量针对多模态推理能力的改进模型与对比研究。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务