MMLONGBENCH-DOC
收藏资源简介:
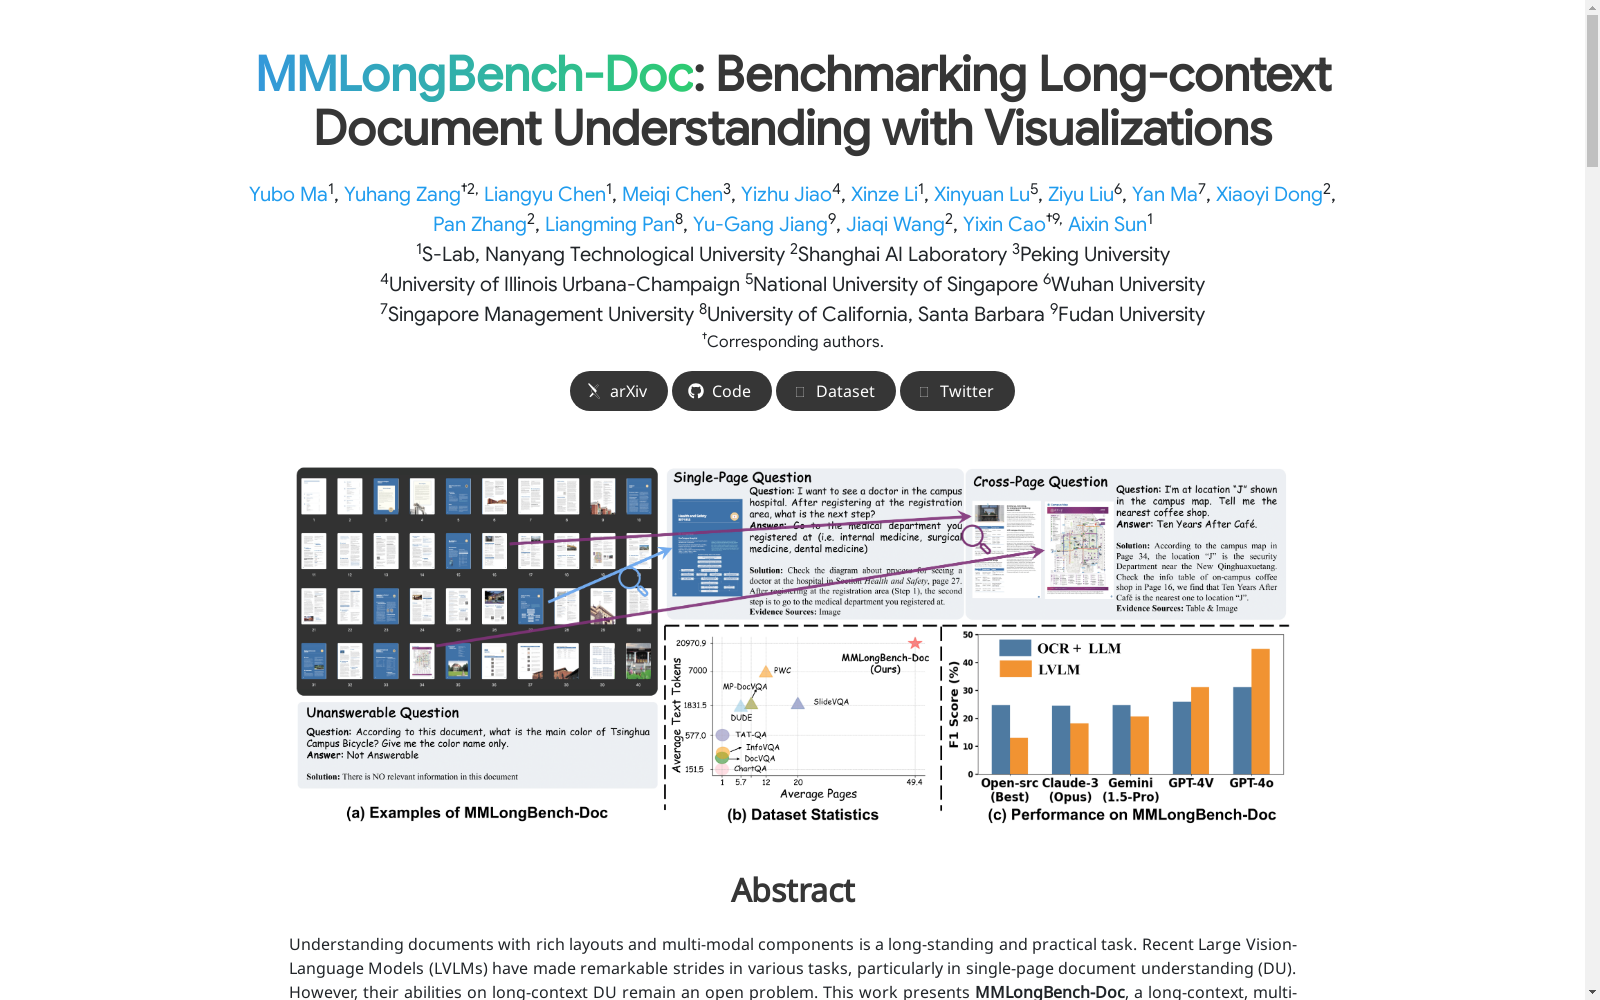
MMLONGBENCH-DOC数据集由南洋理工大学S-Lab等机构创建,旨在评估大型视觉-语言模型在长篇文档理解方面的能力。该数据集包含130个PDF格式的长篇文档,平均每篇文档49.4页,共20,971个文本标记。数据集的创建过程包括文档收集、问题与答案收集和质量控制三个阶段。MMLONGBENCH-DOC主要应用于评估模型在长篇文档中的信息定位和跨页理解能力,旨在解决当前模型在处理长篇文档时面临的挑战。
The MMLONGBENCH-DOC dataset was developed by S-Lab at Nanyang Technological University and other institutions, with the goal of evaluating the long-form document understanding capabilities of large vision-language models. This dataset comprises 130 long-form documents in PDF format, averaging 49.4 pages per document and totaling 20,971 text tokens. The dataset construction process includes three stages: document collection, question-answer pair collection, and quality control. MMLONGBENCH-DOC is primarily applied to assess models' abilities in information localization and cross-page comprehension within long-form documents, aiming to tackle the challenges encountered by current models when processing lengthy documents.
数据集概述
数据集名称
MMLongBench-Doc
数据集描述
MMLongBench-Doc 是一个用于评估长上下文文档理解的多模态基准数据集。该数据集包含 1,091 个专家标注的问题,基于 135 个长篇 PDF 格式的文档构建,每个文档平均有 47.5 页和 21,214 个文本标记。
数据集特点
- 多模态性:所有选定的文档都是 PDF 格式,包含丰富的布局和多模态组件,包括文本、表格、图表和图像。问题从这些多模态证据中仔细标注。
- 长上下文:每个文档平均有 47.5 页和 21,214 个标记。此外,33.0% 的问题是跨页问题,需要收集和推理多个页面的信息。
- 挑战性:在 14 个 LVLMs 上的实验表明,长上下文文档理解对当前模型提出了极大的挑战。即使表现最好的 LVLM,GPT-4o,其总体 F1 分数也仅为 44.9%。
数据集结构
- 文档数量:135 个文档
- 问题数量:1,091 个问题
- 平均页数:47.5 页
- 平均文本标记数:21,214 个
- 领域覆盖:7 个不同领域
数据集目标
该数据集旨在为长上下文文档理解任务提供一个统一且量化的评估基准,以推动未来更强大的长上下文 LVLMs 的研究。