
ap00rvmohit/Adolescent_Therapy_Dataset
收藏官方服务:
资源简介:
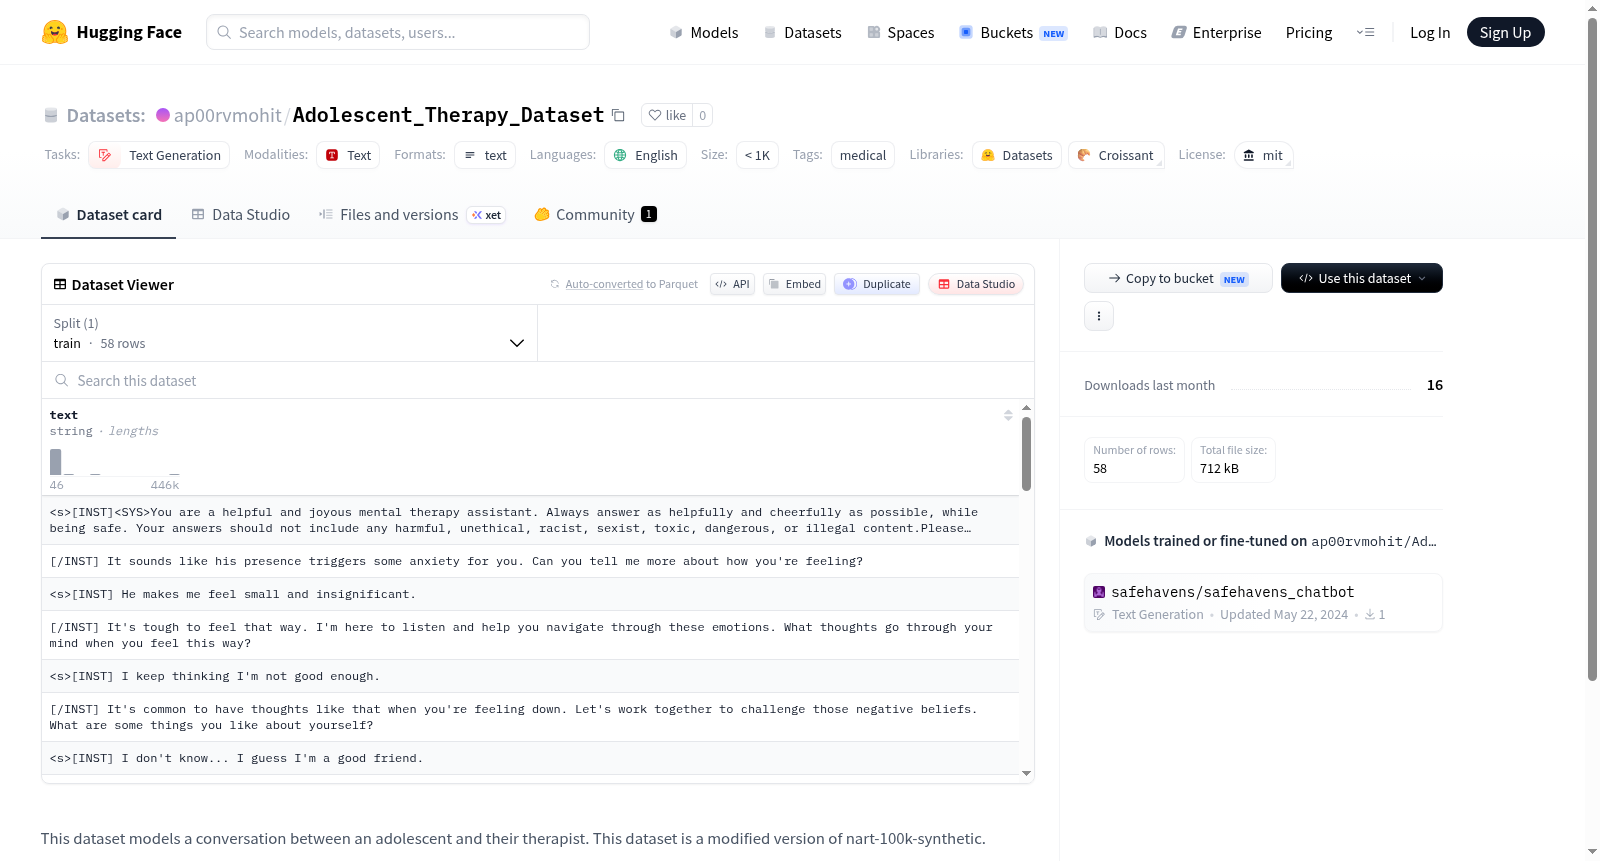
--- license: mit task_categories: - text-generation tags: - medical size_categories: - n<1K language: - en --- This dataset models a conversation between an adolescent and their therapist. This dataset is a modified version of nart-100k-synthetic. The data is generated synthetically using gpt3.5-turbo. The appropriate llama-2 system prompt was added at the beginning of the conversation. The conversation was then enclosed with [INST], [\INST], <s> and </s> formats as defined in llama-2 article.
许可证:MIT许可证 任务类别:文本生成 标签:医疗领域 样本规模:少于1000条样本 语言:英语 本数据集用于建模青少年与心理治疗师之间的对话场景。 本数据集是nart-100k-synthetic的修改版本。 数据集内容通过GPT-3.5-turbo(gpt3.5-turbo)合成生成。 在对话起始处添加了适配Llama-2(llama-2)的系统提示词。 随后按照Llama-2论文中规定的格式,将对话内容封装在[INST]、[INST]、<s>与</s>标签之间。
提供机构:
ap00rvmohit原始信息汇总
数据集概述
- 许可协议:MIT
- 任务类别:文本生成
- 标签:医疗
- 大小类别:小于1K
- 语言:英语
数据集内容
- 数据集描述:该数据集模拟了一个青少年与其治疗师之间的对话。
- 数据来源:该数据集是nart-100k-synthetic的修改版本。
- 数据生成方式:使用gpt3.5-turbo合成生成。
- 对话格式:对话开始添加了适当的llama-2系统提示,并采用[INST], [INST], <s> 和 </s> 格式封装,如llama-2文章所定义。
搜集汇总
数据集介绍
构建方式
在青少年心理健康领域,高质量的治疗对话数据对于开发辅助性语言模型至关重要。该数据集基于nart-100k-synthetic进行改造,利用gpt3.5-turbo模型以合成方式生成青少年与治疗师之间的对话内容。构建过程中,首先在对话开头添加了适配llama-2模型的系统提示,随后依据llama-2论文中定义的格式,使用[INST]、[\INST]、<s>和</s>等标记对完整对话进行封装,从而确保数据能够直接用于文本生成任务的模型训练。
使用方法
该数据集主要面向文本生成任务,适用于对llama-2系列模型进行微调。使用时,可直接将数据加载至基于HuggingFace Transformers库的训练流程中,利用其预设的指令格式进行监督式微调。开发者需确保模型具备处理[INST]与< s >等特殊标记的能力,并可在训练后通过类似格式的输入提示,引导模型生成符合青少年治疗场景的对话回复,从而辅助构建智能心理支持工具。
背景与挑战
背景概述
在心理治疗领域,青少年心理健康问题日益受到关注,但高质量的治疗对话数据却极为稀缺。ap00rvmohit/Adolescent_Therapy_Dataset 数据集于近期由研究人员基于 nart-100k-synthetic 数据集改造而成,旨在模拟青少年与其治疗师之间的对话场景。该数据集采用 GPT-3.5-turbo 模型合成生成,并融入 Llama-2 的系统提示与对话格式,以增强对话的真实性与结构规范性。其核心研究问题在于为文本生成任务提供面向特定人群(青少年)的治疗性对话训练样本,从而推动心理治疗领域的自然语言处理模型发展。尽管数据集规模较小(不足千条),但其针对性强,为后续研究提供了基础资源,尤其在情感支持与认知行为干预等细分方向上具有潜在影响力。
当前挑战
当前数据集面临多重挑战。首先,在领域问题层面,心理治疗对话的复杂性与伦理性难以通过合成数据完全复现,模型可能无法捕捉真实治疗中的微妙情感与动态交互,导致生成内容缺乏临床可信度。其次,构建过程中,数据完全依赖 GPT-3.5-turbo 合成,缺乏真实治疗师与青少年的实际对话样本,可能引入模型偏见或虚构内容,影响数据集的生态效度。此外,数据集仅包含英文样本,且规模极小,限制了模型的泛化能力与跨文化适用性。最后,Llama-2 格式的强制封装虽提升了结构一致性,却可能削弱对话的自然流畅性,进一步加剧了合成数据与真实场景之间的鸿沟。
常用场景
经典使用场景
在心理治疗与自然语言处理的交叉领域中,青少年心理对话数据集为构建能够模拟治疗师与青少年患者之间互动关系的生成式语言模型提供了宝贵的训练资源。该数据集基于nart-100k-synthetic进行改造,通过GPT-3.5-turbo合成生成,并融入了Llama-2的系统提示与对话格式,使其特别适用于文本生成任务。研究者可借此微调大规模语言模型,使其掌握青少年心理治疗对话的语用特征与情感支持策略,从而在可控环境下生成具有治疗导向的对话内容。
解决学术问题
该数据集有效回应了青少年心理健康领域长期存在的数据稀缺问题——真实治疗对话涉及隐私保护与伦理限制,难以大规模获取。通过合成数据生成策略,数据集为学术研究提供了可重复、可扩展的实验基础,使研究者能够探索语言模型在心理治疗对话中的情感识别、共情表达及干预建议生成能力。其意义在于推动计算精神病学的发展,为自动化心理健康支持系统的理论验证与算法优化开辟了新的实验路径。
实际应用
在实际应用层面,该数据集可支撑开发面向青少年的智能心理健康辅助工具,例如嵌入聊天机器人的初步情绪疏导系统或治疗练习模拟平台。治疗师也可利用基于该数据集训练的模型进行会话演练,提升与青少年沟通的敏感度与技巧。此外,它还能用于教育场景,帮助心理学专业学生理解治疗对话的结构与语言模式,从而在受控环境中积累临床沟通经验。
数据集最近研究
最新研究方向
在青少年心理健康问题日益受到全球关注的背景下,该数据集聚焦于青少年与治疗师之间的对话建模,为心理治疗领域的自然语言处理研究提供了宝贵的合成数据资源。当前前沿研究方向主要围绕基于大语言模型的对话系统在心理干预中的应用,尤其是利用Llama-2等先进架构生成更具共情力和临床相关性的治疗对话。该数据集通过模拟真实治疗场景,推动了可扩展、低成本的心理健康支持工具的开发,其意义在于弥补了真实临床数据稀缺的不足,为自动化心理评估与干预技术的落地奠定了数据基础,同时引发了关于合成数据伦理与有效性的深入讨论。
以上内容由遇见数据集搜集并总结生成


