
penglingwei/follow-policy-dataset-arrow
收藏官方服务:
资源简介:
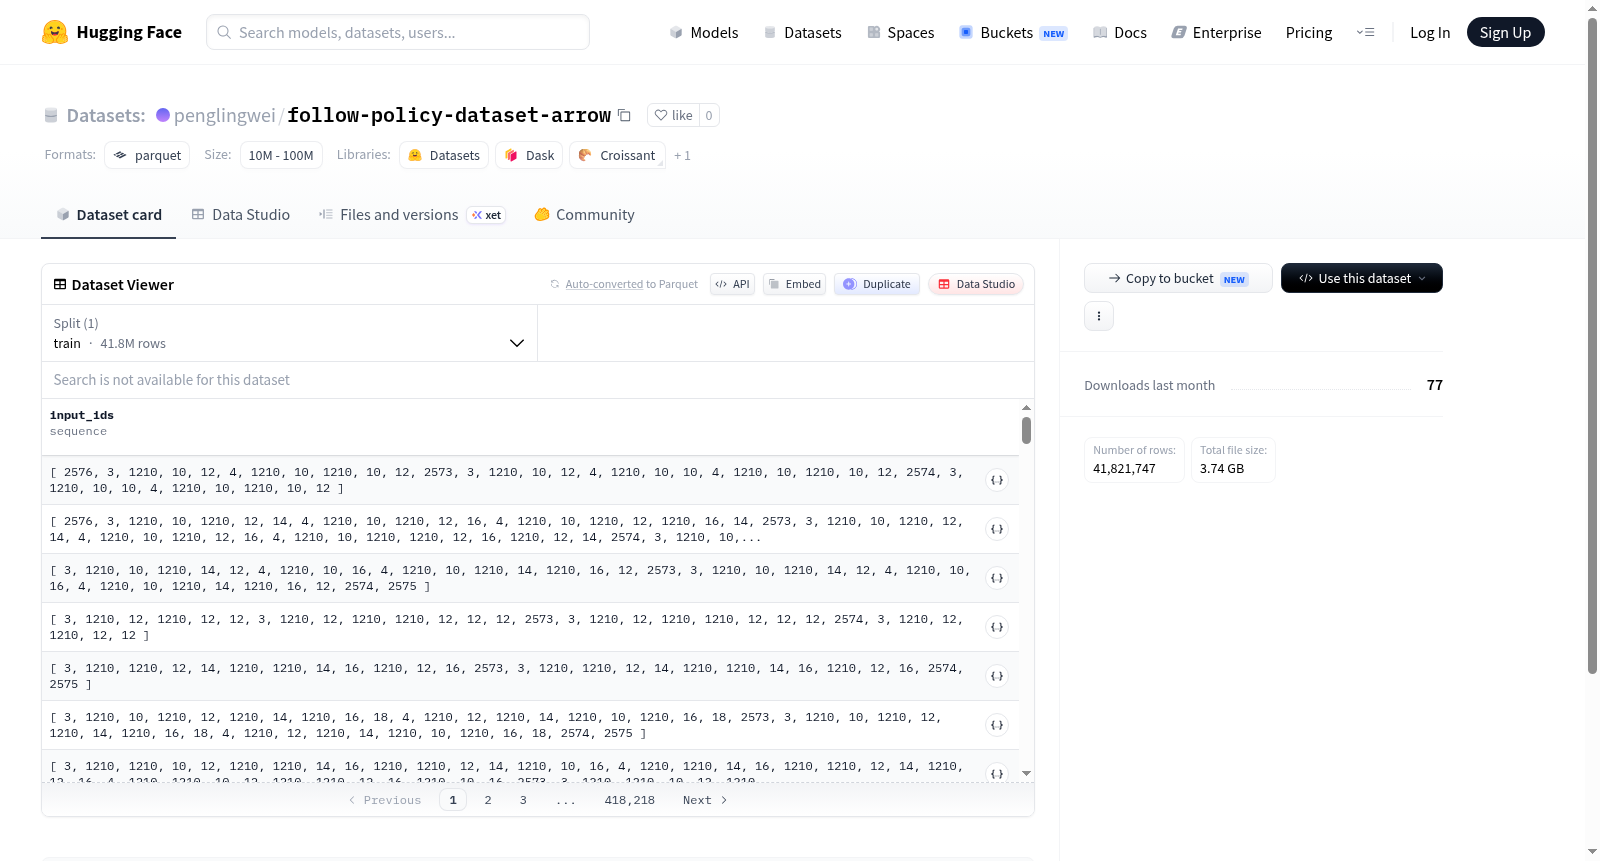
该数据集包含一个名为train的分割,共有41,821,747个样本,总大小为96,959,162,196字节。数据集的特征包括一个名为input_ids的序列,其数据类型为int64。数据集的下载大小为3,744,535,420字节。
The dataset includes a split named train with 41,821,747 examples, totaling 96,959,162,196 bytes. The features of the dataset include a sequence named input_ids with a data type of int64. The download size of the dataset is 3,744,535,420 bytes.
提供机构:
penglingwei搜集汇总
数据集介绍
构建方式
在智能决策与强化学习领域,高质量的行为策略数据集是训练智能体模仿人类专家或优化自身策略的关键资源。penglingwei/follow-policy-dataset-arrow数据集通过大规模收集与整理策略跟踪过程中的状态-动作序列构建而成,其核心数据格式为int64类型的input_ids序列,用以表征决策过程中的输入特征。该数据集以箭头格式存储,旨在高效支持序列化数据的读写与处理,为后续策略学习任务提供结构化、标准化的数据基础。
特点
该数据集最显著的特点在于其庞大的规模与统一的特征设计。其训练集包含超过4182万个样本,总数据量接近97GB,为深度策略模型提供了充足的训练素材。所有样本均采用单一input_ids字段,以整数序列形式呈现,既简化了数据预处理流程,又保证了模型输入的兼容性。此外,数据集采用分片存储策略,便于分布式加载与并行计算,显著提升了大规模训练的实用性与效率。
使用方法
使用该数据集时,推荐通过HuggingFace的datasets库进行加载,指定config名称为default,并利用data/train-*通配符读取所有分片文件。开发者可将input_ids序列直接作为语言模型或序列决策模型的输入,例如用于因果语言建模或行为克隆任务。由于数据已预编码为整数序列,用户无需额外分词,仅需根据模型要求补充注意力掩码或位置编码即可快速开展训练与评估。
背景与挑战
背景概述
在人工智能与机器人交叉研究领域,策略学习(policy learning)一直是实现智能体自主决策的核心挑战。penglingwei/follow-policy-dataset-arrow数据集由研究人员彭令伟于近年创建,旨在为基于序列决策的跟随策略(follow policy)提供大规模训练样本。该数据集包含超过4100万条训练实例,每条实例以输入令牌序列(input_ids)形式呈现,总数据规模约97GB,压缩后仍达3.7GB。其核心研究问题聚焦于如何通过海量序列化行为数据,使智能体能够从示范中学习到鲁棒的跟随策略,从而在复杂动态环境中实现目标导向的导航与交互。该数据集的发布为模仿学习、离线强化学习以及多模态策略泛化研究提供了关键资源,推动了从简单跟踪到语义跟随的范式演进,对服务机器人、自动驾驶等应用领域产生了潜在影响。
当前挑战
当前数据集面临的核心挑战涵盖领域问题与构建过程两方面。在领域问题层面,跟随策略需要应对环境动态变化带来的分布偏移问题,例如训练数据中的示范轨迹可能无法覆盖测试时遇到的未知障碍或光照条件,导致策略泛化能力不足。此外,序列决策中的长程依赖关系使得模型容易陷入局部最优,难以在复杂任务中保持一致性跟随。在构建过程中,数据集面临数据质量控制难题:超过4100万条序列样本需确保标注一致性,避免噪声示范误导策略学习;同时,数据存储与传输的规模(约97GB)对计算资源提出高要求,训练时需平衡批次采样效率与内存限制。这些挑战共同制约着基于该数据集训练的策略在实际部署中的可靠性与鲁棒性。
常用场景
经典使用场景
在自然语言处理与强化学习的交叉领域,penglingwei/follow-policy-dataset-arrow 数据集以其海量的序列化输入特征(包含超过4100万条训练样本)成为训练语言模型遵循指令策略的基石。该数据集旨在为模型提供丰富的上下文-响应配对,使其能够学习如何根据给定的政策或规则生成符合预期的文本输出。经典使用场景包括构建基于语言指令的对话系统、自动化内容审核工具以及智能客服机器人,其中模型需准确理解并执行预设的行为准则。
衍生相关工作
基于该数据集,研究者已衍生出多项经典工作,例如开发了用于评估语言模型策略遵循能力的基准测试框架,以及提出了结合强化学习的策略蒸馏方法。此外,有工作利用该数据集训练了多任务策略对齐模型,证明了在统一框架下同时处理多种不同类型指令的可行性。这些衍生工作不仅验证了数据集在促进策略学习研究中的核心价值,也为后续探索人机交互中的安全对齐问题提供了重要参考。
数据集最近研究
最新研究方向
在大规模语言模型与多模态对齐的前沿探索中,指令跟随策略的优化成为关键瓶颈。penglingwei/follow-policy-dataset-arrow作为包含逾4100万样本的序列化指令数据集,其核心价值在于为模型提供细粒度的行为约束与策略对齐训练素材。当前研究聚焦于利用此类大规模行为序列数据,通过隐式策略蒸馏与对比学习范式,提升模型在复杂任务链中的自主决策能力与指令遵循忠实度。该数据集的出现直接呼应了具身智能与自动化决策系统对高质量行为轨迹数据的需求,尤其在机器人操作规划与对话式任务求解领域,其庞大的规模与紧凑的序列结构为训练端到端策略网络提供了关键支撑,推动着从静态语言理解向动态环境交互的范式跃迁。
以上内容由遇见数据集搜集并总结生成


