
m-a-p/II-Bench
收藏官方服务:
资源简介:
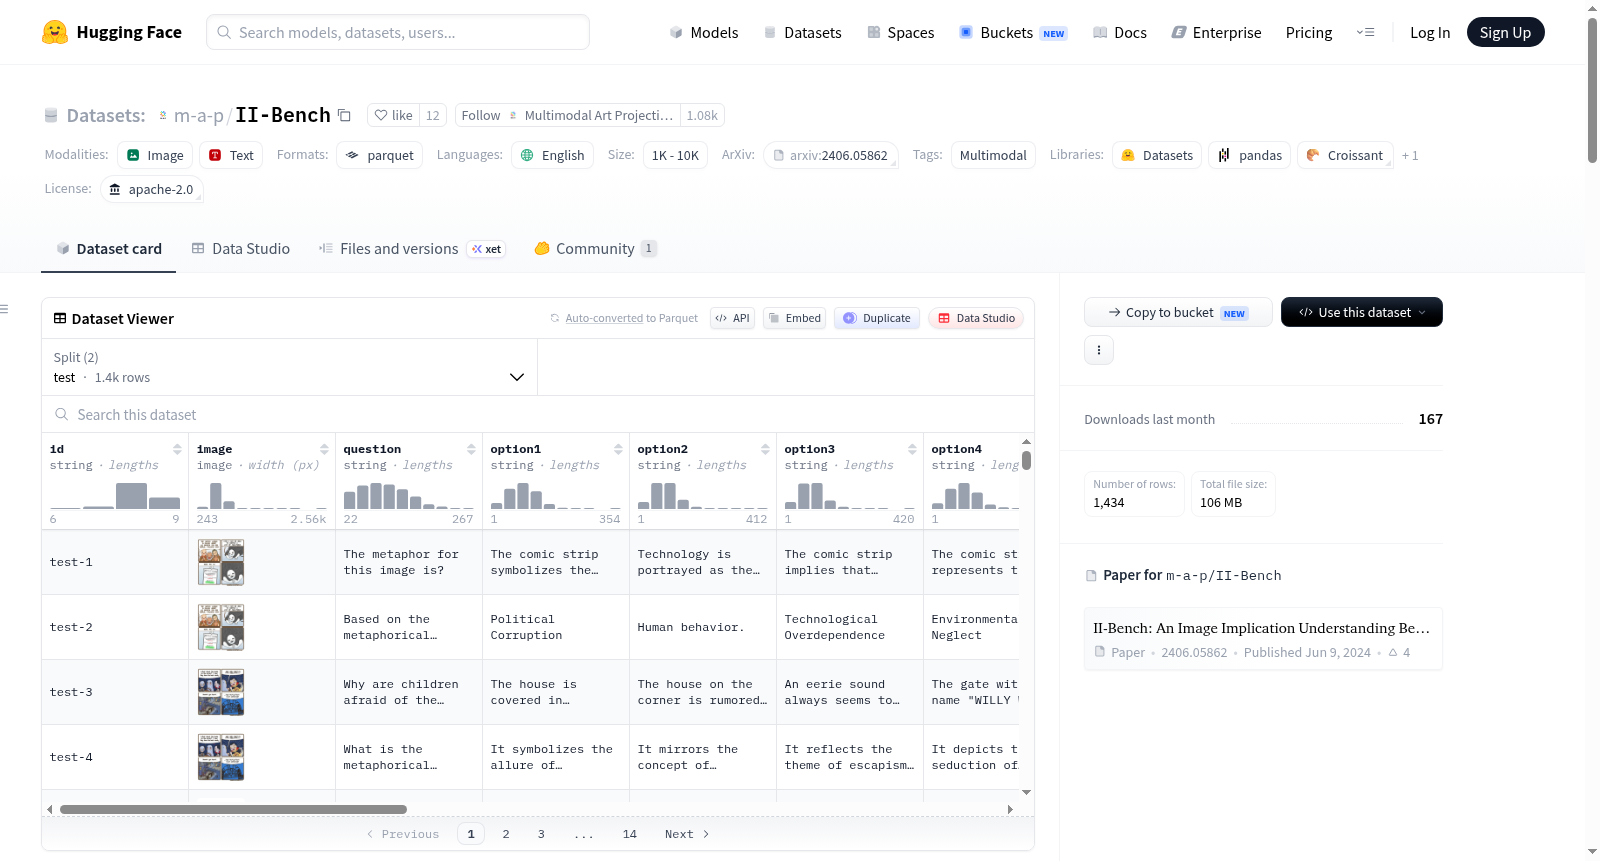
II-Bench数据集包含1,222张图像,每张图像伴随1到3个多项选择题,总计1,434个问题。图像来自六个不同的领域,包括生活、艺术、社会、心理学、环境和其他。图像类型多样,包括插图、表情包、海报、多面板漫画、单面板漫画、标志和绘画。数据集的特征包括图像、问题、选项、正确答案、答案、图像类型、难度、领域、情感、修辞、解释和本地路径。数据集分为测试集和开发集,分别包含1,399个和35个样本。
The II-Bench dataset comprises 1,222 images, each accompanied by 1 to 3 multiple-choice questions, totaling 1,434 questions. These images span six distinct domains: Life, Art, Society, Psychology, Environment, and Others. The image types are diverse, including Illustrations, Memes, Posters, Multi-panel Comics, Single-panel Comics, Logos, and Paintings.
提供机构:
m-a-p原始信息汇总
数据集概述
基本信息
- 语言: 英语
- 许可证: Apache 2.0
- 数据规模: 1K<n<10K
- 标签: 多模态
数据集结构
特征
- id: 字符串
- image: 图像
- question: 字符串
- option1: 字符串
- option2: 字符串
- option3: 字符串
- option4: 字符串
- option5: 字符串
- option6: 字符串
- correct_option: 字符串
- answer: 字符串
- image_type: 字符串
- difficulty: 字符串
- domain: 字符串
- rhetoric: 字符串
- explanation: 字符串
- local_path: 字符串
分割
- test: 1399个样本, 100889781.044字节
- dev: 35个样本, 2833848字节
大小
- 下载大小: 329673609字节
- 数据集大小: 103723629.044字节
配置
- config_name: default
- data_files:
- test: data/test-*
- dev: data/dev-*
- data_files:
数据集内容
- 图像数量: 1222张
- 问题数量: 1434个
- 领域: 生活、艺术、社会、心理学、环境和其他
- 图像类型: 插图、表情包、海报、多格漫画、单格漫画、标志和绘画
搜集汇总
数据集介绍
构建方式
II-Bench数据集的构建立足于对多模态大语言模型图像内涵理解能力的深度评测需求,精心遴选了1,222幅图像,并围绕每幅图像设计了1至3道多项选择题,最终汇聚成包含1,434个问题的评测基准。数据集覆盖生活、艺术、社会、心理学、环境及其他六大领域,图像类型涵盖插画、梗图、海报、多格漫画、单格漫画、标志及绘画等多元形态。为确保数据的合规性与伦理性,标注过程严格遵循原始来源的版权与许可规则,避免从禁止复制和分发的网站获取素材,并对可能侵权的样本设立反馈与移除机制。
特点
该数据集的核心特色在于其高度聚焦于图像隐含意义的理解,而非浅层的视觉识别,从而对多模态大语言模型的推理与共情能力提出严峻挑战。数据集中每道题目均配有标准答案、详细解释以及图像类型、难度、领域、情感和修辞等丰富元信息,为用户提供了多维度的分析视角。此外,II-Bench通过设置开发集(35个样本)与测试集(1,399个样本)的划分,并配置了涵盖开源与闭源模型的排行榜,揭示了当前先进模型在该任务上的表现差异,凸显了图像隐含理解任务的复杂性与前沿性。
使用方法
使用II-Bench数据集时,用户可直接从HuggingFace平台加载默认配置,其数据分为'test'与'dev'两个子集,每个样本包含图像、问题、六个选项、正确答案及解释等字段。研究者可基于该数据集评估多模态大语言模型在图像隐含理解任务上的性能,通过对比模型输出与'correct_option'字段计算准确率。数据集支持通过Python的datasets库便捷调用,并鼓励用户参考其官方论文与排行榜进行结果分析,为模型改进提供实证依据。
背景与挑战
背景概述
在人工智能领域,多模态大语言模型(MLLMs)的迅猛发展催生了对其视觉理解能力进行深度评估的迫切需求。2024年,由中国科学院深圳先进技术研究院、中国科学技术大学、华中科技大学、密歇根大学等多家机构联合团队共同创建的II-Bench数据集应运而生。该数据集聚焦于图像隐含含义理解这一核心研究问题,旨在弥补现有基准测试中仅关注图像表层信息而忽略深层语义推理的不足。II-Bench包含1222张精心挑选的图像,覆盖生活、艺术、社会、心理、环境及其他六大领域,并涵盖插画、表情包、海报、多格漫画、单格漫画、标志和绘画等多种图像类型,共计1434道多项选择题。该数据集通过引入情感、修辞等标注维度,为评估MLLMs在复杂文化语境下的语义理解能力提供了全新视角,在学术界产生了广泛影响,成为检验模型高级视觉推理水平的重要标杆。
当前挑战
II-Bench数据集所面临的挑战首先体现在其解决的领域问题上:传统图像分类和视觉问答任务往往局限于物体识别或简单场景描述,而II-Bench要求模型具备图像隐含含义的理解能力,这涉及对文化隐喻、情感表达、修辞手法等深层语义的推理,对MLLMs的认知架构提出了更高要求。在构建过程中,团队遇到了多重困难:数据收集需从海量网络资源中筛选出具有隐含含义的图像,并严格遵守版权法规,避免使用禁止复制和分发的材料;标注工作需跨领域专家协作,确保每道题目中选项的迷惑性和正确答案的合理性,同时为每个样本标注情感、修辞等元信息,增加了标注复杂度;此外,数据集的规模控制在一千四百余题,在有限样本内保证领域覆盖的均衡性和难度梯度的合理性,也是设计中的一大挑战。
常用场景
经典使用场景
在图像理解与多模态大语言模型的研究领域中,II-Bench作为一项专注于图像隐含意义理解的基准测试,其经典使用场景在于评估模型对非直白视觉信息的深层语义解析能力。该数据集精心构建了涵盖生活、艺术、社会、心理、环境及其他六大领域的1222幅图像,并配以1434道多项选择题,旨在考察模型从插图、梗图、海报、多格漫画、单格漫画、Logo及绘画等多种图像类型中捕捉隐喻、讽刺、情感与修辞等复杂内涵的能力。研究者常利用II-Bench对前沿多模态模型进行系统性评估,以衡量其在图像隐含意义理解任务上的表现水平,从而推动模型从浅层视觉感知向深层认知推理的跨越。
解决学术问题
II-Bench的诞生有效填补了当前多模态大语言模型评估体系中针对图像隐含意义理解这一维度的空白。传统的视觉问答基准多聚焦于物体识别、场景描述或事实性知识问答,而忽视了人类交流中普遍存在的隐喻、反讽、情感暗示等非字面含义的解读。该数据集通过精心设计的跨领域、多类型图像与问题,系统性地揭示了现有模型在理解图像深层语义与修辞手法上的显著局限。这一挑战促使学术界重新审视多模态模型在认知推理、常识应用及文化语境理解等方面的不足,为后续研究指明了关键突破方向,具有深远的学术价值。
衍生相关工作
II-Bench的提出催生了一系列富有启发性的衍生研究。一方面,其公开的迷你排行榜与评估结果激发了研究者对模型架构的改进探索,例如通过引入视觉修辞感知模块、情感推理机制或多视角语义融合策略来提升模型在隐含意义理解任务上的表现。另一方面,该数据集所揭示的模型能力边界促使学者构建更具挑战性的跨文化视觉理解基准,以及针对特定图像类型(如梗图、漫画)的专项数据集。此外,基于II-Bench的失败案例分析也推动了可解释性研究的发展,致力于揭示多模态模型在理解非字面含义时的内部表征与推理路径,从而为下一代认知级多模态系统的设计奠定理论基础。
以上内容由遇见数据集搜集并总结生成


