
alonj/FLenQA
收藏官方服务:
资源简介:
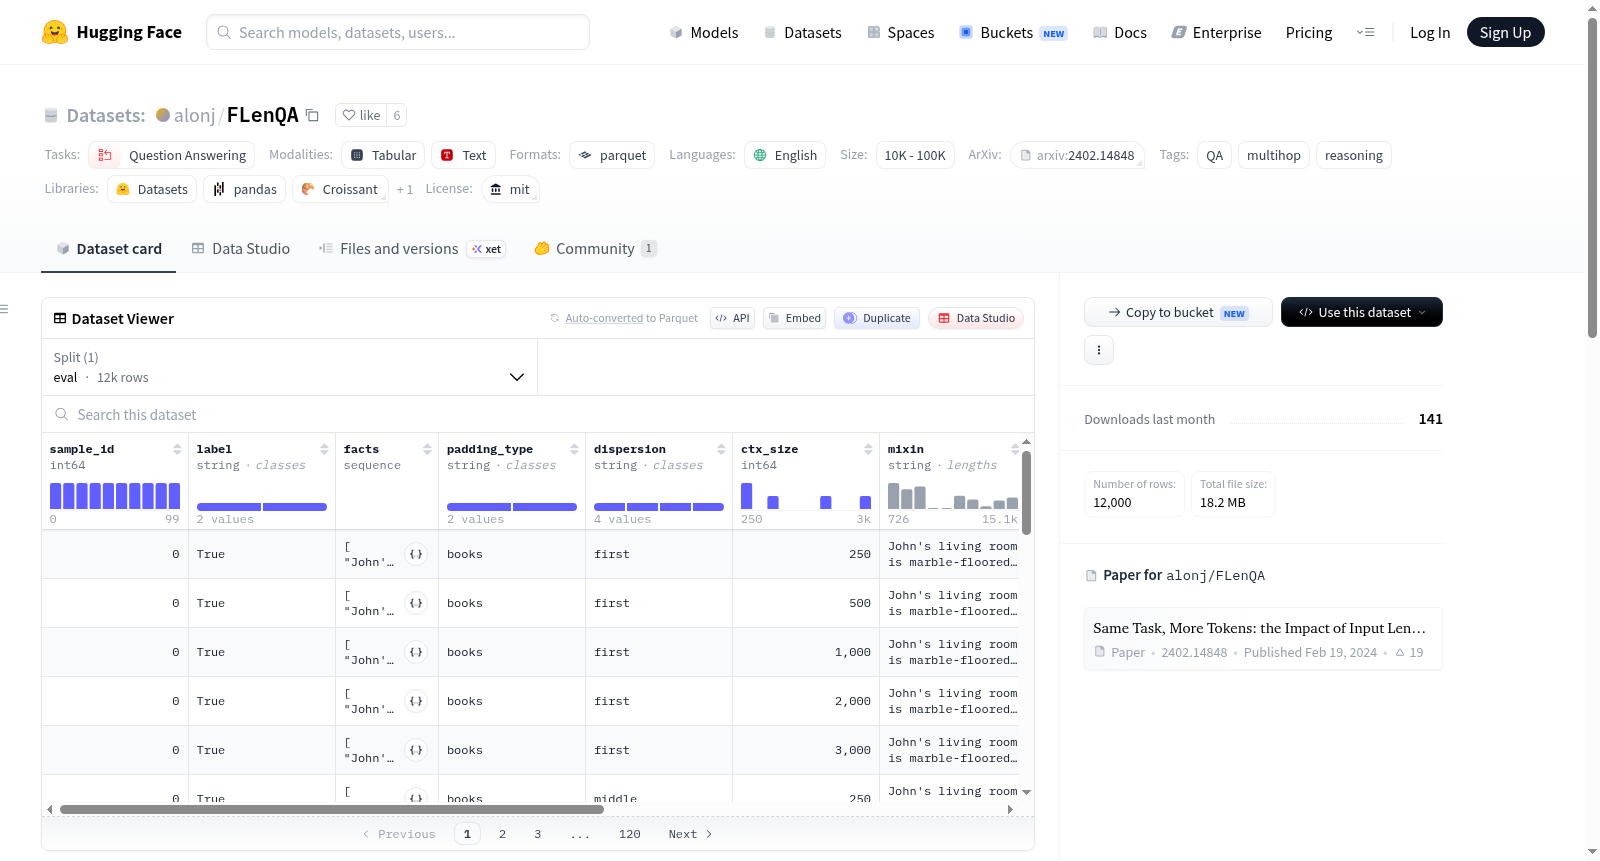
FLenQA数据集是一个专门设计用于评估输入长度对大型语言模型(LLMs)在问答推理任务中表现影响的数据集。通过引入不同长度、类型和位置的填充,该数据集能够隔离输入长度的影响,并研究模型在不同输入长度下的表现一致性。数据集以JSONL格式存储,每个样本包含多个字段,如`global_sample_id`、`sample_id`、`label`、`facts`、`rule`、`statement`等,用于描述样本的各个方面。
FLenQA数据集是一个专门设计用于评估输入长度对大型语言模型(LLMs)在问答推理任务中表现影响的数据集。通过引入不同长度、类型和位置的填充,该数据集能够隔离输入长度的影响,并研究模型在不同输入长度下的表现一致性。数据集以JSONL格式存储,每个样本包含多个字段,如`global_sample_id`、`sample_id`、`label`、`facts`、`rule`、`statement`等,用于描述样本的各个方面。
提供机构:
alonj原始信息汇总
数据集概述
基本信息
- 语言: 英语
- 许可: MIT
- 任务类别: 问答
- 标签: QA, multihop, reasoning
数据集特征
- sample_id: 样本ID,数据类型为int64
- label: 标签,数据类型为string
- facts: 事实,序列类型为string
- padding_type: 填充类型,数据类型为string
- dispersion: 分散类型,数据类型为string
- ctx_size: 上下文大小,数据类型为int64
- mixin: 事实与填充的混合,数据类型为string
- dataset: 数据集名称,数据类型为string
- global_sample_id: 全局样本ID,数据类型为int64
- assertion/question: 断言或问题,数据类型为string
- rule: 规则,数据类型为string
- statement: 陈述,序列类型为string
数据集划分
- eval: 评估集,包含12000个样本,大小为85410519字节
数据集大小
- 下载大小: 18218707字节
- 数据集大小: 85410519字节
配置
- config_name: default
- data_files:
- split: eval
- path: data/eval-*
- data_files:
搜集汇总
数据集介绍
构建方式
在大型语言模型推理能力的研究中,输入长度对模型表现的影响是一个关键但尚未被充分探索的课题。为系统性地隔离并考察这一效应,研究者构建了FLenQA数据集。该数据集基于一种新颖的问答推理框架,核心策略是针对同一个样本生成多个版本,每个版本通过填充不同长度、类型和位置的额外内容来扩展输入。数据集以JSONL格式存储,每条样本包含全局唯一标识符、任务内标识符、目标标签、所属数据集名称、用于推理的事实或规则列表、断言或问题、填充类型、分散方式以及目标上下文大小等字段,从而精确控制输入长度的变化。
特点
FLenQA数据集最显著的特点在于其专门为评估输入长度对推理性能的影响而设计,通过在同一任务中引入可变长度的填充内容,实现了对输入长度效应的纯净隔离。数据集涵盖了多种推理任务类型,如事实识别、关系推理和简化规则推理,并提供了丰富的元信息,包括填充类型(padding_type)和分散方式(dispersion),使得研究者能够深入分析不同扩展策略对模型表现的影响。此外,每个样本均保留了原始事实或规则,便于追溯模型在长上下文中的推理过程。
使用方法
使用FLenQA数据集时,研究者可直接加载其JSONL格式的评估集(包含12,000个样本),利用提供的字段构建模型输入。具体而言,可将'mixin'字段中的内容作为提示文本,结合任务指令输入至大型语言模型,并依据'label'字段中的布尔值评估模型输出的正确性。通过比较不同'ctx_size'、'padding_type'和'dispersion'配置下的模型表现,能够系统性地分析输入长度变化对推理准确率的影响。该数据集特别适用于对比实验设计,例如控制其他变量不变,仅改变输入长度来观测模型行为的差异。
背景与挑战
背景概述
FLenQA数据集由Mosh Levy、Alon Jacoby与Yoav Goldberg等研究人员于2024年提出,旨在系统性地探究输入长度对大型语言模型(LLM)推理性能的影响。随着LLM在自然语言处理领域取得突破性进展,其在不同输入长度下表现的一致性仍是一个尚未充分理解的谜团。该数据集创新性地构建了一个灵活的问答推理框架,通过为同一问题样本添加不同长度、类型和位置的填充内容,从而在控制其他变量的前提下,精准隔离输入长度这一变量。FLenQA的诞生为评估LLM的鲁棒性提供了标准化测试基准,其研究成果直接推动了学界对模型长上下文理解能力的认知,并为后续优化模型架构与训练策略奠定了重要基础。
当前挑战
FLenQA数据集所面临的核心挑战在于双重维度:其一,在领域问题层面,当前LLM在处理长序列输入时,其推理准确率往往随上下文扩展而显著下降,这种“长度敏感性”严重制约了模型在复杂文档分析、多跳推理等场景下的实际应用,亟需通过标准化评估手段揭示其失效模式;其二,在数据集构建过程中,如何设计出既能有效隔离长度变量、又保持语义逻辑完整的填充策略是一大难题,需要平衡填充内容的多样性(如无意义文本、重复句子或相关事实)与位置分散性,同时确保不同版本样本的标签一致性,避免引入额外噪声干扰实验结果的可解释性。
常用场景
经典使用场景
在大型语言模型(LLM)的推理能力评估中,输入长度对模型性能的影响长期未获充分探索。FLenQA数据集通过精心设计的可控长度问答框架,为研究者提供了系统考察输入长度效应的独特工具。该数据集的核心创新在于对同一推理样本进行多版本扩展,通过插入不同长度、类型和位置的填充文本,在保持任务本质不变的前提下精确调控输入长度。这种设计使得研究者能够分离出长度因素,专门探究模型在短文本与长文本推理任务中的表现差异,尤其适用于分析LLM在增加上下文窗口时是否仍能维持推理准确性。该数据集覆盖了多跳推理和逻辑规则推理等经典场景,成为检验模型鲁棒性的重要基准。
解决学术问题
该数据集直面当前LLM研究中一个关键但被忽视的学术问题——模型在不同输入长度下的推理一致性。尽管LLM在众多自然语言处理任务中取得了突破性进展,但其性能是否随输入长度增加而衰减仍缺乏系统性认识。FLenQA通过隔离输入长度这一变量,揭示了模型在长上下文场景中推理能力下降的具体模式,为理解LLM的注意力机制缺陷和语义漂移现象提供了实证基础。该研究的意义在于推动了“长度鲁棒性”这一评价维度的确立,促使学术界重新审视现有模型在真实长文档场景中的适用性,并为设计更稳健的注意力机制和位置编码方案提供了理论指导。
衍生相关工作
FLenQA数据集的提出催生了一系列重要的后续研究工作。其核心思想被扩展至更广泛的长度泛化研究领域,如LONGLLM和LongBench等基准测试借鉴了其可控长度设计理念。在模型改进方面,基于该数据集发现的长度敏感性现象,研究者提出了多种位置编码优化方案(如ALiBi的变体)和稀疏注意力机制(如Longformer的改进版)。此外,该数据集还激发了关于“填充干扰”效应的深入分析,衍生出针对填充文本类型和位置对推理影响的研究分支。在评估方法论层面,FLenQA推动了动态难度基准的构建,使得模型能力评估不再局限于固定长度设置,而是能反映真实应用中的长度多样性挑战。
以上内容由遇见数据集搜集并总结生成


