
desik98/TeluguRiddles
收藏官方服务:
资源简介:
`TeluguRiddles`是一个开源数据集,包含通过从多个谜语网站抓取生成的800多条记录。该数据集主要用于训练大型语言模型、生成合成数据和数据增强。数据集以Telugu语言为主,但也可能包含一些英语内容。数据集可以用于任何目的,包括学术和商业用途,遵循Apache 2.0许可证。
TeluguRiddles is an open-source dataset containing over 800 records generated by scraping from multiple riddle websites. This dataset is primarily intended for training large language models (LLMs), generating synthetic data, and data augmentation. It is mainly in the Telugu language, but may also contain some English content. The dataset can be used for any purpose, including academic and commercial applications, under the Apache 2.0 license.
提供机构:
desik98原始信息汇总
数据集概述
基本信息
- 名称: Telugu Riddles
- 语言: 泰卢固语 (te)
- 许可证: Apache 2.0
- 数据集大小: n<1K
- 数据来源: 原创
- 标签: 谜语
- 任务类别: 文本生成
- 任务ID: 语言建模
数据集详情
- 概述:
TeluguRiddles是一个包含超过800条记录的语料库,通过网络爬虫从多个谜语网站收集而来。该数据集可用于以下任务:- 给定谜语,生成答案。
数据字段
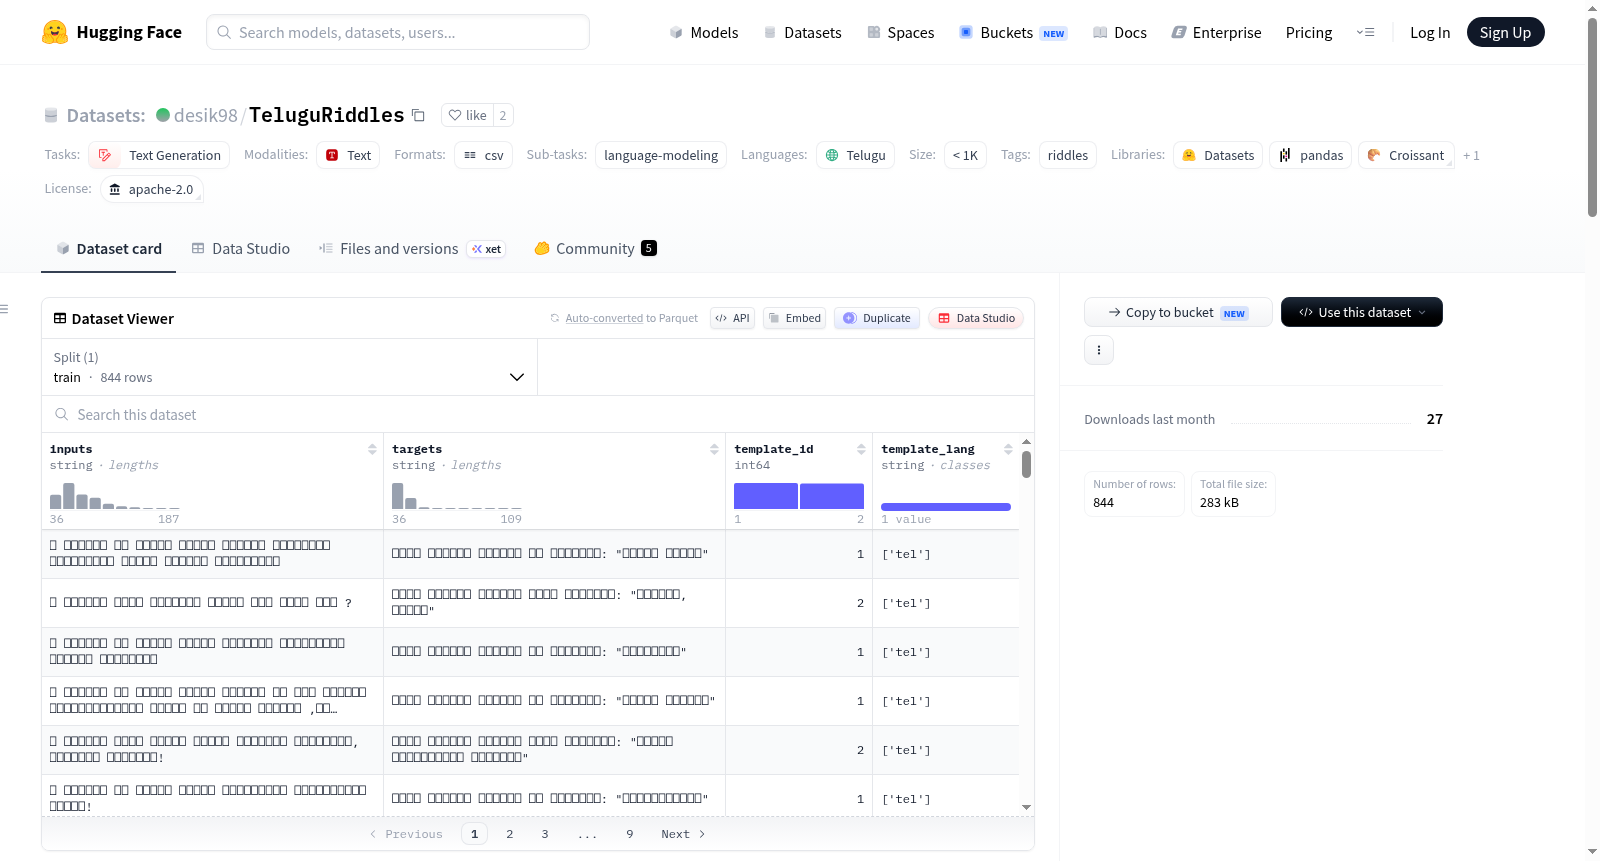
inputs: 语言模型的提示或输入。targets: 语言模型的完成或输出。template_id: 在inputs和targets中使用的模板的ID。template_lang: 在inputs和targets中使用的语言的ISO代码,其中 tel 指泰卢固语。
模板
- 用于从爬取的数据创建指令样式提示和完成的模板如下:
- 给定文章的标题/标题,生成带有该标题/标题的文章。
template_id inputs targets 1 ఈ రిడిల్ కి సమాధానం ఇవ్వు {{Riddle}} మీరు అడిగిన రిడిల్ కి సమాధానం: {{Answer}} 2 ఈ పొడుపు కథ కి సమాధానం ఇవ్వు {{Riddle}} మీరు అడిగిన పొడుపు కథ కి సమాధానం: {{Answer}}
- 给定文章的标题/标题,生成带有该标题/标题的文章。
已知限制
- 该数据集从多个谜语网站爬取,数据集内容可能反映偏见、事实错误、不当和敏感问题。
- 尽管尽最大努力保持数据集为单语种,但可能会有一些记录同时包含泰卢固语和英语。
贡献者
搜集汇总
数据集介绍
构建方式
在泰卢固语这一低资源语言中,面向谜语及其答案生成的指令式数据集尚属空白。为弥补这一缺憾,研究者从多个泰卢固语谜语网站出发,通过系统性网络爬取手段,采集了涵盖不同难易程度的谜语文本。随后对原始数据执行精细的预处理流程,剔除无效字符与质量低劣的谜语条目。最终,将清洗后的数据转化为指令式提示与对应补全的格式,构建出包含超过800条记录的高质量语料库。该数据集作为Cohere For AI发起的Aya开放科学倡议的一部分,旨在确保泰卢固语在人工智能与机器学习领域获得充分代表。
特点
该数据集的核心特色在于其指令式结构的精心设计,每条记录均由输入提示与目标输出构成,并附有模板标识符与语言代码,便于模型进行文本生成任务的微调。数据集源自多个公开谜语网站,内容覆盖广泛,兼具多样性与原始性。尽管以泰卢固语为主,研究者已尽力维持单语纯净性,但个别记录可能混入英语表达。此外,数据集采用Apache 2.0许可证,允许学术与商业场景下的自由使用、修改与扩展,突破了常见数据集仅限非商业用途的限制。
使用方法
使用者可通过Hugging Face Datasets库便捷加载该数据集,仅需执行`pip install datasets --upgrade`安装依赖,随后调用`load_dataset('desik98/TeluguRiddles')`即可获取。该数据集主要面向大语言模型的指令微调,支持基于谜语生成答案的核心任务。同时,其指令提示语料特性使其在合成数据生成领域具有重要价值,例如将已有的提示-补全对作为少样本示例,提交至大型开放语言模型,以生成更多谜语及其答案,从而拓展数据规模与多样性。
背景与挑战
背景概述
在自然语言处理领域,低资源语言的语料库建设始终是推动多语言人工智能发展的关键瓶颈。泰卢固语作为印度使用人数众多的语言之一,在机器学习和语言模型训练中却长期缺乏高质量、结构化的指令式数据集。由Cohere For AI发起的Aya开放科学倡议旨在弥合这一鸿沟,而TeluguRiddles数据集正是该倡议下的重要成果。该数据集由Desik98与SuryaKrishna02于近期创建,通过从多个泰卢固语谜语网站进行网络爬取并经过精细预处理,最终构建了超过800条涵盖谜语与答案的指令式记录。其核心研究问题聚焦于为低资源语言提供可用于大语言模型指令微调及合成数据生成的资源,从而增强泰卢固语在人工智能与机器学习领域中的代表性。该数据集采用Apache 2.0许可证开放,允许学术与商业用途,为后续相关研究奠定了坚实基础。
当前挑战
TeluguRiddles数据集所面临的挑战具有双重维度。在领域问题层面,低资源语言普遍缺乏大规模、多样化的监督数据,泰卢固语谜语生成任务不仅要求模型理解语言本身的语义与语法结构,还需掌握谜语特有的隐喻、双关和文化背景知识,这对现有大语言模型的泛化能力构成显著考验。在构建过程中,主要挑战包括:首先,网络爬虫获取的原始数据混杂了噪声字符、重复条目及不完整谜语,需经过严格清洗与筛选;其次,将非结构化谜语转化为统一指令格式时,需要设计恰当的模板以保证输入输出的一致性,同时避免引入语言混杂(如泰卢固语与英语的混合);最后,由于谜语内容可能反映社会偏见或事实错误,数据集的构建需在保持文化丰富性的同时尽力规避敏感或不适当内容,这对数据质量控制提出了更高要求。
常用场景
经典使用场景
TeluguRiddles 数据集专为低资源语言泰卢固语的谜语理解与生成任务而设计,其核心使用场景在于指令微调大型语言模型。通过提供谜面与答案的配对结构,该数据集可用于训练模型在给定谜面时准确生成相应答案,从而提升模型对泰卢固语语义推理和文化语境的理解能力。这种任务范式不仅适用于语言建模,还可作为合成数据生成的基石,例如利用少量示例通过大型开放语言模型扩展生成更多谜语及其解答,进一步丰富低资源语言的训练资源。
衍生相关工作
TeluguRiddles 的发布催生了多项衍生工作,例如在 Aya 开放科学倡议框架下,研究者利用该数据集进行指令微调实验,探索谜语数据对模型推理能力的提升效果。同时,该数据集常被用作基准,对比不同语言模型在泰卢固语谜语生成任务上的表现,并启发后续工作如跨语言谜语迁移学习或基于谜语的数据增强方法。此外,其构建流程(网页抓取、预处理、指令格式化)为其他低资源语言同类数据集的创建提供了可复现的范式,推动了开源社区在低资源语言领域的协作创新。
数据集最近研究
最新研究方向
在低资源语言自然语言处理领域,TeluguRiddles数据集的出现为泰卢固语的指令微调与生成式人工智能研究注入了新的活力。该数据集基于网络爬取的800余条谜语构建,采用指令式模板结构,旨在推动大语言模型在泰卢固语谜语理解与回答生成任务上的能力提升。当前前沿研究聚焦于利用此类高质量、低资源语言数据集进行少样本学习与合成数据扩展,以缓解数据稀缺瓶颈。作为Cohere For AI发起的Aya开放科学倡议的一部分,该数据集不仅支持学术探索,也鼓励商业应用,彰显了开放科学在促进语言多样性、文化传承与AI普惠化方面的重要价值。其发布恰逢多语言大模型竞赛加剧之际,为泰卢固语在人工智能生态中的公平表征提供了实质性支撑。
以上内容由遇见数据集搜集并总结生成


