遇见数据集

NickIBrody/rust-code-suite

收藏
Hugging Face2026-05-20 更新2026-05-31 收录
官方服务:

资源简介:

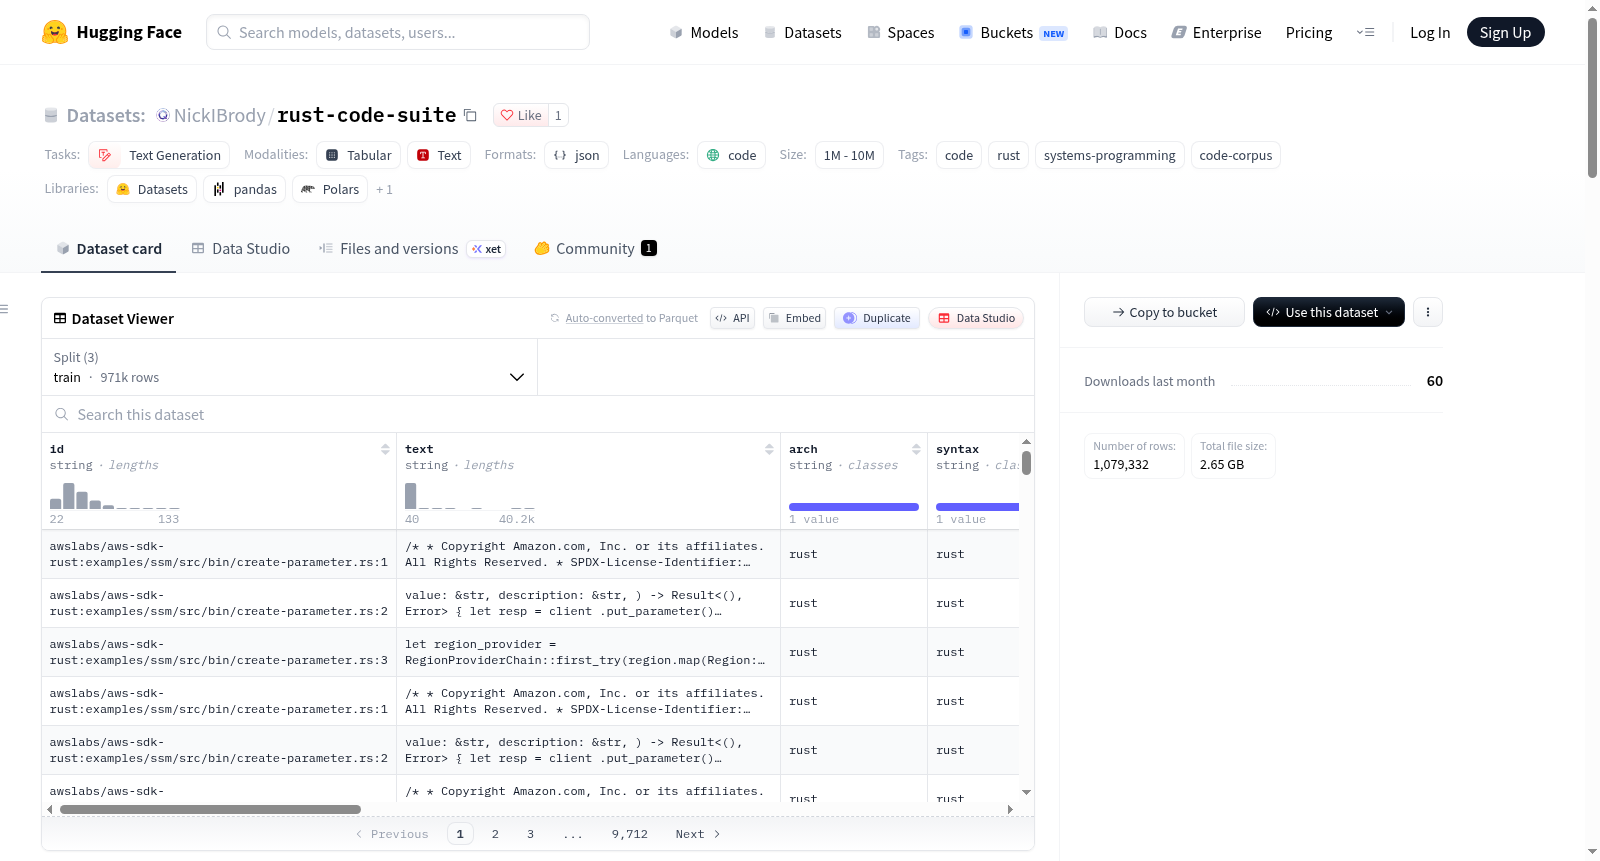
--- pretty_name: Rust Code Suite language: - code tags: - code - rust - systems-programming - code-corpus task_categories: - text-generation size_categories: - 100K<n<1M source_datasets: - original --- # NickIBrody/rust-code-suite Rust Code Suite is a public raw Rust source corpus built from open-source repositories and selected historical git revisions. ## Splits - `train.jsonl` - `validation.jsonl` - `test.jsonl` ## Schema ```json { "id": "owner/repo:path:chunk", "text": "...", "arch": "rust", "syntax": "rust", "kind": "rust-source", "repo": "owner/repo", "path": "src/lib.rs", "license": "GPL-2.0", "commit": "abcdef123456", "source_url": "https://github.com/owner/repo/blob/abcdef123456/src/lib.rs" } ``` ## Build Summary ```json { "total_examples": 1079332, "arch_counts": { "rust": 1079332 }, "syntax_counts": { "rust": 1079332 }, "kind_counts": { "rust-source": 738167, "macro-heavy": 251258, "testsuite": 87434, "inline": 2473 }, "top_repos": [ [ "RustPython/RustPython", 80000 ], [ "rhaiscript/rhai", 80000 ], [ "rust-lang/cargo", 80000 ], [ "rust-lang/rust-analyzer", 80000 ], [ "rust-lang/rust", 80000 ], [ "rustdesk/rustdesk", 80000 ], [ "clap-rs/clap", 77890 ], [ "rust-lang/rustfmt", 77682 ], [ "rust-lang/rust-clippy", 75049 ], [ "serde-rs/serde", 59024 ], [ "tokio-rs/tokio", 57979 ], [ "rust-lang/rustup", 54353 ], [ "hyperium/hyper", 44769 ], [ "awslabs/aws-sdk-rust", 29884 ], [ "mozilla/uniffi-rs", 23585 ], [ "BurntSushi/ripgrep", 21317 ], [ "serde-rs/json", 20506 ], [ "rust-bitcoin/rust-secp256k1", 16189 ], [ "tokio-rs/prost", 11952 ], [ "rust-lang/rustlings", 6059 ] ], "avg_chars": 1887.91, "size_estimate_bytes": 2037683839, "train": 971127, "validation": 54238, "test": 53967 } ```

Rust Code Suite is a public raw Rust source corpus built from open-source repositories and selected historical git revisions.
提供机构:
NickIBrody
搜集汇总
数据集介绍
NickIBrody/rust-code-suite 数据集图片
构建方式
在系统级编程语言语料成为代码智能研究基础设施的背景下,该数据集以公开Rust源码为核心,从开源代码仓库及选定历史git提交中采集原始文件。构建流程围绕仓库快照与版本修订展开,将源文件按内容切分为chunk,并赋予形如owner/repo:path:chunk的唯一标识。每条样本保留repo、path、license、commit与source_url等溯源信息,以支持细粒度追踪。规模方面,合计1,079,332条样本,按train、validation、test划分为971,127、54,238与53,967条,覆盖rust-source、macro-heavy、testsuite与inline等类别,形成面向Rust代码建模的原始语料库。
特点
在代码大模型对多层级语法结构与真实工程语境需求提升的语境下,rust-code-suite展现出显著的领域专精与结构可溯性。其语料全部标注为Rust架构与语法,总样本逾百万,平均长度约1,887.91字符,整体规模约2.04GB。数据囊括常规源码、宏密集代码、测试套件及内联片段,既包含Rust、Cargo、Tokio、Serde等核心项目,也涉及RustPython、Rhai等实现,能够反映系统编程中的宏展开、模块组织与工程测试实践。丰富元数据使样本可按仓库、路径、许可证、提交与类别筛选,兼顾训练价值与合规审查。
使用方法
在代码生成、补全与语言模型预训练任务中,rust-code-suite可借助HuggingFace datasets接口便捷载入,例如load_dataset('NickIBrody/rust-code-suite')后按train、validation、test划分访问。text字段可直接用于因果语言建模、代码续写、微调或评估;id、repo、path、commit、source_url等字段可用于溯源、去重、跨仓库划分与数据审计;license、kind、arch、syntax等字段则支持许可证过滤、类别采样与领域适配。对于本地JSONL文件,亦可通过流式或批量读取方式接入训练管线。使用时应遵循各源仓库许可要求,尊重署名与分发条件。
背景与挑战
背景概述
伴随大语言模型对系统编程代码语料的需求上升,Rust Code Suite作为公开原始Rust源码集合进入代码智能资源版图。该数据集由HuggingFace用户NickIBrody发布,README未标注具体创建时间与所属机构,其内容源自开源仓库及历史git修订,包含1,079,332条样本,训练、验证、测试分别为971,127、54,238、53,967条,规模约2.04GB,平均长度约1,888字符,覆盖rust-lang/rust、cargo、rust-analyzer、clippy、tokio、serde、hyper、ripgrep等代表性项目。其核心研究问题在于为Rust代码生成、补全、理解与静态分析提供大规模、带来源元数据且可追溯的语料,进而支持代码大模型在系统编程语言上的训练与评测,缓解Rust公开训练资源相对稀缺的局面。
当前挑战
Rust的语言特性使代码智能任务超越一般文本建模,Rust Code Suite需回应该语言在语法、语义与工程层面的复杂约束。所解决的领域问题包括代码生成与补全必须尊重所有权、借用、生命周期、trait约束、宏展开、异步执行与unsafe边界,模型输出需接近可编译且语义正确的Rust代码。构建过程中的挑战涉及开源许可证多样性与兼容性审查、历史commit的溯源与去重、训练与测试集之间的数据泄漏控制、函数与文件及代码块粒度的切分平衡、宏密集代码与测试套件及内联片段的异质分布、生成代码和vendor代码及重复片段的过滤,以及百万级样本在清洗、存储、加载和长上下文建模上的工程压力。
常用场景
经典使用场景
在系统编程语言语料库逐渐成为代码智能研究基础设施的语境中,Rust Code Suite 的经典使用场景集中于大规模 Rust 源代码的预训练、继续预训练与代码生成评测。其百万级样本覆盖 rust-lang/rust、cargo、tokio、serde 等核心仓库,并以 owner/repo:path:chunk 标识、commit、license 与 source_url 提供可追溯元数据。研究者借此开展因果语言建模、仓库级代码补全、函数生成、注释合成与跨文件上下文建模,也可利用 macro-heavy、testsuite 等细分类型考察模型对宏系统、测试代码和惯用写法的适应能力。
实际应用
在 IDE 智能补全、代码助手与软件供应链分析等工业实践中,Rust Code Suite 可作为模型训练和领域适配的底层语料。开发者服务可借助其多仓库样本提升 Rust 自动补全、错误修复建议、文档生成与代码搜索效果;安全团队可围绕 Rust 内存安全特性开展缺陷检测与 unsafe 代码审计研究;教育平台可用于示例检索、编程练习生成与学习路径推荐。语料中的测试套件与宏密集片段,亦有助于构建针对构建脚本、过程宏和 crate 生态的专用工具。
衍生相关工作
伴随开源代码语料驱动模型迭代的研究范式,Rust Code Suite 为后续以 Rust 为中心的经典工作提供了数据土壤。相关衍生方向包括代码大模型继续预训练与指令微调、仓库级代码补全基准、宏感知程序分析与生成、测试代码语言模型、代码检索增强生成以及多语言代码迁移研究。围绕其构建的评测任务常关注长上下文、跨文件依赖和真实提交历史下的泛化能力,并推动许可过滤、数据去重、时间切分与污染检测等方法在代码语料治理中的制度化应用。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务