遇见数据集

NYTK/HuRC

收藏
Hugging Face2022-07-07 更新2024-03-04 收录
官方服务:

资源简介:

HuRC(匈牙利阅读理解与常识推理语料库)是匈牙利语言理解评估基准工具包HuLU的一部分。该数据集包含80,614个实例,每个实例由导语、段落和带有掩码实体的填空式查询组成。任务是从查询中选择被掩码的命名实体。数据来源于匈牙利在线新闻网站Népszabadság Online,并通过自动收集和人工验证的方式构建。数据集的语言为匈牙利语,且为单语数据集。数据集分为训练集、验证集和测试集,分别占80%、10%和10%。数据集的创建过程包括使用NER模型识别专有名词,并通过人工验证确保数据质量。数据集发布在cc-by-4.0许可证下。

HuRC (Hungarian Reading Comprehension and Commonsense Reasoning Corpus) is part of the Hungarian Language Understanding Evaluation benchmark toolkit HuLU. This dataset contains 80,614 instances, each consisting of a lead-in, a passage, and a fill-in-the-blank query with a masked named entity. The task is to select the masked named entity from the query. The data is sourced from the Hungarian online news website Népszabadság Online, and was constructed through automatic collection and manual verification. The dataset is in Hungarian and is a monolingual corpus. The dataset is split into training, validation, and test sets, accounting for 80%, 10%, and 10% respectively. The dataset creation process includes using NER models to identify named entities, and manual verification to ensure data quality. The dataset is released under the CC BY 4.0 license.

提供机构:
NYTK
原始信息汇总

数据集概述

数据集名称

  • 名称: HuRC
  • 全称: Hungarian Corpus for Reading Comprehension with Commonsense Reasoning

数据集基本信息

  • 语言: 匈牙利语(hu-HU)
  • 许可证: cc-by-4.0
  • 多语言性: 单语种
  • 数据集大小: 未知
  • 数据来源: 扩展自其他数据集
  • 任务类型: 问答(包括提取式问答和摘要式问答)

数据集结构

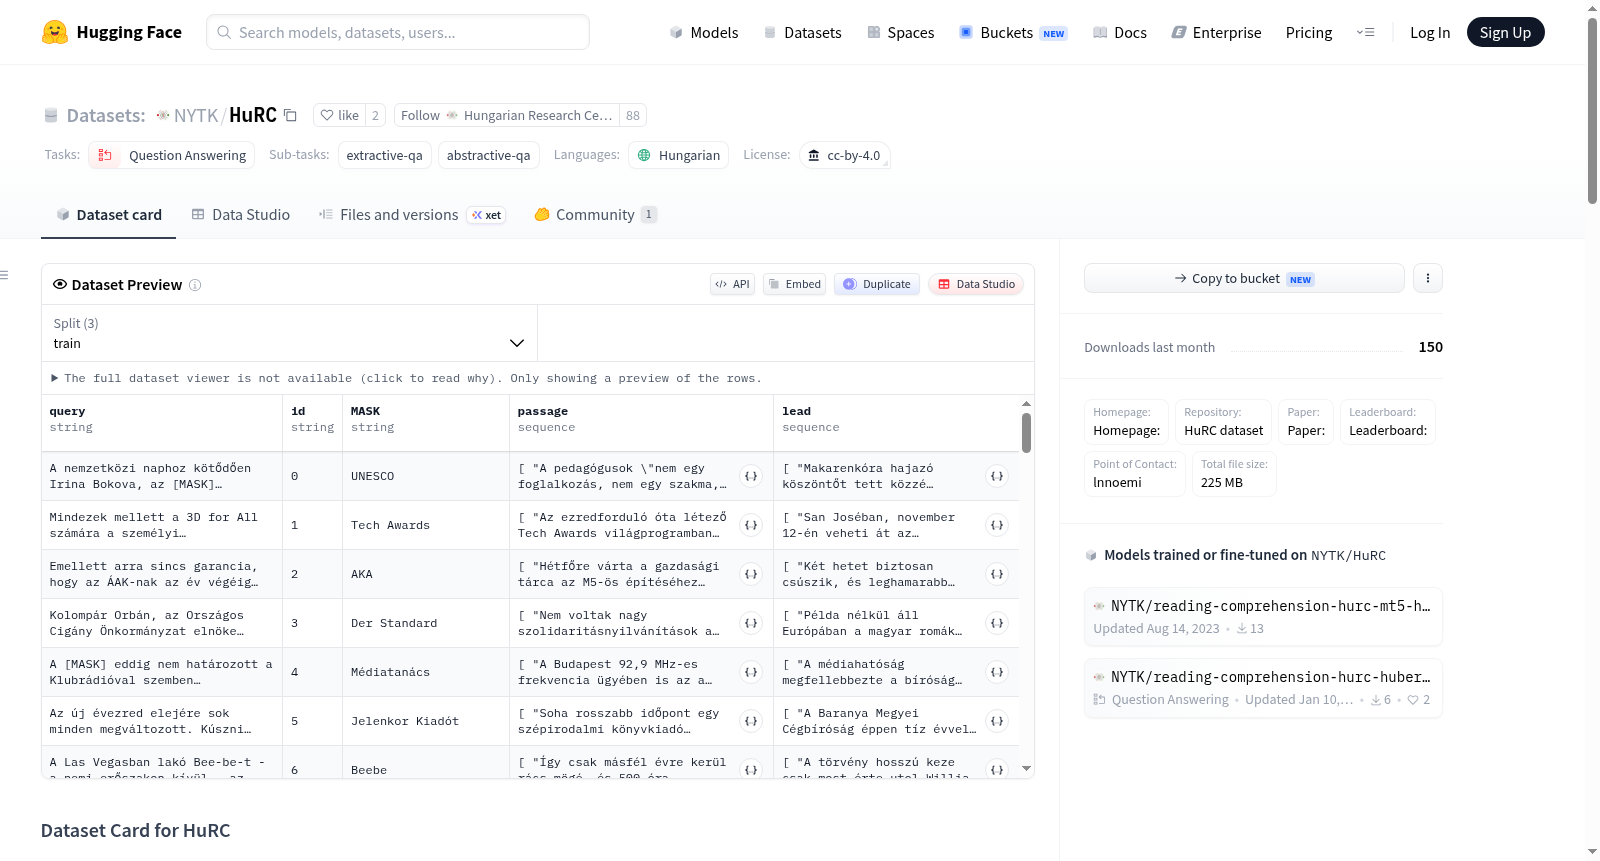
  • 数据实例: 每个实例包含id、lead、passage、query和MASK字段。
  • 数据字段:
    • id: 实例的唯一标识
    • lead: 文章的简短摘要
    • passage: 文章的主体,包含3-6个段落
    • query: 文章的最后一段,包含一个被[MASK]标记的命名实体
    • MASK: 被遮蔽的命名实体
  • 数据分割: 分为训练集、验证集和测试集,比例分别为80%、10%、10%。

数据集创建

  • 数据收集: 数据自动收集自Népszabadság在线新闻。
  • 数据注释: 注释由众包完成,语言部分由发现和专家生成。
  • 数据验证: 每100个单位由一名注释者检查和验证。

附加信息

  • 许可证信息: 数据集根据cc-by-4.0许可证发布。
  • 引用信息: 使用此资源或其任何部分文档时,请参考Ligeti-Nagy等人的论文。

以上信息概述了HuRC数据集的基本情况,包括其语言、许可证、数据结构、创建过程以及如何引用该数据集。
搜集汇总
数据集介绍
NYTK/HuRC 数据集图片
构建方式
在自然语言处理与机器阅读理解领域,高质量的数据集是推动模型性能提升的关键基石。HuRC(Hungarian Corpus for Reading Comprehension with Commonsense Reasoning)数据集应运而生,旨在为匈牙利语的抽取式与抽象式问答任务提供标准化评测基准。该数据集以Népszabadság在线新闻为原始语料,通过自动化流程与人工精细校验相结合的方式构建。首先,利用基于huBERT的命名实体识别模型对新闻文章进行实体标注,筛选出主文与摘要中共同出现的专有名词对。随后,将每篇文章的末段作为查询,并对其中的命名实体进行掩码处理,形成完形填空式问题。最终,经过人工逐条审核与修正,从88,655个初始实例中精选出80,614个高质量样本,确保了数据集的准确性与可靠性。
特点
HuRC数据集在规模与结构上展现出鲜明的特点。其包含80,614个实例,每个实例均由导语、段落文本、掩码查询及掩码实体四部分组成,完整覆盖了从上下文理解到实体推理的全过程。数据集的构建巧妙融合了常识推理要素,查询语句通常为文章的总结或结论,模型需在理解全文语义的基础上预测被掩码的命名实体。此外,数据集按80%、10%、10%的比例划分为训练集、验证集与测试集,其中测试集不公开掩码字段,需通过官方渠道进行模型评估,从而有效防止数据泄露与过拟合,保障了评测的公正性。这种设计不仅适用于传统的抽取式问答,也为探索生成式问答提供了丰富的资源。
使用方法
使用HuRC数据集时,研究人员可借助HuggingFace平台轻松加载与调用。数据集已整合至datasets库中,通过简单的加载指令即可获取训练、验证与测试分片。每个实例以JSON格式存储,包含id、lead、passage、query及MASK字段,便于直接用于序列分类或掩码语言模型的微调。对于测试集的评估,需联系数据集维护团队或通过HuLU平台提交预测结果,以获得标准化的性能指标。该数据集兼容多种主流框架,如Transformers与PyTorch,支持用户自定义模型架构。建议在使用前仔细阅读官方文档与引文信息,以确保数据处理的规范性,并在发表成果时正确引用相关文献,促进匈牙利语自然语言处理研究的可持续发展。
背景与挑战
背景概述
HuRC(Hungarian Corpus for Reading Comprehension with Commonsense Reasoning)是由匈牙利语言技术研究团队于2022年创建的大规模匈牙利语阅读理解数据集,主要研究人员包括Ligeti-Nagy Noémi等来自布达佩斯技术与经济大学和匈牙利科学院计算机科学与控制研究所的学者。该数据集作为HuLU(Hungarian Language Understanding Evaluation Benchmark Kit)基准测试套件的核心组成部分,旨在推动匈牙利语自然语言理解领域的发展。HuRC包含80,614个实例,每个实例由新闻导语、正文段落和基于常识推理的完形填空式查询构成,要求模型从文本中识别被掩码的命名实体。数据来源于Népszabadság在线新闻平台,通过自动化流水线结合命名实体识别技术进行构建,并经过人工校验。该数据集在匈牙利语机器阅读理解与常识推理研究领域具有开创性意义,为低资源语言的神经语言模型评估提供了重要基准。
当前挑战
HuRC所解决的领域问题聚焦于匈牙利语机器阅读理解中的常识推理与命名实体识别联合任务,其核心挑战在于模型需要同时理解文本语义、进行实体消歧并利用外部知识完成推理。构建过程中面临多重困难:首先,从新闻语料中自动提取高质量的篇章-查询对需要精确的命名实体识别模型,研究者使用huBERT微调的NER模型虽达到90.18%的F值,但自动生成的掩码实体仍存在噪声;其次,为确保数据质量,团队对88,655个初始实例进行了逐条人工校验,仅保留80,614个有效条目,剔除了近9%的无效数据,这一过程耗时且成本高昂;此外,测试集以无掩码标签形式发布,要求研究者通过邮件或HuLU平台提交预测结果进行自动评估,增加了模型评测的复杂度。
常用场景
经典使用场景
HuRC(匈牙利语阅读理解与常识推理语料库)是专为评估和提升匈牙利语神经语言模型在抽取式与生成式问答任务上的表现而设计的经典数据集。其核心使用场景在于,通过向模型提供包含新闻导语、正文段落以及掩码实体查询的实例,要求模型从文本中精准识别被遮蔽的命名实体。这一设计不仅考验模型对匈牙利语长文本的语义理解能力,还要求其具备基于上下文进行常识推理的素养,因此常被用作匈牙利语自然语言处理模型基准测试的关键组成部分。
解决学术问题
该数据集有效回应了低资源语言在机器阅读理解领域面临的语料匮乏与标注稀缺的学术困境。通过从在线新闻中自动抽取并人工校验的方式,HuRC构建了超过八万条高质量实例,为匈牙利语命名实体识别与阅读理解研究提供了规模化、标准化的训练与评估资源。其问世填补了匈牙利语在掩码式问答任务上的数据空白,推动了面向小语种的语言模型评测框架(如HuLU基准)的建立,显著促进了非英语语言自然语言处理技术的均衡发展。
衍生相关工作
HuRC的发布催生了一系列围绕匈牙利语神经语言模型评估与微调的研究工作。最直接的衍生成果是HuLU(匈牙利语言理解评估基准套件),该基准将HuRC作为核心任务之一,系统性地衡量不同预训练模型在匈牙利语上的综合能力。此外,研究者基于该数据集探索了跨语言迁移学习的效果,验证了多语言模型(如XLM-R)在匈牙利语掩码问答任务上的泛化潜力。这些工作不仅深化了对小语种模型特性的理解,也为构建更高效的匈牙利语自然语言处理系统奠定了方法论基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务