
temp_nq
收藏官方服务:
资源简介:
该数据集包含多个特征,包括qid(问题ID)、question(问题文本)、answers(答案序列)和ctxs(上下文列表,包含pid、rank、score、text和title)。数据集分为test和validation两个部分,分别包含3610和8757个样本。数据集的总下载大小为46995604字节,总大小为82930477字节。
This dataset includes multiple features, specifically qid (question ID), question (question text), answers (answer sequences), and ctxs (context list containing pid, rank, score, text and title). The dataset is split into two subsets: test and validation, which contain 3610 and 8757 samples respectively. The total download size of the dataset is 46995604 bytes, and the total size is 82930477 bytes.
创建时间:
2024-12-07
原始信息汇总
数据集概述
数据集信息
- 特征:
- qid: 问题ID,数据类型为int64。
- question: 问题内容,数据类型为string。
- answers: 答案序列,数据类型为string。
- ctxs: 上下文列表,包含以下子特征:
- pid: 段落ID,数据类型为int64。
- rank: 排名,数据类型为int64。
- score: 分数,数据类型为float64。
- text: 文本内容,数据类型为string。
- title: 标题,数据类型为string。
数据集分割
- test:
- 字节数: 24273739
- 样本数: 3610
- validation:
- 字节数: 58656738
- 样本数: 8757
数据集大小
- 下载大小: 46995604 字节
- 数据集大小: 82930477 字节
配置
- config_name: default
- 数据文件:
- test: data/test-*
- validation: data/validation-*
- 数据文件:
搜集汇总
数据集介绍
构建方式
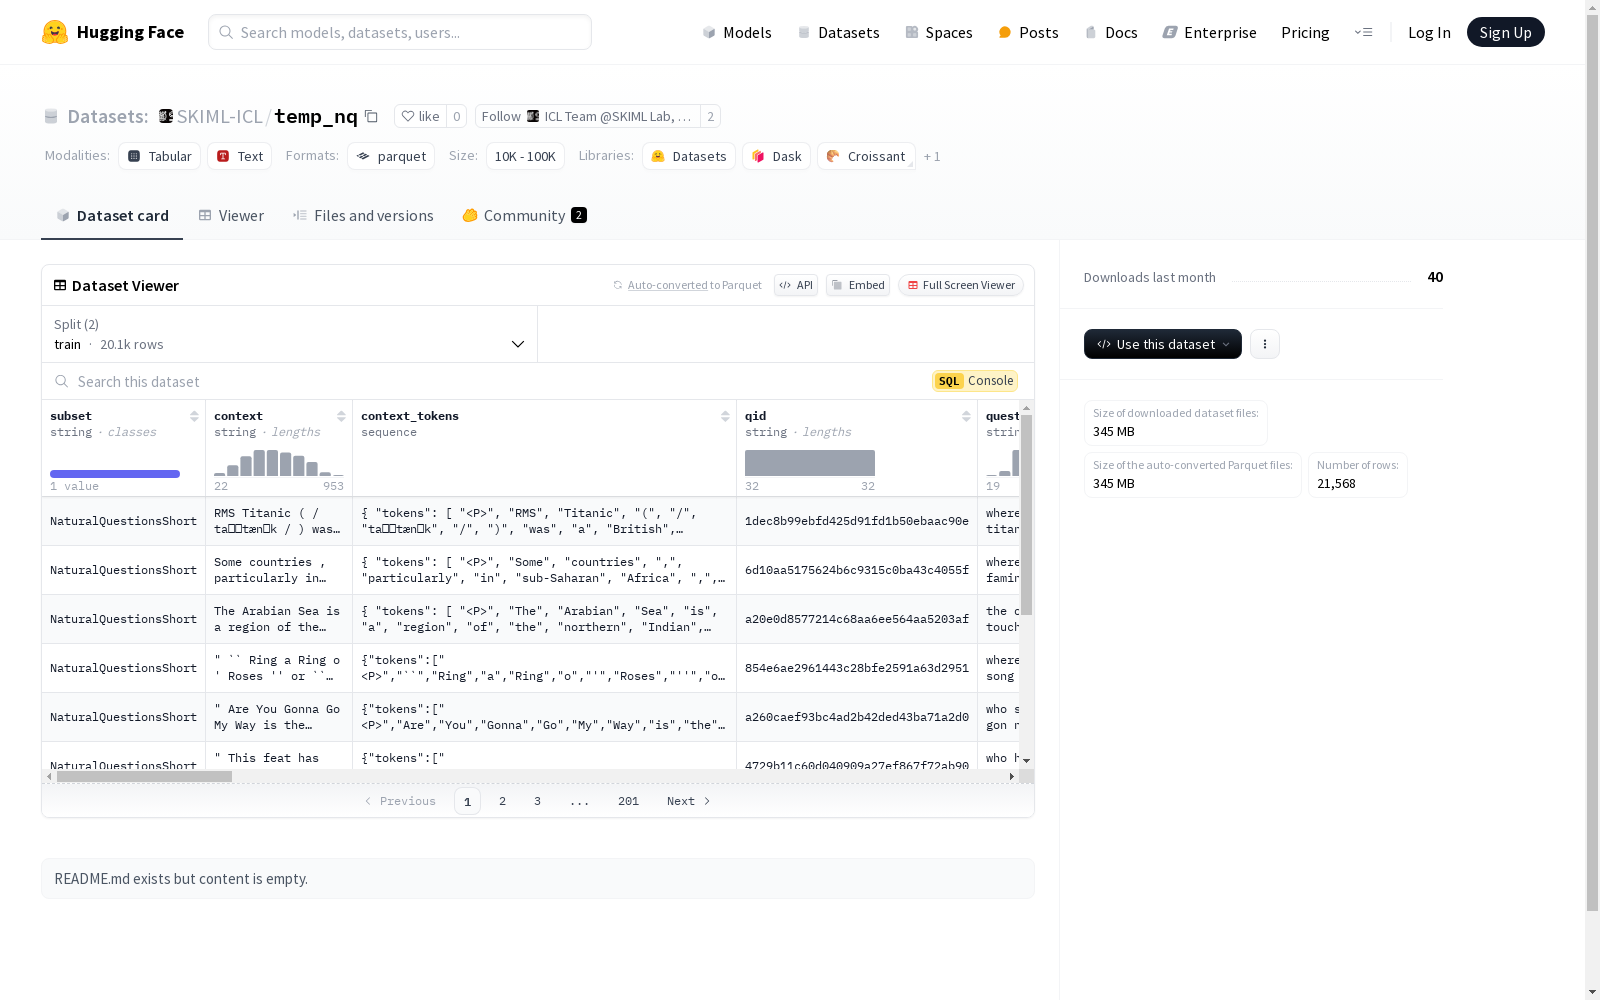
temp_nq数据集的构建基于丰富的自然语言处理任务需求,涵盖了从文本上下文到问题解答的多个维度。该数据集通过精心设计的特征结构,包括上下文、问题、答案及其对应的标记和偏移量,确保了数据的高质量和多样性。此外,数据集还包含了实体类型、相似实体及其得分、冲突句子和上下文等特征,进一步增强了其在复杂问答任务中的应用潜力。
特点
temp_nq数据集的显著特点在于其多层次的特征设计,不仅包含了基础的问答对,还引入了实体识别、相似性评估和冲突检测等高级功能。这些特征使得数据集在处理复杂问答任务时表现出色,能够支持从基础的文本匹配到高级的语义理解等多种应用场景。此外,数据集的分层结构和详细的标注信息,为研究者提供了丰富的实验和分析材料。
使用方法
使用temp_nq数据集时,研究者可以根据具体任务需求选择不同的特征子集进行训练和评估。例如,对于问答系统,可以选择上下文、问题和答案等核心特征;对于实体识别任务,则可以利用实体类型和相似实体特征。数据集提供了详细的文档和示例代码,帮助用户快速上手并进行定制化开发。此外,数据集的分片结构和预处理脚本,也极大地方便了大规模数据处理和模型训练。
背景与挑战
背景概述
temp_nq数据集是由相关领域的研究人员和机构创建的,旨在解决自然语言处理中的问答系统问题。该数据集的核心研究问题是如何从给定的上下文中准确提取答案,并评估问答系统的性能。通过提供丰富的上下文信息、问题、以及对应的答案,temp_nq数据集为研究人员提供了一个标准化的基准,以测试和改进问答模型的准确性和鲁棒性。该数据集的创建时间虽未明确提及,但其对自然语言处理领域的贡献不容忽视,尤其是在问答系统的开发和评估方面。
当前挑战
temp_nq数据集在构建过程中面临了多个挑战。首先,如何从海量的文本数据中提取出高质量的问答对是一个复杂的问题,涉及到文本预处理、信息抽取和答案定位等多个技术环节。其次,数据集中包含了多种类型的答案,包括实体、短语和句子,这增加了模型在不同类型答案上的泛化能力要求。此外,数据集还引入了不可回答问题和冲突上下文,这为模型的鲁棒性和推理能力提出了更高的要求。最后,如何确保数据集的多样性和覆盖广泛的知识领域,也是构建过程中需要克服的挑战。
常用场景
经典使用场景
在自然语言处理领域,temp_nq数据集的经典使用场景主要集中在问答系统的开发与优化。该数据集通过提供丰富的上下文信息、问题及其对应的答案,使得研究者能够训练和评估模型在复杂语境下的问答能力。特别是,通过分析context和question_tokens,研究者可以深入探索如何从大规模文本中准确提取信息,从而提升问答系统的精度和效率。
衍生相关工作
基于temp_nq数据集,研究者们开展了一系列相关工作,推动了问答系统和自然语言处理技术的发展。例如,有研究利用该数据集开发了新的模型架构,以提高答案提取的准确性;还有研究通过分析数据集中的conflict_cases,提出了新的冲突信息处理策略。此外,该数据集还被用于验证多种预训练语言模型的性能,为模型的改进提供了重要参考。
数据集最近研究
最新研究方向
在自然语言处理领域,temp_nq数据集因其丰富的问答对和多样的上下文信息,成为研究问答系统性能提升的重要资源。当前的研究方向主要集中在利用该数据集进行多轮对话问答、跨领域知识迁移以及答案生成模型的优化。这些研究不仅推动了问答系统在实际应用中的准确性和鲁棒性,还为处理复杂语境下的信息检索提供了新的思路。此外,temp_nq数据集的引入也为研究者提供了探索知识图谱与文本信息融合的新途径,从而在智能问答领域开辟了新的研究前沿。
以上内容由遇见数据集搜集并总结生成


