遇见数据集

kubernetes-bad/CivitAI-As-Characters

收藏
Hugging Face2024-02-27 更新2024-03-04 收录
官方服务:

资源简介:

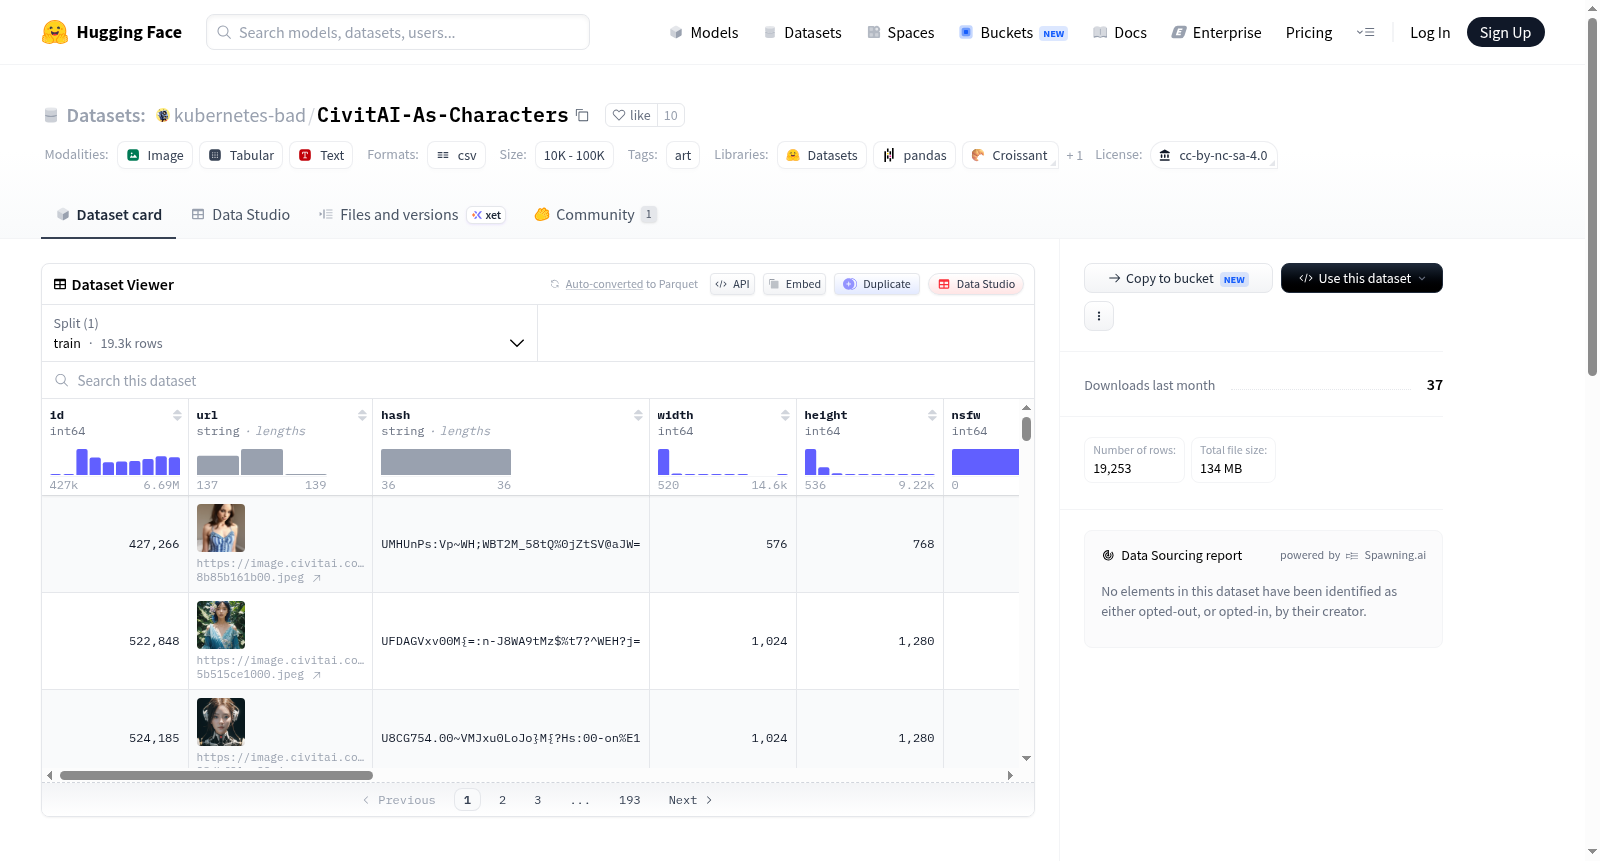
这是一个去重后的CivitAI图像集,这些图像是通过SD XL衍生模型搜索并由Llava1.6-34b模型描述为角色的图像。每张图像都是肖像画,意味着其高度大于宽度,并且每张图像中只有一张人脸。提供了人脸的边界框。每张图像的描述信息由Llava1.6-34b模型生成,包括年龄、眼睛、脸型、发型、名字、故事、性别、衣服、背景和详细描述等。

这是一个去重后的CivitAI图像集,这些图像是通过SD XL衍生模型搜索并由Llava1.6-34b模型描述为角色的图像。每张图像都是肖像画,意味着其高度大于宽度,并且每张图像中只有一张人脸。提供了人脸的边界框。每张图像的描述信息由Llava1.6-34b模型生成,包括年龄、眼睛、脸型、发型、名字、故事、性别、衣服、背景和详细描述等。

提供机构:
kubernetes-bad
原始信息汇总

数据集概述

数据集名称

CivitAI as Characters

标签

  • art

许可证

cc-by-nc-sa-4.0

数据集大小

10K<n<100K

数据集描述

该数据集包含由SD XL-derived模型搜索并由Llava1.6-34b描述为角色的CivitAI图像,且已去重。每个图像都是一幅肖像,即高度大于宽度,并且仅包含一个面部。面部边界框已提供。

图像描述示例

每个图像都有一个由Llava1.6-34b提供的角色类描述。以下是一个示例:

json { "age": "22", "eyes": "Bright blue, striking", "face": "Smooth, elegant, with a gentle expression", "hair": "Long, straight, brown", "name": "Alina", "story": "Alina is a unique blend of human aesthetics and advanced technology. Born in a world where cybernetic enhancements have become an integral part of society, she is the result of a cutting-edge experiment that fused together human and machine components. Rather than being viewed as a freak of nature or a weapon, Alina is seen as a symbol of progress and potential.", "gender": "Female", "clothes": "None visible; her attire is part of her mechanical body", "background": "Dark, void-like, with a hint of cybernetic or futuristic elements", "description": "Alina is a young woman with a striking appearance that seamlessly blends human and mechanical components. Her face is a delicate blend of soft skin and moving parts, ..." }
搜集汇总
数据集介绍
kubernetes-bad/CivitAI-As-Characters 数据集图片
构建方式
在数字艺术与人工智能交汇的当下,角色生成已成为图像合成领域的热点。该数据集源自CivitAI平台,经过精细的去重处理,筛选出由SD XL衍生模型生成且被Llava1.6-34b模型判定为角色图像的样本。每张图像均为竖版肖像,确保高度大于宽度,并严格限定仅包含一张人脸。数据构建过程中,不仅提供了人脸边界框,还借助Llava1.6-34b为每幅图像生成了结构化的角色描述,涵盖年龄、眼睛颜色、面部特征、发型、姓名、背景故事等维度,形成了图像与文本语义的深度对齐。
特点
该数据集的核心特色在于其高度的结构化与语义一致性。所有图像均满足“单人竖版肖像”的严格约束,排除了复杂场景与多人干扰,为角色识别与生成任务提供了纯净的视觉基础。通过Llava1.6-34b生成的描述文本,不仅包含客观属性(如发色、服饰),还融入了叙事性元素(如角色背景故事),使图像与文本的映射超越了简单的标签对应,达到了风格与内涵的双重统一。此外,数据集规模介于1万至10万之间,兼顾了多样性与可控性,适用于细粒度的角色理解与生成研究。
使用方法
该数据集适用于多模态学习与生成式AI研究,尤其适合角色图像描述生成、文本到图像的角色定制以及面部属性分析等任务。使用时,可直接加载图像与对应的JSON格式注释,其中边界框信息可用于局部特征提取,而结构化文本则支持条件式生成模型的训练。研究者可基于这些描述,构建从文本到图像的精准映射,或利用角色背景故事进行叙事驱动的视觉创作。数据集以CC-BY-NC-SA-4.0许可发布,需遵循非商业用途与署名共享的规范,确保学术使用的合规性。
背景与挑战
背景概述
在生成式人工智能与数字艺术交融的浪潮中,CivitAI社区作为Stable Diffusion衍生模型的核心创作与分享平台,催生了海量以角色为中心的肖像画作。为系统化挖掘这些艺术资源的内在叙事潜力,该数据集由研究团队于2023年构建,依托Llava1.6-34b多模态大模型对图像进行角色化描述,旨在弥合视觉艺术与结构化角色档案之间的鸿沟。其核心研究问题聚焦于如何从非结构化艺术图像中提取年龄、外貌、服饰及背景故事等语义信息,从而为计算机视觉、数字人建模及交互式叙事提供标准化数据支撑。该数据集汇集了超过一万张经过去重、筛选的肖像图像,每张均包含精确的人脸边界框与角色描述JSON,显著推动了从艺术生成到角色理解的研究范式转变。
当前挑战
当前数据集面临的核心挑战包括:首先,在领域问题层面,如何从风格化、非写实的AI生成艺术图像中准确提取角色属性(如年龄、情感、机械部件描述)仍是一个开放性问题,因Llava模型对艺术夸张与抽象风格的解读存在语义偏差。其次,构建过程中遭遇了多重技术障碍:从CivitAI海量图像中筛选出严格满足‘单人、竖构图、唯一人脸’条件的样本需依赖复杂的人脸检测与构图分析算法;去重阶段需应对相同角色在不同生成参数下的细微变异,导致相似性度量的边界模糊;此外,Llava1.6-34b生成的描述存在幻觉风险,例如将机械部件误判为服装,需引入人工校验与对抗性过滤机制以确保数据质量。
常用场景
经典使用场景
在生成式人工智能与数字艺术交叉领域,CivitAI-As-Characters数据集为基于文本到图像扩散模型的人物角色生成研究提供了标准化基准。该数据集精选自CivitAI平台经SD XL衍生模型生成的肖像图像,每幅图像均满足人像构图(高度大于宽度)且包含单一人脸,并附带由Llava1.6-34b模型生成的精细化角色描述,涵盖年龄、瞳色、发型、服饰乃至背景故事等结构化信息。研究者可借此系统性地评估扩散模型在保持角色一致性与细节保真度方面的表现,尤其适用于探索多模态描述如何引导生成具有个性化特征的艺术角色。
解决学术问题
该数据集直面当前文本到图像生成领域的两大学术困境:其一是缺乏高质量、去重且带有人脸边界框标注的角色肖像数据集,导致角色生成研究难以量化评估;其二是现有数据集多缺少细粒度的结构化角色描述,限制了多模态对齐与角色属性控制的探索。通过提供10K至100K规模、经严格预处理的图像-描述对,CivitAI-As-Characters有效支撑了可控人物生成、角色属性解耦、以及基于故事背景的连贯角色创作等研究方向。其意义在于为生成模型的角色一致性、身份保持与语义可控性设立了可复现的评测基线,推动了艺术风格与人工智能深度融合的学术进展。
衍生相关工作
该数据集衍生了一系列推动文本到图像生成边界的重要工作。基于其结构化角色描述,研究者提出了角色感知的扩散模型微调方法,如利用描述中的故事字段实现跨场景角色身份迁移;另有工作借鉴其肖像构图约束,开发了面向人脸生成的位置感知注意力机制。在评估层面,该数据集催生了角色一致性度量的新指标,通过对比生成图像与描述中属性字段的匹配度来量化模型性能。此外,部分研究以其为训练数据,探索了从结构化描述到多视角角色渲染的端到端框架,为虚拟角色资产管线自动化提供了关键支撑。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务