
privelabs/csharpdata
收藏官方服务:
资源简介:
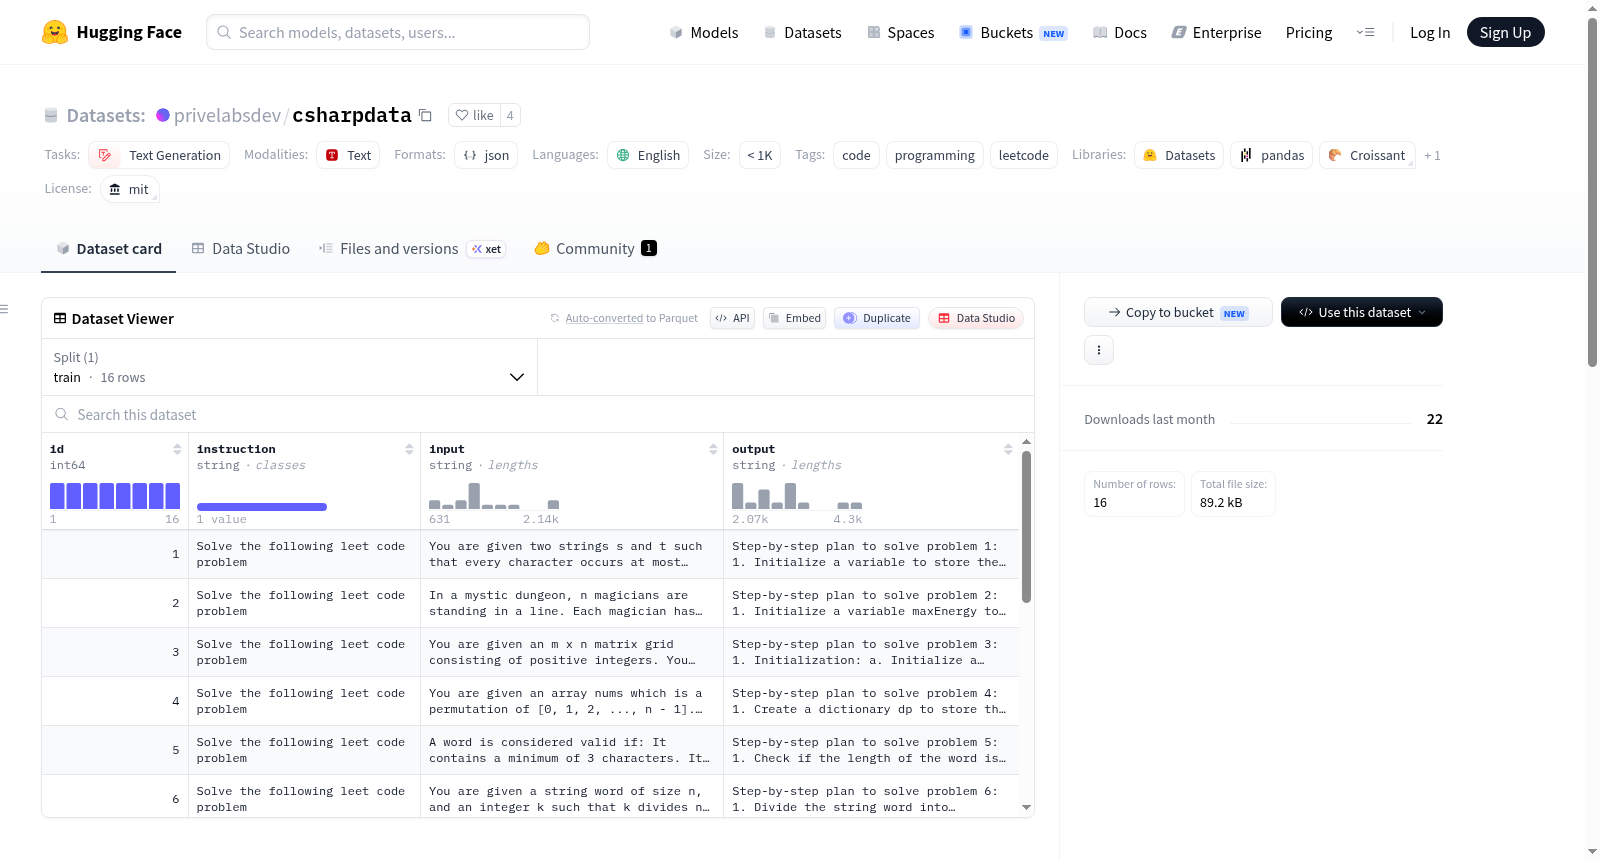
该数据集包含LeetCode问题,包括问题陈述、输入和解决方案。它适用于训练代码生成模型和研究算法问题。数据集的结构包括每个实例的唯一标识符、问题陈述、输入和解决方案。数据集支持的任务是文本生成,语言为英语。
该数据集包含LeetCode问题,包括问题陈述、输入和解决方案。它适用于训练代码生成模型和研究算法问题。数据集的结构包括每个实例的唯一标识符、问题陈述、输入和解决方案。数据集支持的任务是文本生成,语言为英语。
提供机构:
privelabs原始信息汇总
数据集概述
数据集名称
LeetCode Problems Dataset
数据集描述
该数据集包含LeetCode问题,包括问题描述、输入和解决方案。适用于训练代码生成模型和研究算法问题。
数据集特征
id: 问题唯一标识符,数据类型为int64。instruction: 问题描述或指令,数据类型为string。input: 问题输入,数据类型为string。output: 解决方案或预期输出,数据类型为string。
数据集结构
数据实例
每个实例包含以下字段:
idinstructioninputoutput
示例
json { "id": 1, "instruction": "Solve the following leet code problem", "input": "You are given two strings s and t such that every character occurs at most once in s and t is a permutation of s. ...", "output": "Step-by-step plan to solve problem 1: ..." }
数据集大小
- 训练集大小:16个示例,总大小为65951字节。
- 数据集下载大小:65951字节。
- 数据集总大小:65951字节。
支持的任务
text-generation: 用于训练模型根据问题描述生成代码片段。
语言
- 英语 (
en)
标签
- 代码 (
code) - 编程 (
programming) - LeetCode (
leetcode)
许可证
- MIT
搜集汇总
数据集介绍
构建方式
该数据集基于LeetCode在线编程平台上的算法问题构建而成,涵盖了问题描述、输入数据以及对应的解决方案。数据集中每条样本包含唯一标识符、指令(即问题陈述)、输入和输出四个字段,共计16条训练样本。数据集以JSON格式存储,并采用MIT许可证开放使用,便于研究者进行代码生成模型的训练与评估。
使用方法
用户可通过HuggingFace Datasets库直接加载该数据集,使用默认配置即可获取训练集。数据集适用于文本生成任务,尤其是代码生成场景。研究者可将指令与输入作为模型输入,输出作为目标序列,进行序列到序列的模型训练。数据集支持Python等编程语言的数据处理流程,便于集成到现有的机器学习工作流中。
背景与挑战
背景概述
在自然语言处理与代码生成交叉领域,利用大规模编程问题数据集训练模型已成为提升算法推理能力的关键路径。privelabs/csharpdata数据集由PriveLabs团队于近年构建,专注于收录LeetCode平台上的C#编程问题,包含问题陈述、输入及解决方案,旨在为代码生成模型提供高质量的微调与评估资源。该数据集以16个精心挑选的实例构成训练集,覆盖多种算法题型,其核心研究问题聚焦于如何借助结构化编程问题增强模型对算法逻辑的理解与生成能力。作为面向C#语言的专项数据集,它在推动编程语言模型在多语言适配与算法任务上的表现方面具有独特价值,尤其为研究代码智能的学者提供了可复现的基准数据源。
当前挑战
该数据集面临的挑战首先体现在领域问题层面,即如何使模型从有限的示例中泛化至复杂多变的算法场景,当前16个实例的规模难以覆盖LeetCode问题的多样性,易导致过拟合或生成能力不足。构建过程中,数据收集需确保问题表述与解决方案的准确性和一致性,但LeetCode问题版本迭代频繁,原始来源的格式差异增加了清洗难度;此外,C#语言特有的语法特性与库函数使用需在解决方案中精准呈现,这对数据标注的领域知识要求较高。同时,数据集仅包含单轮指令-输出对,缺乏对多步推理或交互式调试的支持,限制了其在复杂代码生成任务中的适用性。
常用场景
经典使用场景
在自然语言处理与代码智能的交叉领域中,privelabs/csharpdata数据集凭借其精心编排的LeetCode问题结构,成为训练代码生成模型的经典语料。该数据集将编程问题拆解为指令、输入与输出三元组,为模型提供了从问题描述到解决方案的端到端学习范式。研究者常将其用于微调大型语言模型,使其掌握从自然语言需求中推导出正确C#代码的逻辑链条,尤其适用于探究算法问题理解与代码合成之间的映射关系。
解决学术问题
该数据集直击代码智能领域的两大核心学术挑战:其一,如何弥合自然语言与编程语言之间的语义鸿沟,使模型能精准解析问题陈述中的约束与目标;其二,如何评估模型在复杂算法推理中的泛化能力。通过提供涵盖多种算法主题的标准化问题,它为对比不同架构(如Transformer变体)在代码生成任务上的表现提供了基准,推动了少样本学习与指令微调等前沿方法的发展。
实际应用
在实际工程场景中,该数据集赋能了自动化编程辅助工具的开发,例如集成开发环境中的智能代码补全与错误修复模块。基于它训练的模型能够根据开发者输入的简短问题描述,实时生成可运行的C#函数骨架,显著提升编码效率。此外,其结构化格式也适用于教育领域,用于构建自适应编程练习系统,为学生提供即时反馈与解题思路。
数据集最近研究
最新研究方向
在代码生成与算法推理的前沿领域,LeetCode问题数据集正成为评估大语言模型编程能力的关键基准。随着ChatGPT、Codex等模型在自动化编程任务中崭露头角,研究者们开始关注模型对复杂算法逻辑的泛化能力,而该数据集提供的指令-输入-输出三元组结构恰好契合了从自然语言描述到代码实现的端到端学习范式。当前热点方向聚焦于利用此类结构化编程题库探索模型在零样本推理、多步解题规划以及代码鲁棒性方面的表现,同时推动着面向算法竞赛的智能辅导系统与自动化代码审查工具的发展。该数据集的出现不仅为代码生成领域提供了标准化的评估语料,更在促进编程教育智能化、降低算法学习门槛方面具有深远意义。
以上内容由遇见数据集搜集并总结生成


