遇见数据集

mehrankazemi/ReMI

收藏
Hugging Face2024-06-19 更新2024-06-15 收录
官方服务:

资源简介:

ReMI数据集在论文《ReMI: A Dataset for Reasoning with Multiple Images》中引入,包含13个任务,分别是:EmojiAlgebra、FuncRead、GeomShape、GeomCost、Collisions、Clocks、Schedule、Charts、CodeEdit、Isomorphism、Maps、RefCOCO和IQ。数据集主要用于多图像推理,数据分为训练集和测试集,训练集包含每个任务的2个示例,测试集包含每个任务的200个示例。数据格式包括问题、标签、任务和图像字段。数据来源包括可视化库、Google Maps截图和COCO图像。数据集主要用于测试,禁止用于训练。

The ReMI dataset was introduced in the paper *ReMI: A Dataset for Reasoning with Multiple Images*. It comprises 13 tasks, namely EmojiAlgebra, FuncRead, GeomShape, GeomCost, Collisions, Clocks, Schedule, Charts, CodeEdit, Isomorphism, Maps, RefCOCO, and IQ. This dataset is primarily designed for multi-image reasoning tasks, and is split into training and test subsets. Each task contains 2 training examples and 200 test examples. The dataset includes four core data fields: question, label, task, and image. Data sources include visualization libraries, Google Maps screenshots, and COCO images. This dataset is exclusively intended for evaluation purposes and shall not be used for training.

提供机构:
mehrankazemi
原始信息汇总

数据集描述

ReMI 是一个多模态问答数据集,包含13个任务:EmojiAlgebra, FuncRead, GeomShape, GeomCost, Collisions, Clocks, Schedule, Charts, CodeEdit, Isomorphism, Maps, RefCOCO, 和 IQ。

数据集使用

数据下载

数据集分为两个子集:train 和 test。

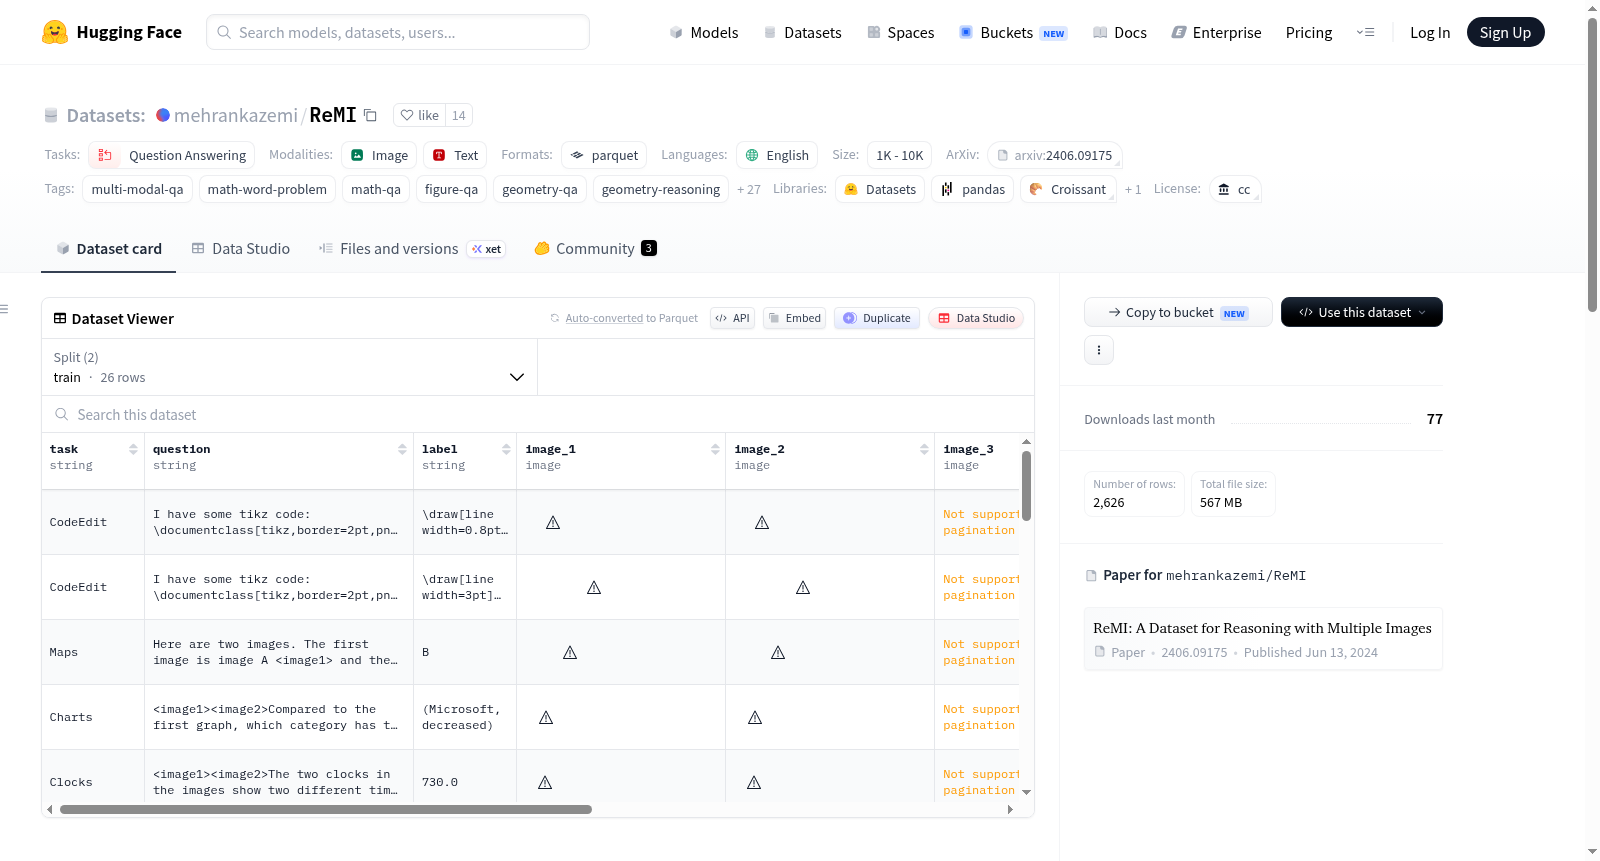
  • train: 每个任务包含2个示例(共26个),用于fewshot示例。
  • test: 每个任务包含200个示例(共2600个),用于评估。

下载数据集需要安装 Huggingface Datasets,然后使用以下命令:

python from datasets import load_dataset

dataset = load_dataset("mehrankazemi/ReMI")

数据格式

数据集包含以下字段:

  • question: 包含问题的文本,问题中包含<image1>、<image2>等标签,应替换为第i个图像。
  • label: 包含问题的答案。
  • task: 对应数据集中的13个任务之一。
  • image_i: (i在[1, 6]范围内)包含第i个图像的字节。

数据来源

ReMI 通过以下方式创建:1- 使用matplotlib等可视化库,渲染LaTeX中的TikZ代码,NetworkX等,2- 从Google Maps截图,3- 从COCO获取图像。

  • 目的: ReMI主要设计为测试集。
  • 禁止: 禁止将ReMI用作训练集。

引用

@article{kazemi2024remi, title={ReMI: A Dataset for Reasoning with Multiple Images}, author={Kazemi, Mehran and Dikkala, Nishanth and Anand, Ankit and Devic, Petar and Dasgupta, Ishita and Liu, Fangyu and Fatemi, Bahare and Awasthi, Pranjal and Guo, Dee and Gollapudi, Sreenivas and Qureshi, Ahmed}, journal={arXiv preprint arXiv:2406.09175}, year={2024} }
搜集汇总
数据集介绍
mehrankazemi/ReMI 数据集图片
构建方式
在多模态推理研究的前沿领域,图像与文本的协同理解一直是核心挑战。ReMI数据集专为多图像推理任务而设计,其构建过程融合了多种技术手段:部分数据通过可视化库(如matplotlib)、LaTeX中的TikZ代码以及NetworkX等工具自动生成,确保了几何图形、函数图像与图论问题的多样性;另一部分则通过截取Google Maps屏幕截图与利用COCO数据集中的真实图像,引入了空间导航与视觉语义理解的真实场景。数据集的13个子任务(如EmojiAlgebra、GeomShape、Charts等)覆盖了从代数推理到时间空间理解的广泛认知维度,每个任务包含200个测试样本与2个少样本示例,总计2600个测试样本,形成了结构严谨的评估基准。
特点
ReMI数据集的核心特点在于其多图像推理的独特设计。每个样本包含2至6张图像,通过<image_i>标签嵌入问题文本,要求模型在理解多张图像间逻辑关系的基础上进行回答。数据集覆盖13种推理类型,包括代数、几何、物理碰撞、时间算术、代码编辑与图表理解等,展现了跨领域的认知复杂性。值得注意的是,ReMI明确禁止作为训练集使用,仅作为测试基准,这确保了其在评估多模态大模型泛化能力时的纯净性。此外,样本来源的混合性(合成数据+真实截图+已有数据集)平衡了可控性与生态效度,使得任务既具备结构化的推理路径,又贴近实际应用中的视觉多样性。
使用方法
使用ReMI数据集需通过HuggingFace Datasets库加载,调用`load_dataset('mehrankazemi/ReMI')`即可获取训练集与测试集。加载后,每个样本包含`question`(含图像占位符)、`label`(答案)、`task`(任务类型)及`image_i`(图像字节数据)字段。使用时需将问题中的<image_i>标签替换为对应的图像张量。官方提供了基于Colab的评估脚本,便于复现论文中的评测流程。由于数据集专为测试设计,用户应避免将其纳入训练流程,以确保基准测试的公正性。开发者可通过替换图像占位符与解析多模态输入,灵活适配各类视觉-语言模型架构。
背景与挑战
背景概述
在人工智能领域,多模态推理能力是迈向通用智能的关键里程碑。2024年,由Mehran Kazemi领衔,联合来自Google Research等机构的研究人员共同发布了ReMI数据集,旨在评估和推动模型在多图像输入场景下的推理能力。该数据集涵盖了13项精心设计的任务,包括代数推理、几何推理、时间推理、空间理解及图表分析等,显著拓展了传统视觉问答的边界。ReMI的核心研究问题在于:模型能否整合来自多个视觉信息源的知识,进行跨图像的逻辑推导与问题求解。其发布为多模态大语言模型的评估提供了极具挑战性的基准,深刻影响了该领域对模型综合推理能力的衡量标准。
当前挑战
ReMI数据集所解决的领域问题核心在于多图像推理,这要求模型不仅理解单张图像的内容,更要建立图像间的关联与逻辑链条。当前面临的挑战包括:1) 模型在处理多图像输入时,难以有效对齐和融合来自不同视觉源的信息,导致跨图像关系推理错误频发;2) 构建过程中,数据集需确保每项任务都涉及至少两张图像的协同使用,且图像生成方式多样(如matplotlib渲染、地图截图、COCO图像),这带来了数据格式统一与标注质量控制的难题;3) 部分任务如时间推理和空间理解,要求模型具备对现实世界常识的深刻理解,而现有模型在抽象符号与具体视觉元素间的映射能力上仍显不足,限制了其在复杂多模态推理场景中的泛化表现。
常用场景
经典使用场景
ReMI数据集专为多图像推理任务而设计,涵盖13个具挑战性的子任务,如几何形状推理、图表解读、地图理解、时间算术与代码编辑等。其核心使用场景在于评估多模态大模型在跨图像信息整合与逻辑推断方面的能力,尤其关注模型能否将分散于多幅图像中的视觉线索进行关联与综合,从而得出准确结论。该数据集以测试集形式呈现,每任务包含200个样本,共计2600例,为多图像推理提供了一个标准化、高难度的评测基准。
实际应用
在实际应用中,ReMI所定义的推理能力对多个行业具有直接价值。例如,在自动化图表分析中,模型需同时解读多张折线图与柱状图以推断趋势;在地理信息系统中,需结合多幅地图片段进行路径规划;在教育辅导领域,模型需根据几何图形与代数表达式联合求解问题。此外,代码编辑任务中模型需对比多段代码差异以定位错误,这为智能编程助手的开发提供了评测依据。这些场景均要求模型具备跨图像的综合推理能力,ReMI正是检验此类能力的理想基准。
衍生相关工作
ReMI的提出催生了一系列衍生研究,主要集中在多图像推理模型的架构设计与训练策略优化方面。研究者基于该数据集探索了图像序列编码器、跨图像注意力机制以及多模态融合模块的改进方案。部分工作借鉴ReMI的任务分类,构建了针对特定子任务(如几何推理、图表问答)的专用模型,并利用其测试集进行性能验证。此外,ReMI也被用作多模态大模型评估套件的重要组成部分,与MMMU、MathVista等数据集互补,共同推动视觉语言模型在复杂推理任务上的进步。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务