遇见数据集

TheGreatRambler/mm2_user

收藏
Hugging Face2022-11-11 更新2024-03-04 收录
官方服务:

资源简介:

Mario Maker 2用户数据集包含来自任天堂在线服务的600万用户数据,总计约1.2GB。该数据集是通过自托管的Mario Maker 2 API在2022年2月的一个月内收集的。每行数据代表一个唯一的用户,包含用户的ID、地区、名称、国家、最后活跃时间、Mii数据、Mii图像、服装信息、游戏统计信息等。数据集还包含一些枚举字段,用于将整数转换为对应的字符串描述。数据集仅包含训练集,且没有计划更新此数据集。

The Mario Maker 2 User Dataset consists of 6 million user records obtained from Nintendo's online services, with an overall size of approximately 1.2 GB. This dataset was collected over a one-month period in February 2022 using a self-hosted Mario Maker 2 API. Each row in the dataset corresponds to a single unique user, and includes fields such as user ID, region, username, country, last active timestamp, Mii data, Mii images, clothing information, and game statistics. The dataset also features several enumeration fields that map integer values to their respective string representations. This dataset only includes a training set, with no future updates planned.

提供机构:
TheGreatRambler
原始信息汇总

数据集概述

基本信息

  • 名称: Mario Maker 2 users
  • 语言: 多语言
  • 许可证: cc-by-nc-sa-4.0
  • 多语言性: 多语言
  • 大小: 1M<n<10M
  • 源数据集: 原始数据
  • 任务类别: 其他、物体检测、文本检索、令牌分类、文本生成
  • 标签: 文本挖掘

数据集描述

  • 内容: 包含600万来自Nintendo在线服务的用户数据,总数据量约1.2GB。
  • 采集时间: 2022年2月,持续约1个月。
  • API使用: 使用自托管的Mario Maker 2 API进行数据收集。

数据结构

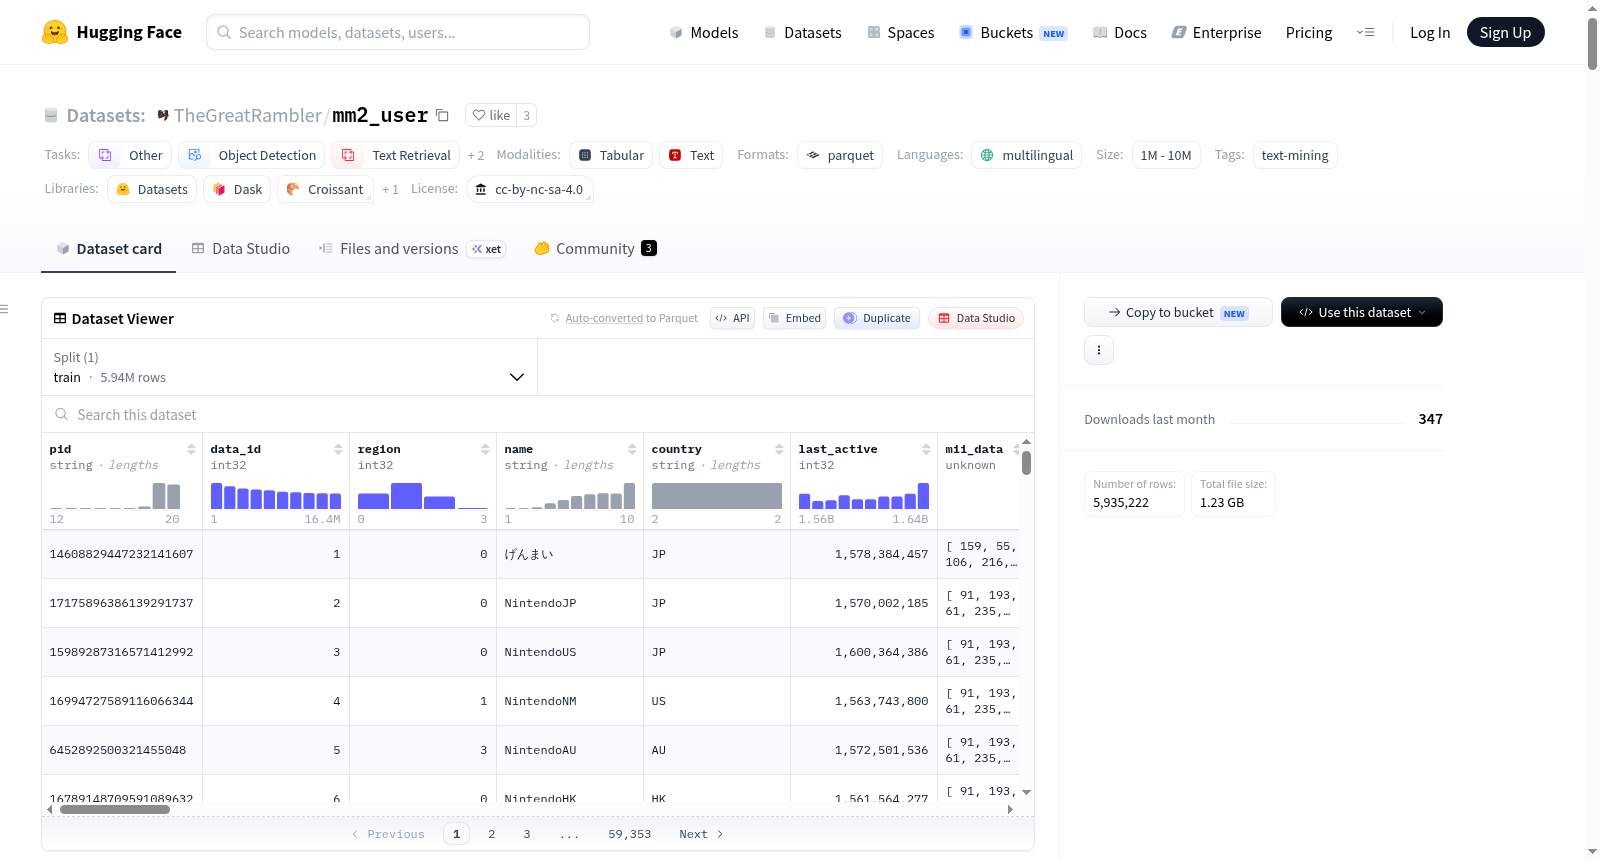
  • 数据实例: 每个实例代表一个用户,包含用户ID、数据ID、区域、名称、国家、最后活跃时间、Mii数据、Mii图像等信息。
  • 数据字段: 包括pid、data_id、region、name、country等,详细描述了用户的游戏行为和属性。
  • 数据分割: 仅包含训练集。

使用方法

  • 加载数据: 推荐使用datasets库的流式API加载数据。
  • 示例代码: 提供Python代码示例,展示如何加载和迭代数据集。

注意事项

  • 数据敏感性: 用户名称和Mii图像可能包含有害内容。
  • 数据更新: 目前无更新该数据集的计划。

数据集创建

  • 创建时间: 2022年2月。
  • 创建方法: 通过自托管的Mario Maker 2 API收集数据,注意避免对Nintendo服务器造成过载。
搜集汇总
数据集介绍
TheGreatRambler/mm2_user 数据集图片
构建方式
在电子游戏行为分析领域,用户数据集是理解玩家生态的关键资源。该数据集源自任天堂旗下游戏《超级马里奥制造2》的在线服务,由研究者利用自建的Mario Maker 2 API,在2022年2月历时一个多月精心采集而成。由于任天堂服务器要求身份验证,采集过程需严格控制请求速率,以避免触发封禁风险,最终成功获取了约600万用户的详尽信息,数据总量约1.2GB。数据集构建过程中,未计划进行后续版本更新,确保原始数据的稳定性和可复现性。
特点
该数据集以用户为核心,每个条目通过唯一标识符pid区分玩家,包含丰富的属性字段。不仅涵盖基础信息如地区、国家、用户名和Mii形象数据,还深入记录了游戏行为指标,例如游玩关卡数、通关次数、死亡次数、获得的赞数以及制造点数。此外,数据集还囊括了多人对战模式(如排位、胜场、连败记录)和合作模式(如通关次数)的细致数据,以及玩家上传关卡、超级世界和每周表现等信息。这些多维度的特征为研究玩家行为模式、技能分布和社交互动提供了宝贵素材。
使用方法
鉴于数据集规模庞大,推荐采用HuggingFace datasets库的流式加载API以高效处理。用户可通过`load_dataset("TheGreatRambler/mm2_user", streaming=True, split="train")`代码迭代访问,每行返回一个字典,包含pid、data_id、region等字段。Mii图像可通过Nintendo Studio API利用mii_image字段生成,而pose、hat、shirt等枚举字段可通过预定义字典转换为可读字符串。对于需要全量分析的任务,可直接下载完整数据集(约1.2GB),但需注意仅包含训练集拆分,无验证或测试集。
背景与挑战
背景概述
《超级马力欧制造2》(Super Mario Maker 2)作为任天堂旗下极具创意的游戏平台,允许玩家设计并分享自定义关卡,形成了庞大的用户生成内容生态。该游戏自2019年发布以来,吸引了全球数百万玩家参与创作与互动,催生了丰富的玩家行为数据。在此背景下,由独立研究者TheGreatRambler于2022年2月耗时约一个月,通过自建的Mario Maker 2 API从任天堂在线服务中爬取并构建了TheGreatRambler/mm2_user数据集。该数据集收录了约600万用户信息,涵盖区域、游戏表现、装扮、社交互动等多维度字段,总量约1.2GB,为游戏行为分析、用户画像建模及人机交互研究提供了宝贵的基础资源。
当前挑战
该数据集面临多重挑战。首先,在领域问题层面,其核心研究难题在于如何从海量稀疏且异构的用户行为数据中提取有意义的模式,例如玩家技能水平评估、关卡偏好预测及社交网络演化分析,这对特征工程与模型泛化能力提出了高要求。其次,在构建过程中,数据采集需通过任天堂认证接口,面临严格的速率限制与封禁风险,迫使研究者以极低速度谨慎爬取,耗时超一个月。此外,用户名称与Mii形象可能包含有害语言或不当描绘,带来了数据伦理与隐私保护的潜在争议,需在后续使用中审慎处理。
常用场景
经典使用场景
在游戏用户行为分析领域,TheGreatRambler/mm2_user数据集被广泛用于研究大型多人在线游戏中的玩家行为模式。该数据集包含了约600万《超级马力欧制造2》玩家的详尽档案信息,涵盖游戏成就、对战记录、合作通关次数、关卡上传偏好等多维指标。研究者可借此剖析玩家的技能分布曲线、探索不同地区玩家的行为差异,或构建用户画像模型以预测玩家流失倾向。其丰富的枚举字段(如角色装扮、表情姿势)为游戏内文化现象研究提供了独特视角。
解决学术问题
该数据集有效解决了游戏研究中大规模真实用户数据匮乏的难题。传统游戏行为研究多依赖小样本问卷或实验室环境,而此数据集提供了自然场景下数百万玩家的真实交互记录,使学者得以量化分析玩家技能水平与关卡设计复杂度之间的关联、探索对战匹配机制对用户留存的影响,以及揭示社交功能(如评论、标签)如何塑造游戏社区生态。这些发现为游戏平衡性理论、用户激励机制设计等学术议题提供了实证基础。
衍生相关工作
该数据集衍生了一系列开创性研究,包括基于玩家行为序列的关卡难度预测模型、利用图神经网络分析玩家社交网络结构的社区发现工作,以及结合多模态数据(Mii图像与行为特征)的玩家身份识别算法。部分工作进一步将其与同系列关卡数据集(如TheGreatRambler/mm2_level)联合使用,构建了从用户行为到内容创作的完整分析链路,推动了游戏内用户生成内容(UGC)生态系统的量化研究。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务