
ontocord/CulturaY
收藏官方服务:
资源简介:
CulturaY是一个包含75种语言的大型多语言文本数据集,数据来源于HPLT v1.1项目,并经过严格的清洗流程。数据集的主要列包括`text`和`url`,其他列保留用于调试。数据集的创建过程基于Bloom的数据清洗管道,评估每个文档的多个标准。数据集的使用许可为CC-BY-4.0,适用于机器学习研究。
CulturaY是一个包含75种语言的大型多语言文本数据集,数据来源于HPLT v1.1项目,并经过严格的清洗流程。数据集的主要列包括`text`和`url`,其他列保留用于调试。数据集的创建过程基于Bloom的数据清洗管道,评估每个文档的多个标准。数据集的使用许可为CC-BY-4.0,适用于机器学习研究。
提供机构:
ontocord原始信息汇总
CulturaY 数据集概述
数据集配置
CulturaY 数据集包含以下语言配置:
- af: 南非荷兰语
- ar: 阿拉伯语
- az: 阿塞拜疆语
- be: 白俄罗斯语
- bg: 保加利亚语
- bn: 孟加拉语
- ca: 加泰罗尼亚语
- cs: 捷克语
- cy: 威尔士语
- da: 丹麦语
- de: 德语
- el: 希腊语
- en: 英语
- eo: 世界语
- es: 西班牙语
- et: 爱沙尼亚语
- eu: 巴斯克语
- fa: 波斯语
- fi: 芬兰语
- fr: 法语
- ga: 爱尔兰语
- gl: 加利西亚语
- gu: 古吉拉特语
- hbs: 塞尔维亚-克罗地亚语
- he: 希伯来语
- hi: 印地语
- hu: 匈牙利语
- hy: 亚美尼亚语
- id: 印度尼西亚语
- is: 冰岛语
- it: 意大利语
- ja: 日语
- ka: 格鲁吉亚语
- kk: 哈萨克语
- kn: 卡纳达语
- ko: 韩语
- ky: 吉尔吉斯语
- la: 拉丁语
- lt: 立陶宛语
- lv: 拉脱维亚语
- mk: 马其顿语
- ml: 马拉雅拉姆语
- mn: 蒙古语
- mr: 马拉地语
- ms: 马来语
- mt: 马耳他语
- my: 缅甸语
- nb: 挪威博克马尔语
- ne: 尼泊尔语
- nl: 荷兰语
- nn: 挪威尼诺斯克语
- pa: 旁遮普语
- pl: 波兰语
- ps: 普什图语
- pt: 葡萄牙语
- ro: 罗马尼亚语
- ru: 俄语
- si: 僧伽罗语
- sk: 斯洛伐克语
- sl: 斯洛文尼亚语
- so: 索马里语
- sq: 阿尔巴尼亚语
- sv: 瑞典语
- sw: 斯瓦希里语
- ta: 泰米尔语
- te: 泰卢固语
- th: 泰语
- tl: 他加禄语
- tr: 土耳其语
- tt: 塔塔尔语
- uk: 乌克兰语
- ur: 乌尔都语
- uz: 乌兹别克语
- vi: 越南语
- zh: 中文
数据集属性
- annotations_creators: no-annotation
- language_creators: found
- language: 见上文配置列表
- multilinguality: multilingual
- size_categories: n<1K, 1K<n<10K, 10K<n<100K, 100K<n<1M, 1M<n<10M, 10M<n<100M, 100M<n<1B, 1B<n<10B
- source_datasets: original
- task_categories: text-generation, fill-mask
- task_ids: language-modeling, masked-language-modeling
- license: cc-by-4.0
数据集结构
数据集包含以下列:
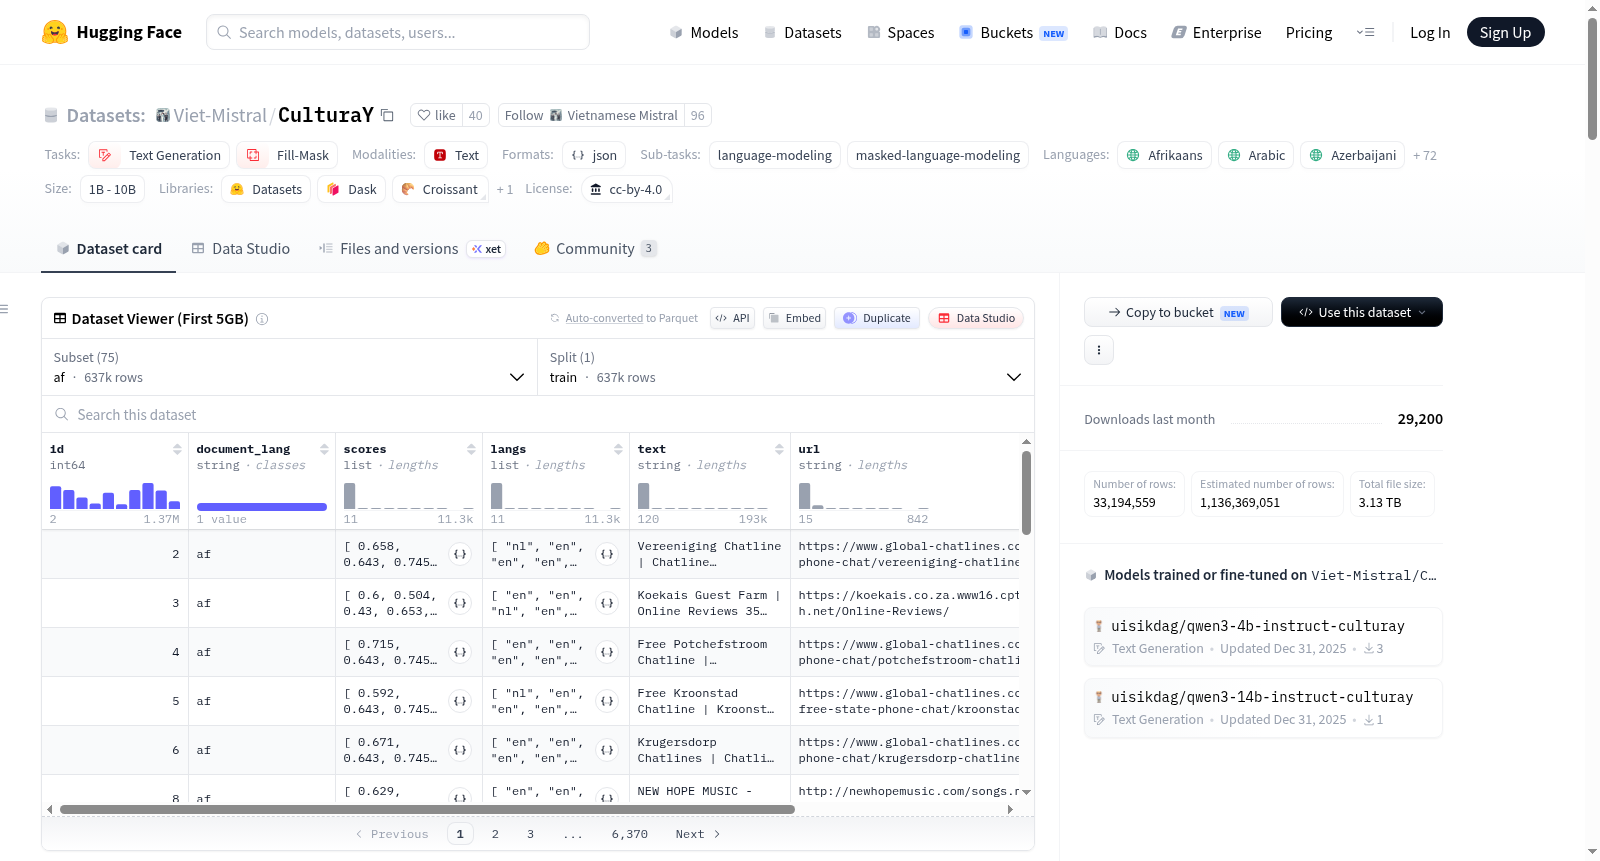
text, url: 主要列id, document_lang, scores, langs: 原始文档列,用于调试,未来将移除
数据集创建过程
CulturaY 是从 HPLT 数据集(版本 1.1)中清洗得到的,与 CulturaX 不同,后者是从 Common Crawl 数据中清洗得到的。清洗过程包括评估文档长度、困惑度、不良词汇比例等,并移除不符合标准的文档。
引用
@misc{nguyen2024culturay, title={CulturaY: A Large Cleaned Multilingual Dataset of 75 Languages}, author={Thuat Nguyen, Huu Nguyen and Thien Nguyen}, year={2024}, }
搜集汇总
数据集介绍
构建方式
在自然语言处理领域,大规模多语言语料库的构建对提升模型的泛化能力至关重要。CulturaY数据集源自HPLT v1.1项目,后者从Internet Archive中采集原始网页数据。与从Common Crawl构建的CulturaX不同,CulturaY开创性地利用了互联网档案馆这一相对未被充分发掘的数据源。构建流程借鉴了Bloom数据清洗管线,对每篇文档依据文档长度、困惑度、不良词汇比率等多项指标进行评估,并剔除未通过任一标准的低质量样本。最终形成了涵盖75种语言、约15TB(未压缩)规模的高质量多语文数据集。
使用方法
使用CulturaY数据集时,研究者可通过Hugging Face Datasets库便捷加载。数据集按语言划分为多个配置,例如加载英语子集可使用`load_dataset('ontocord/CulturaY', 'en')`。数据集中包含'text'和'url'两个核心字段,建议主要利用这两列进行语言模型预训练或掩码语言建模等任务。其余如'id'、'document_lang'等列保留自HPLT原始数据,主要用于调试,未来版本可能移除。由于数据集采用CC-BY-4.0许可,适用于学术研究,但使用者需确认下载行为符合所在地区法规,并承诺不将数据用于恶意目的。
背景与挑战
背景概述
在自然语言处理领域,大规模多语言语料库的构建是推动语言模型发展的关键基石。CulturaY数据集由美国俄勒冈大学自然语言处理组(UONLP)与Ontocord团队于2024年联合发布,旨在解决多语言预训练数据来源单一与质量参差不齐的难题。该数据集基于HPLT v1.1项目,从互联网档案馆(Internet Archive)中提取原始网络文本,经系统性清洗后形成涵盖75种语言、总计15TB(未压缩)的高质量语料。相较于以Common Crawl为来源的CulturaX,CulturaY首次大规模公开源自互联网档案馆的清洗数据,为多语言模型训练提供了全新的数据维度,并已成功应用于越南语先进模型Vistral-7B-Chat的研发,显著提升了低资源语言的模型表现。
当前挑战
CulturaY所面临的挑战贯穿领域问题与构建过程。在领域层面,多语言语料库需应对语言多样性带来的不平衡问题——数据集中英语占比高达43.84%,而吉尔吉斯语等低资源语言占比不足0.01%,这种长尾分布极易导致模型对稀缺语言学习不足。构建过程中,原始数据来自互联网档案馆,其文档质量参差不齐,包含大量噪声、重复内容及有害信息;研究团队需借鉴Bloom数据清洗管线,通过文档长度、困惑度、不良词比率等多维指标进行严格过滤,但如何在去除低质内容的同时保留语言多样性,成为技术难点。此外,数据版权与合规性亦构成挑战,团队虽采用CC-BY-4.0许可,但仍需用户自行确认下载合法性,凸显了大规模网络语料使用的伦理复杂性。
常用场景
经典使用场景
在多语言自然语言处理领域,CulturaY数据集凭借其涵盖75种语言、总计15TB的庞大规模,成为预训练语言模型(如自回归语言模型和掩码语言模型)的经典训练语料。该数据集源于互联网档案馆(Internet Archive)的原始数据,经过与CulturaX类似的严格清洗流程,剔除了低质量、高困惑度及包含不当内容的文档,确保了文本的纯净性与多样性。研究者常将其用于从零开始训练多语言大模型,或作为微调阶段的数据增强来源,尤其适合需要覆盖低资源语言(如拉丁语、冰岛语、斯瓦希里语)的场景,以提升模型对全球语言分布的泛化能力。
解决学术问题
CulturaY的核心学术贡献在于解决了多语言语料库中数据稀缺与质量参差不齐的长期难题。相较于仅依赖Common Crawl的CulturaX,CulturaY首次公开了来自互联网档案馆的大规模清洗数据,为模型训练提供了更具代表性的网络文本来源,从而缓解了数据源单一导致的领域偏差问题。通过结合两者,研究者可显著提升模型在跨语言理解、机器翻译及多语言文本生成任务中的鲁棒性。此外,该数据集助力探索低资源语言的表示学习,推动了语言平等化研究,为构建更公平的AI系统奠定了数据基础。
实际应用
在实际应用中,CulturaY被广泛用于构建面向全球用户的多语言对话系统、搜索引擎及内容审核工具。例如,基于该数据集训练的Vistral-7B-Chat模型在越南语场景中表现出色,展示了其在特定语言上的实用价值。企业可将其用于开发跨语言客服机器人,或优化社交媒体平台的多语言内容推荐算法。同时,该数据集的CC-BY-4.0许可协议允许学术与工业界自由使用,加速了从科研原型到商业产品的转化,尤其适用于需要处理多语言用户生成内容的场景。
数据集最近研究
最新研究方向
在自然语言处理领域,多语言数据集的构建与清洗一直是推动大语言模型泛化能力的关键瓶颈。CulturaY作为一款覆盖75种语言、规模达15TB的清洗后多语料库,其最新研究前沿聚焦于利用互联网档案馆(Internet Archive)的原始数据作为替代数据源,以弥补传统Common Crawl语料库的多样性不足。该数据集沿袭了CulturaX的清洗方法论,通过基于困惑度、文档长度与不良词比率等指标的严格过滤流程,显著提升了语料质量。值得注意的是,CulturaY已被成功应用于训练越南语顶尖模型Vistral-7B-Chat,验证了其在低资源语言场景下的实用价值。这一研究方向的突破性意义在于,它为多语言预训练提供了更均衡的数据基础,推动了语言模型在文化包容性与地域适应性上的进步,同时为后续探索互联网档案馆数据潜力树立了标杆。
以上内容由遇见数据集搜集并总结生成


