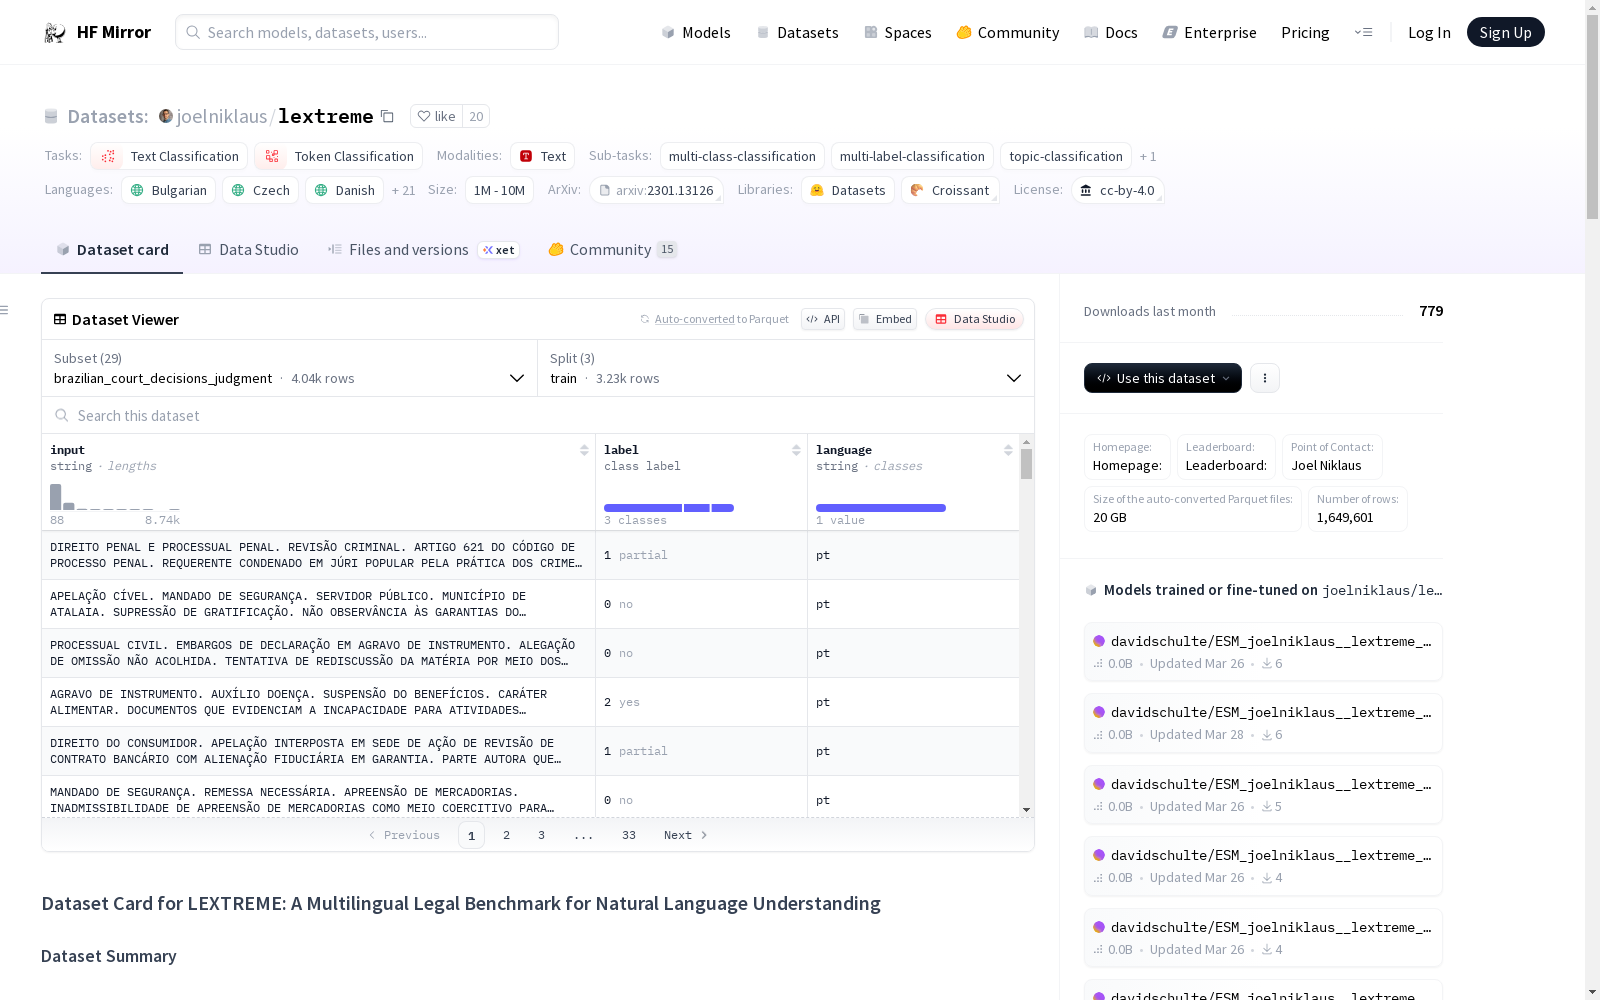
joelniklaus/lextreme
收藏资源简介:
LEXTREME数据集是一个多语言法律自然语言理解基准,包含11个多样化的多语言法律NLU数据集。其中6个数据集有单一配置,5个数据集有两个或三个配置,总共包含18个任务(8个单标签文本分类任务、5个多标签文本分类任务和5个标记分类任务)。数据集支持多种语言,包括保加利亚语、捷克语、丹麦语、德语、希腊语、英语、西班牙语、爱沙尼亚语、芬兰语、法语、爱尔兰语、克罗地亚语、匈牙利语、意大利语、立陶宛语、拉脱维亚语、马耳他语、荷兰语、波兰语、葡萄牙语、罗马尼亚语、斯洛伐克语、斯洛文尼亚语和瑞典语。
The LEXTREME dataset is a multilingual legal natural language understanding benchmark that encompasses 11 diverse multilingual legal NLU datasets. Of these, 6 datasets feature a single configuration, while 5 datasets have two or three configurations, resulting in a total of 18 tasks (8 single-label text classification tasks, 5 multi-label text classification tasks, and 5 token classification tasks). The dataset supports a variety of languages, including Bulgarian, Czech, Danish, German, Greek, English, Spanish, Estonian, Finnish, French, Irish, Croatian, Hungarian, Italian, Lithuanian, Latvian, Maltese, Dutch, Polish, Portuguese, Romanian, Slovak, Slovenian, and Swedish.
数据集概述
数据集名称
LEXTREME: A Multilingual Legal Benchmark for Natural Language Understanding
数据集概要
该数据集包含11个多语言法律自然语言理解(NLU)数据集,总计18个任务,包括8个单标签文本分类任务、5个多标签文本分类任务和5个令牌分类任务。
支持的任务和配置
- Brazilian Court Decisions: 判决预测(判决、一致性)
- Swiss Judgment Prediction: 判决预测(默认)
- German Argument Mining: 论点挖掘(默认)
- Greek Legal Code: 主题分类(卷、章、主题)
- Online Terms of Service: 不公平分类(不公平级别、条款主题)
- Covid 19 Emergency Event: 事件分类(默认)
- MultiEURLEX: 主题分类(级别1、级别2、级别3)
- LeNER BR: 命名实体识别(默认)
- LegalNERo: 命名实体识别(默认)
- Greek Legal NER: 命名实体识别(默认)
- MAPA: 命名实体识别(粗粒度、细粒度)
语言支持
支持以下语言:bg, cs, da, de, el, en, es, et, fi, fr, ga, hr, hu, it, lt, lv, mt, nl, pl, pt, ro, sk, sl, sv
数据集结构
- 文件格式: jsonl
- 数据分割: 每个配置包含三个数据分割(训练、验证和测试)
许可证
cc-by-4.0
数据集大小
10K<n<100K
数据集来源
- 源数据集: 扩展
任务类别
- 文本分类
- 令牌分类