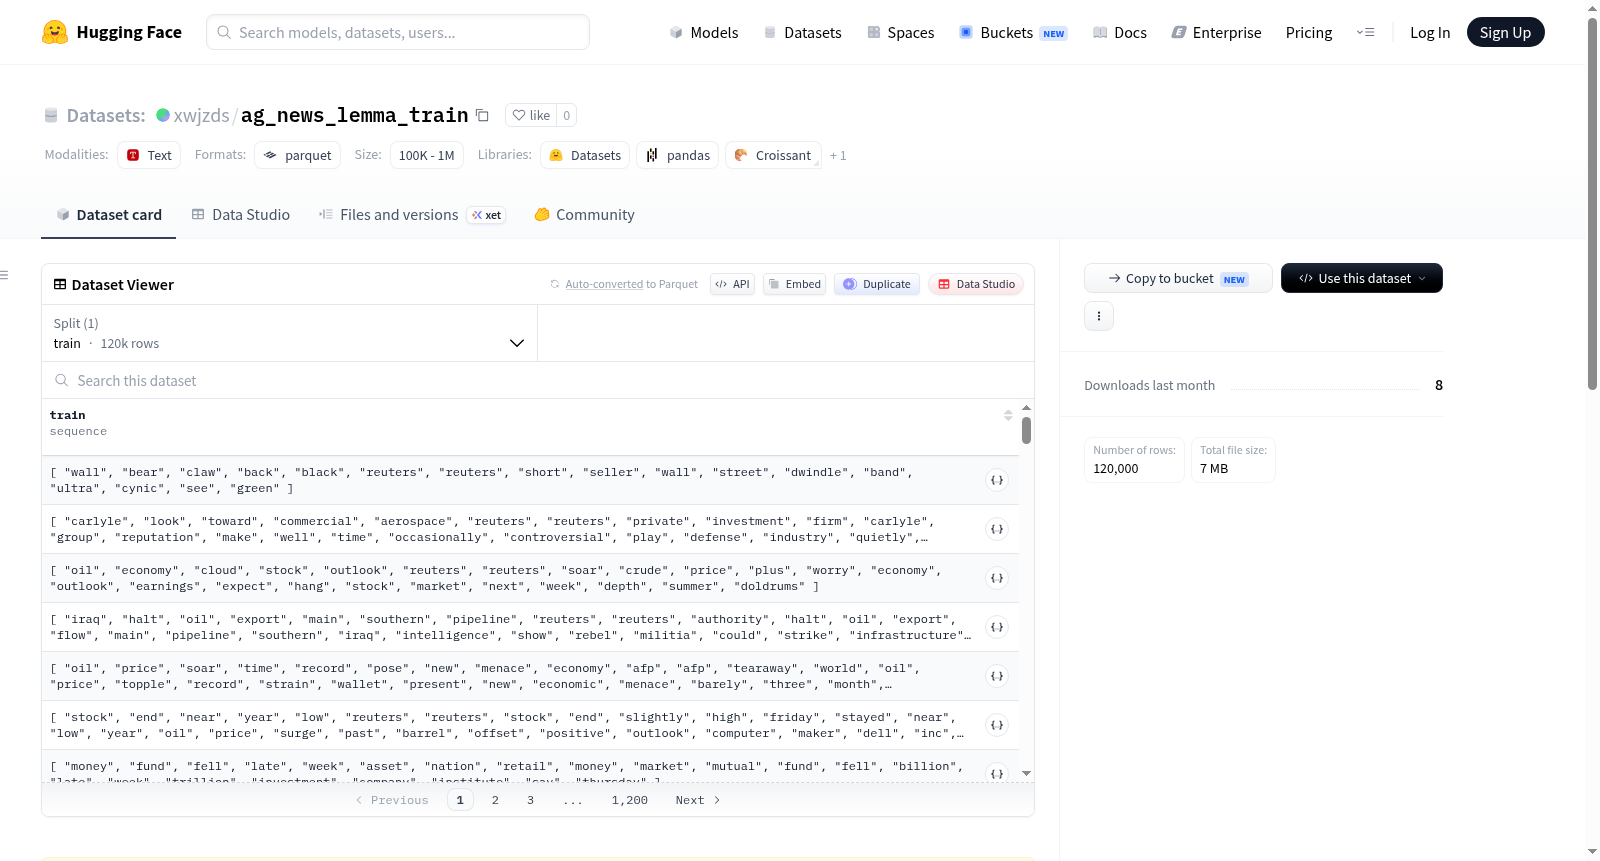
xwjzds/ag_news_lemma_train
收藏资源简介:
# Dataset Card for Dataset Name ### Dataset Summary This is lemmatized version of Ag News Data. ### Languages English ### Citation Information ```bibtex @inproceedings{xu-etal-2023-vontss, title = "v{ONTSS}: v{MF} based semi-supervised neural topic modeling with optimal transport", author = "Xu, Weijie and Jiang, Xiaoyu and Sengamedu Hanumantha Rao, Srinivasan and Iannacci, Francis and Zhao, Jinjin", booktitle = "Findings of the Association for Computational Linguistics: ACL 2023", month = jul, year = "2023", address = "Toronto, Canada", publisher = "Association for Computational Linguistics", url = "https://aclanthology.org/2023.findings-acl.271", doi = "10.18653/v1/2023.findings-acl.271", pages = "4433--4457", abstract = "Recently, Neural Topic Models (NTM), inspired by variational autoencoders, have attracted a lot of research interest; however, these methods have limited applications in the real world due to the challenge of incorporating human knowledge. This work presents a semi-supervised neural topic modeling method, vONTSS, which uses von Mises-Fisher (vMF) based variational autoencoders and optimal transport. When a few keywords per topic are provided, vONTSS in the semi-supervised setting generates potential topics and optimizes topic-keyword quality and topic classification. Experiments show that vONTSS outperforms existing semi-supervised topic modeling methods in classification accuracy and diversity. vONTSS also supports unsupervised topic modeling. Quantitative and qualitative experiments show that vONTSS in the unsupervised setting outperforms recent NTMs on multiple aspects: vONTSS discovers highly clustered and coherent topics on benchmark datasets. It is also much faster than the state-of-the-art weakly supervised text classification method while achieving similar classification performance. We further prove the equivalence of optimal transport loss and cross-entropy loss at the global minimum.", } ```
# 数据集卡片 ### 数据集概述 本数据集为Ag News Data的词形还原版本。 ### 语言 英语 ### 引用信息 bibtex @inproceedings{xu-etal-2023-vontss, title = "vONTSS:基于von Mises-Fisher(vMF)的最优传输半监督神经主题建模", author = "Xu, Weijie and Jiang, Xiaoyu and Sengamedu Hanumantha Rao, Srinivasan and Iannacci, Francis and Zhao, Jinjin", booktitle = "计算语言学协会研究发现:ACL 2023", month = jul, year = "2023", address = "加拿大多伦多", publisher = "计算语言学协会", url = "https://aclanthology.org/2023.findings-acl.271", doi = "10.18653/v1/2023.findings-acl.271", pages = "4433--4457", abstract = "近年来,受变分自编码器(Variational AutoEncoder, VAE)启发的神经主题模型(Neural Topic Model, NTM)受到了大量研究关注,但由于难以融入人类知识,这类方法在现实场景中的应用受到限制。本研究提出了一种半监督神经主题建模方法vONTSS,该方法采用基于von Mises-Fisher(vMF)的变分自编码器与最优传输技术。当给定每个主题的少量关键词时,半监督设置下的vONTSS可生成潜在主题,并优化主题-关键词质量与主题分类性能。实验结果表明,vONTSS在分类准确率与主题多样性两项指标上均优于现有半监督主题建模方法。此外,vONTSS同样支持无监督主题建模任务。定量与定性实验均证明,无监督设置下的vONTSS在多个维度上优于近年提出的神经主题模型:在基准数据集上,vONTSS能够挖掘出聚类性与连贯性俱佳的主题。同时,该方法在实现相近分类性能的前提下,运行速度远优于当前最优的弱监督文本分类方法。我们还从理论上证明了,在全局最优解处,最优传输损失与交叉熵损失是等价的。", }
数据集概述
数据集名称
Dataset Name
数据集摘要
这是一个经过词形还原处理的Ag News数据集版本。
语言
英语
引用信息
bibtex @inproceedings{xu-etal-2023-vontss, title = "v{ONTSS}: v{MF} based semi-supervised neural topic modeling with optimal transport", author = "Xu, Weijie and Jiang, Xiaoyu and Sengamedu Hanumantha Rao, Srinivasan and Iannacci, Francis and Zhao, Jinjin", booktitle = "Findings of the Association for Computational Linguistics: ACL 2023", month = jul, year = "2023", address = "Toronto, Canada", publisher = "Association for Computational Linguistics", url = "https://aclanthology.org/2023.findings-acl.271", doi = "10.18653/v1/2023.findings-acl.271", pages = "4433--4457", abstract = "Recently, Neural Topic Models (NTM), inspired by variational autoencoders, have attracted a lot of research interest; however, these methods have limited applications in the real world due to the challenge of incorporating human knowledge. This work presents a semi-supervised neural topic modeling method, vONTSS, which uses von Mises-Fisher (vMF) based variational autoencoders and optimal transport. When a few keywords per topic are provided, vONTSS in the semi-supervised setting generates potential topics and optimizes topic-keyword quality and topic classification. Experiments show that vONTSS outperforms existing semi-supervised topic modeling methods in classification accuracy and diversity. vONTSS also supports unsupervised topic modeling. Quantitative and qualitative experiments show that vONTSS in the unsupervised setting outperforms recent NTMs on multiple aspects: vONTSS discovers highly clustered and coherent topics on benchmark datasets. It is also much faster than the state-of-the-art weakly supervised text classification method while achieving similar classification performance. We further prove the equivalence of optimal transport loss and cross-entropy loss at the global minimum.", }