
bluesky333/synthetic_discharge_summ
收藏官方服务:
资源简介:
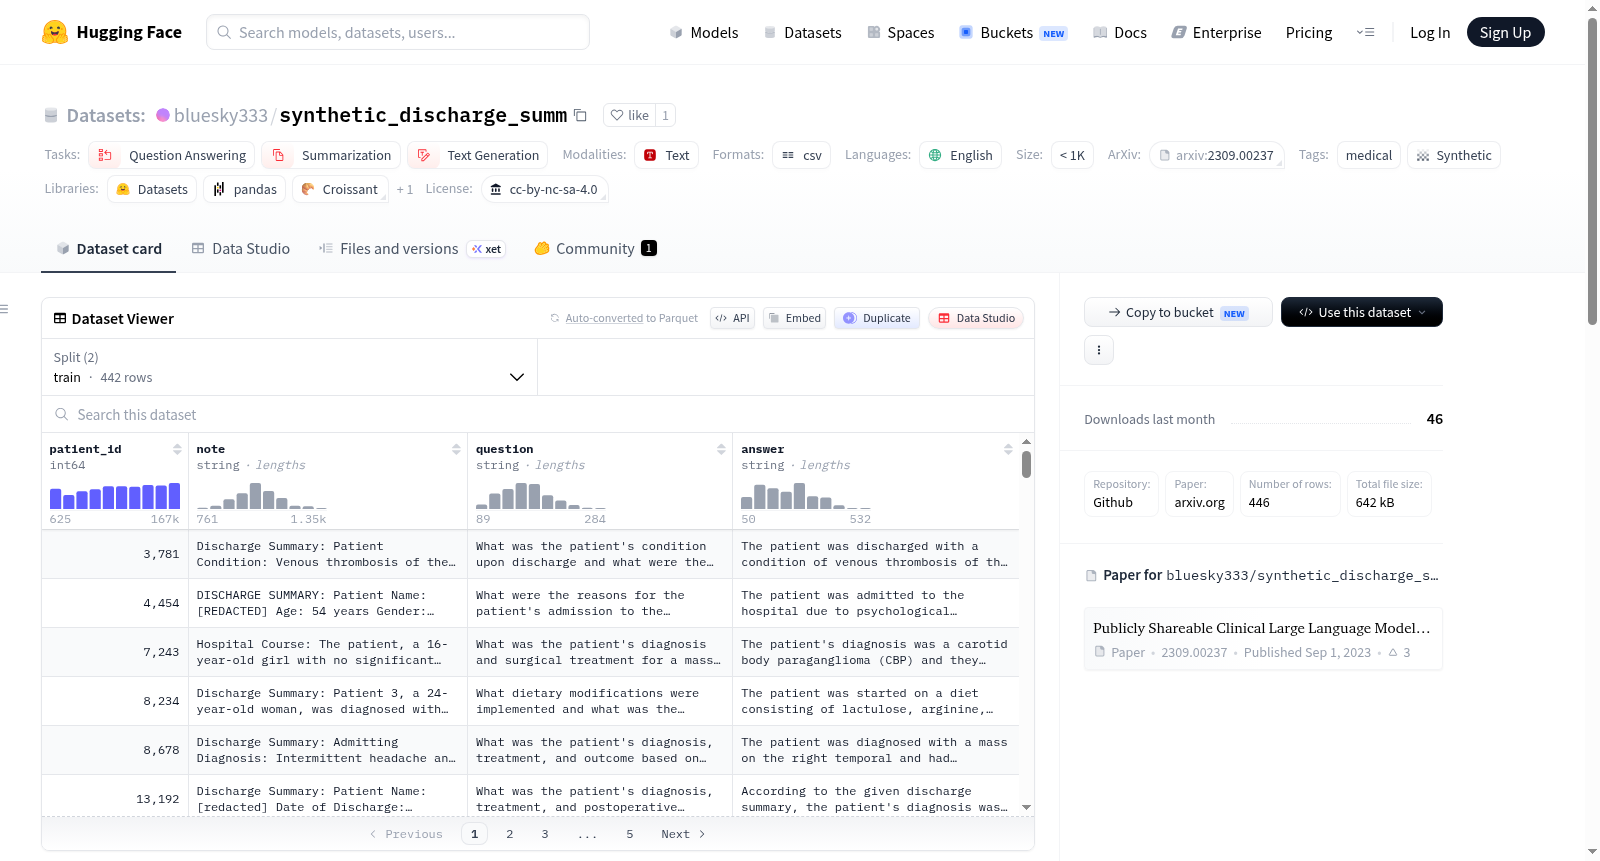
该数据集名为Synthetic Discharge Note Summarization,主要用于医疗领域的出院记录摘要任务。数据集包含13,584条记录,这些记录是从PMC-Patients案例报告中通过GPT-3.5生成的合成笔记。数据集的结构包括患者ID、笔记、问题和答案等字段,支持问答、摘要、文本生成和对话等任务。
该数据集名为Synthetic Discharge Note Summarization,主要用于医疗领域的出院记录摘要任务。数据集包含13,584条记录,这些记录是从PMC-Patients案例报告中通过GPT-3.5生成的合成笔记。数据集的结构包括患者ID、笔记、问题和答案等字段,支持问答、摘要、文本生成和对话等任务。
提供机构:
bluesky333原始信息汇总
数据集概述
- 名称: Synthetic Discharge Note Summarization
- 类别: 医学、合成数据
- 大小: 10,000 < n < 100,000
支持的任务
- 问答
- 摘要
- 文本生成
- 对话
语言
- 英语
数据集结构
- 数据实例:
discharge_notes.csv,包含临床笔记 - 问题 - 答案对 - 数据字段:
patient_id: 来自PMC-Patients的唯一案例报告IDnote: 案例报告文本question: GPT-3.5生成的来自患者的指令answer: GPT-3.5生成的针对给定案例报告和问题的答案
源数据
许可信息
- CC-BY-NC-SA 4.0
搜集汇总
数据集介绍
构建方式
在临床自然语言处理领域,高质量的数据集对于模型训练至关重要。bluesky333/synthetic_discharge_summ数据集源自Asclepius项目,其构建过程严谨而富有创新性。该数据集以PMC-Patients病例报告为原始素材,借助GPT-3.5模型生成合成临床笔记。具体而言,研究者从PMC-Patients中提取患者病例报告,利用精心设计的提示词引导GPT-3.5生成指令与答案对,最终通过过滤筛选,聚焦于出院小结的摘要任务,形成了包含13,584条笔记的专门子集。这一方法既保留了病例的医学真实性,又通过合成技术扩充了数据规模。
特点
该数据集在医学文本摘要领域展现出独特优势。其核心特点在于数据来源的权威性与合成质量的平衡——基于PMC-Patients真实病例报告,确保了临床信息的准确性;而GPT-3.5的介入则赋予了数据多样性与可控性。每条记录由患者标识符、病例报告原文、GPT-3.5生成的提问指令及相应答案构成,结构清晰。数据集规模介于1万至10万之间,采用CC-BY-NC-SA 4.0许可协议,兼顾了开放共享与学术规范,为医疗文本生成与问答任务提供了坚实基准。
使用方法
使用该数据集时,研究者可直接加载discharge_notes.csv文件,其中包含patient_id、note、question和answer四个字段。该数据集支持多项自然语言处理任务,包括问答、摘要生成、文本生成及对话系统。用户可将其用于微调大型语言模型,以提升在临床出院小结场景下的理解与生成能力。建议将note字段作为输入,question与answer作为监督信号,构建序列到序列的学习任务。数据集托管于HuggingFace平台,可通过datasets库便捷调用,便于复现Asclepius相关工作或开展新研究。
背景与挑战
背景概述
在临床自然语言处理领域,出院小结的自动摘要生成对于提升医疗文书处理效率、辅助临床决策具有重要意义。然而,真实医疗数据因涉及患者隐私而难以公开获取,严重制约了相关研究的发展。为此,bluesky333/synthetic_discharge_summ数据集于2023年由Asclepius项目团队创建,基于PMC-Patients病例报告,借助GPT-3.5模型生成合成临床笔记及问答对,筛选出13,584条出院小结摘要任务数据。该数据集遵循CC-BY-NC-SA 4.0许可,旨在为医疗文本摘要、问答及对话生成等任务提供大规模、可公开访问的基准资源,推动了合成数据在临床自然语言处理中的可信应用。
当前挑战
该数据集面临的核心挑战包括:其一,领域问题层面,临床出院小结摘要需在保留关键诊断、治疗及预后信息的同时,压缩冗长病历文本,而现有模型常难以平衡信息完整性与摘要简洁性;其二,构建过程中,合成数据依赖GPT-3.5生成,可能引入模型偏见或事实错误,导致与真实临床记录的语义一致性不足;此外,从PMC-Patients提取的病例报告存在格式差异,需设计统一预处理流程以确保数据质量;最后,缺乏专家标注验证,使得合成数据的临床可靠性与泛化能力存疑,限制了其在高风险医疗场景中的直接应用。
常用场景
经典使用场景
在临床自然语言处理领域,Synthetic Discharge Note Summarization数据集为出院小结的自动摘要生成提供了重要的基准资源。该数据集包含13,584条由GPT-3.5基于PMC-Patients病例报告合成的临床笔记,其核心应用场景聚焦于训练和评估能够将冗长、非结构化的出院记录精炼为简洁、信息完整的摘要的模型。研究者可利用该数据集监督学习范式,探索序列到序列模型在医学文本压缩中的表现,从而推动临床文档自动化的技术边界。
实际应用
在实际医疗场景中,该数据集驱动的模型可辅助临床医生快速生成标准化的出院小结,显著减少文书工作负担,提升诊疗效率。通过集成到电子健康记录系统中,自动摘要功能能够从繁杂的病程记录中提取关键诊断、用药调整及随访建议,降低信息遗漏风险。此外,该技术还可用于患者端健康摘要的生成,增强医患沟通透明度,在远程医疗和分级诊疗体系中发挥优化信息流转的实用价值。
衍生相关工作
该数据集源自Asclepius项目,其衍生工作包括基于指令微调的临床语言模型Asclepius的提出,以及多项针对合成数据质量与真实临床数据分布对齐性的研究。后续工作进一步探索了利用该数据集进行少样本学习、跨机构迁移学习以及结合知识图谱增强摘要事实一致性的方法。这些研究不仅验证了合成数据在医学NLP中的可行性,还催生了关于临床文本生成中幻觉抑制与伦理合规性的深入讨论,形成了从数据构建到模型部署的完整研究脉络。
以上内容由遇见数据集搜集并总结生成


