
mm-eval/MMT-Bench
收藏官方服务:
资源简介:
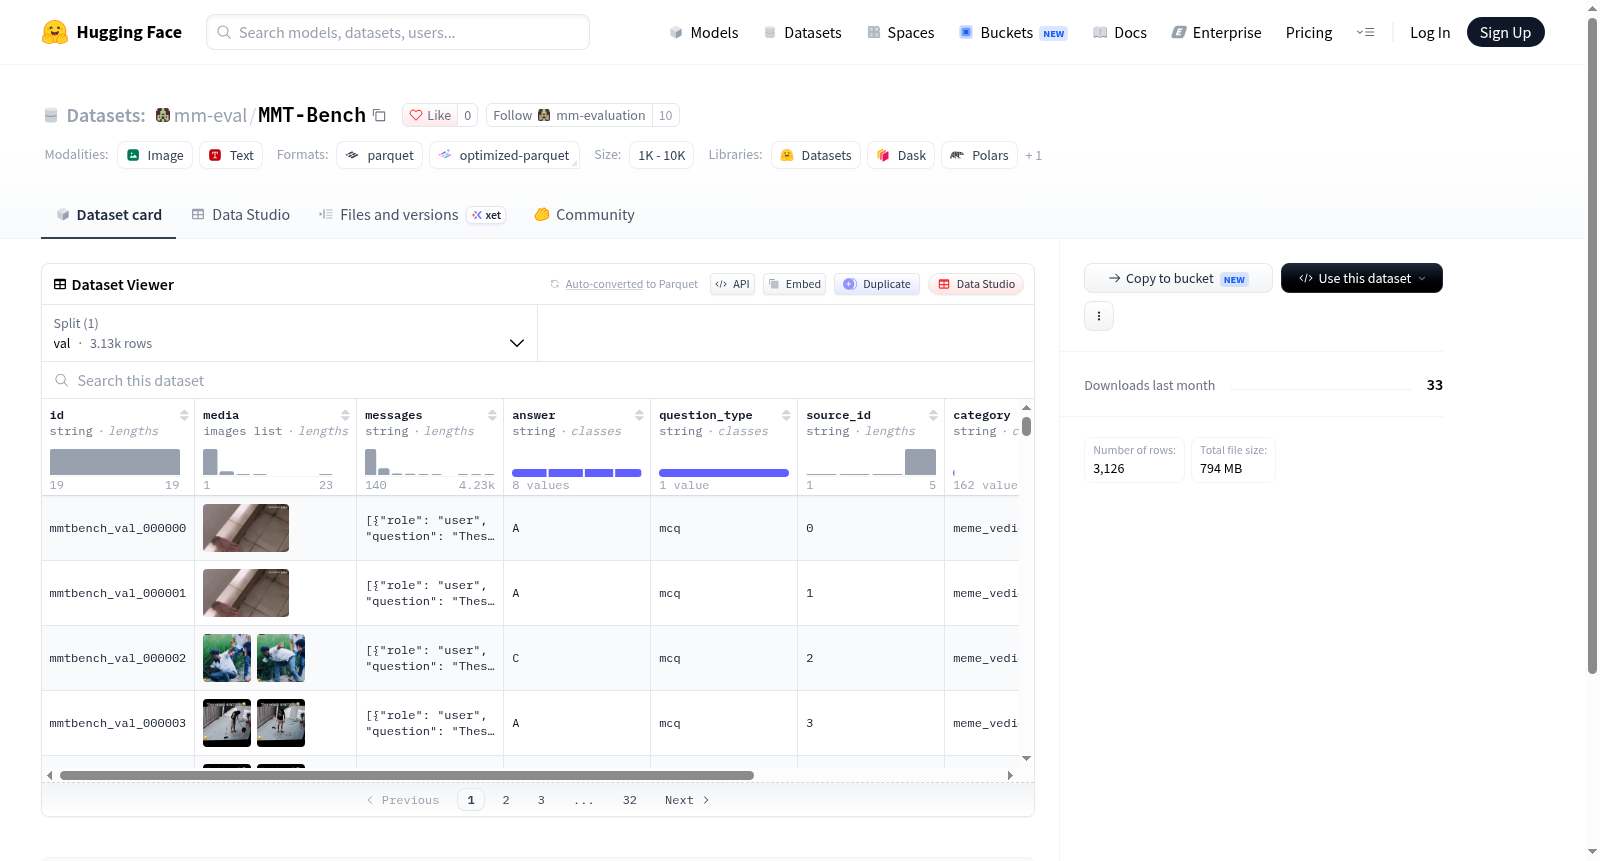
该数据集包含3126个样本,每个样本具有id(字符串类型)、media(图像列表)和messages(字符串类型)特征。数据集仅包含val分割,总大小约为795MB,下载大小约为773MB。
This dataset contains 3126 examples, each with features including id (string type), media (list of images), and messages (string type). The dataset only includes a val split, with a total size of approximately 795MB and a download size of approximately 773MB.
提供机构:
mm-eval搜集汇总
数据集介绍
构建方式
在多模态大模型评测需求日益增长的背景下,MMT-Bench的构建遵循系统性评测基准的设计原则。数据集通过收集涵盖多幅图像的视觉素材,并以字符串形式存储对话消息与问题,配合对应答案及来源标识,形成结构化验证样本。其构建过程注重问题类型的多样性与类别层次划分,包括一级与二级类别标注,从而支持细粒度能力评估。所有样本经统一组织后划分为验证集,确保评测过程的规范性与可复现性。
特点
该数据集以多图输入为核心特征,包含3126个验证样本,样本规模与图像组合方式使其能够考察模型在跨图像推理与理解方面的表现。数据字段设计兼顾问题、答案、问题类型、来源及多级类别信息,便于按不同维度进行结果分析。多级类别体系为诊断模型在不同任务上的强弱项提供了结构化依据,而来源标识则有助于追踪样本出处。整体数据规模适中,适合作为多模态评测的基准资源。
使用方法
使用者可通过HuggingFace平台直接加载默认配置下的验证集,数据文件路径以通配符形式组织,便于批量读取。加载后,可依据messages字段中的对话内容与media字段中的多幅图像构造模型输入,并以answer字段作为标准答案进行自动评测。借助question_type与category、l2_category字段,用户能够按问题类型或类别层次统计模型表现,进而开展细粒度分析。source_id字段可用于溯源或分组比较,支持多样化的评测实验设计。
背景与挑战
背景概述
多模态大模型在图文理解任务中取得显著进展,然而对其在复杂、多步骤推理场景下的能力评估仍存在空白。MMT-Bench由研究团队于2024年构建,旨在系统评估多模态大模型的多任务、多轮交互与多步推理能力。该数据集涵盖3126个验证样本,每个样本包含图像、对话消息、答案及任务类型标注,横跨多个类别与子类别,为模型在真实场景中的综合理解与推理提供了标准化测试平台。其发布推动了多模态评测从单一任务向复合任务演进,对模型鲁棒性与泛化性研究具有重要参考价值。
当前挑战
MMT-Bench所应对的领域问题在于,现有多模态基准多侧重单轮问答或单一任务,难以衡量模型在需要多步推理、多图关联及动态交互场景下的真实表现。构建过程中,如何设计覆盖广泛任务类型且难度分层的样本、确保多轮对话逻辑连贯、以及平衡各类别分布,均构成显著挑战。此外,标注者需同时具备视觉理解与复杂推理能力,以保证答案的准确性与一致性,这进一步提升了数据收集与验证的成本与复杂度。
常用场景
经典使用场景
在多模态大模型评测领域,MMT-Bench以其对多图像理解与推理的系统性评估而备受关注。该数据集经典使用场景聚焦于考察模型在复杂视觉-语言任务中的表现,例如多图对比、时序推理、因果推断及跨图指代等。其测试样例包含多幅图像与配套问答,要求模型综合视觉信息与文本指令作出准确回答,从而揭示模型在真实多模态交互中的能力边界。
衍生相关工作
MMT-Bench的发布催生了一系列相关经典工作,包括针对多图理解的提示工程方法、多模态思维链推理框架以及基于该基准的模型微调与蒸馏研究。后续研究常将其作为核心评测集,用以验证新型架构(如多图注意力机制、图神经网络与视觉语言模型结合)的有效性,并推动了多模态基准向更复杂、更贴近现实的方向演进。
数据集最近研究
最新研究方向
在多模态大模型向通用人工智能迈进的过程中,对模型跨模态理解与推理能力的系统性评估已成为学术界与工业界的核心关切。MMT-Bench作为面向多图像与交错图文输入的综合基准,其最新研究方向聚焦于考察模型在真实场景下对时序图像、多视角视觉线索及复杂图文交错序列的联合推理能力。该基准涵盖感知、认知与空间推理等多个层级,推动了对大模型长上下文多模态对齐、跨图像指代消解及动态视觉状态追踪等前沿问题的探索,为构建具备连续视觉感知与深层语义整合能力的下一代多模态智能体提供了关键评测支撑。
以上内容由遇见数据集搜集并总结生成


