遇见数据集

CVasNLPExperiments/VQAv2_sample_validation_google_flan_t5_xxl_mode_A_CM_Q_rices_ns_1000

收藏
Hugging Face2023-05-26 更新2024-03-04 收录
官方服务:

资源简介:

--- dataset_info: features: - name: id dtype: int64 - name: question dtype: string - name: true_label sequence: string - name: prediction dtype: string splits: - name: fewshot_0_clip_tags_LAION_ViT_H_14_2B_with_openai_Attributes_LAION_ViT_H_14_2B_descriptors_text_davinci_003_full_DETA_detections_deta_swin_large_o365_coco_classes_caption_all_patches_Salesforce_blip_image_captioning_large_clean_ num_bytes: 142104 num_examples: 1000 download_size: 53610 dataset_size: 142104 --- # Dataset Card for "VQAv2_sample_validation_google_flan_t5_xxl_mode_A_CM_Q_rices_ns_1000" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

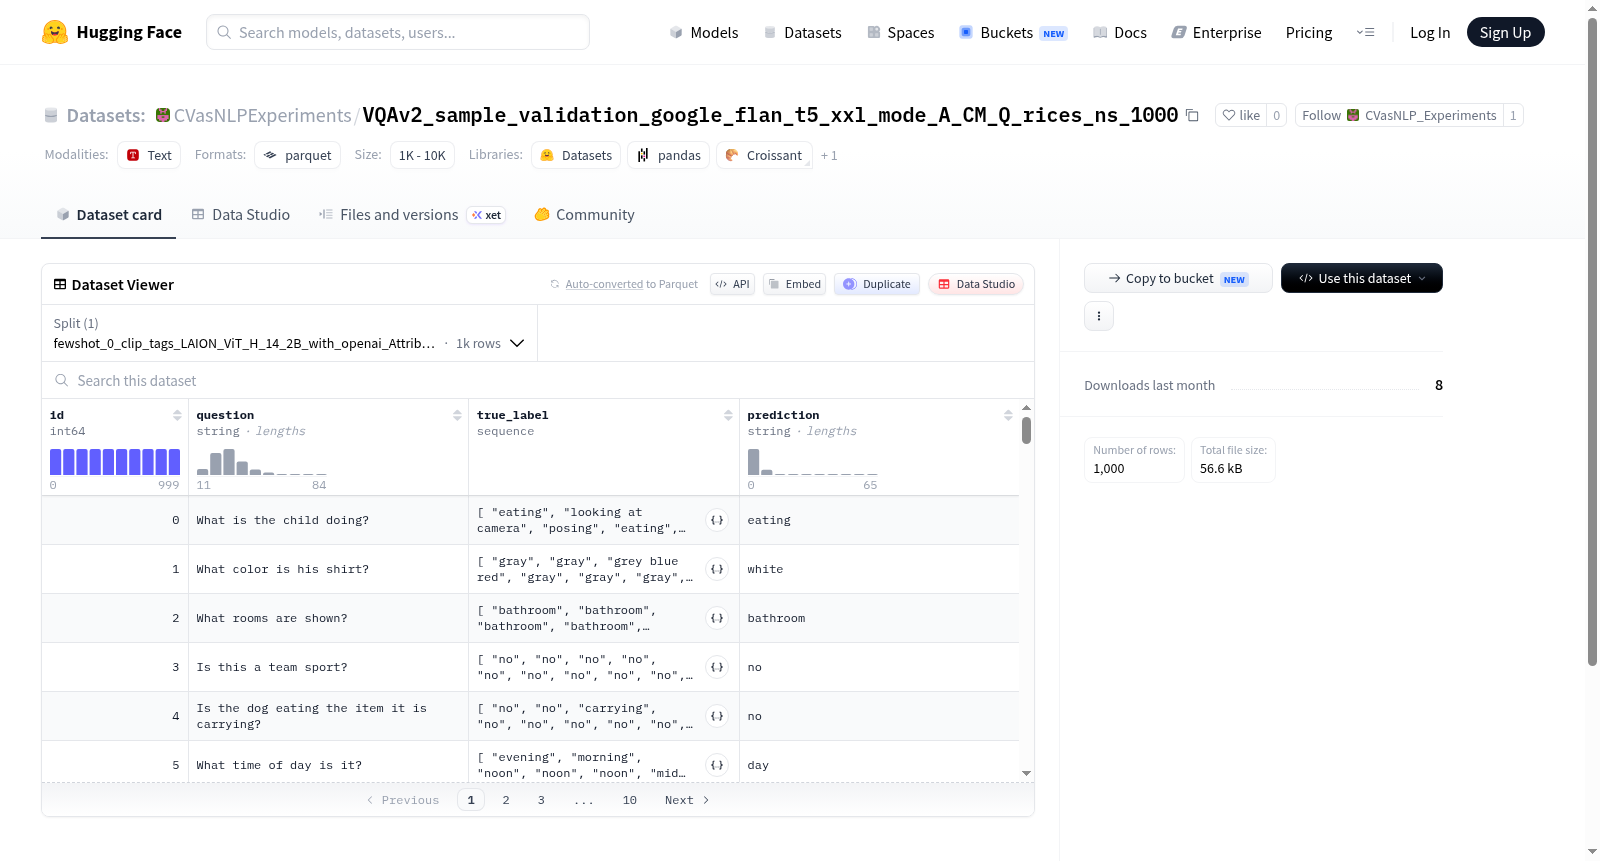
数据集信息: 特征字段: - 名称:id,数据类型:64位整数(int64) - 名称:问题(question),数据类型:字符串(string) - 名称:真实标签(true_label),数据类型:字符串序列 - 名称:预测结果(prediction),数据类型:字符串(string) 数据集划分: - 划分名称:fewshot_0_clip_tags_LAION_ViT_H_14_2B_with_openai_Attributes_LAION_ViT_H_14_2B_descriptors_text_davinci_003_full_DETA_detections_deta_swin_large_o365_coco_classes_caption_all_patches_Salesforce_blip_image_captioning_large_clean_,该划分的字节占用大小为142104,样本量为1000 下载体积:53610 数据集总大小:142104 # 数据集卡片:"VQAv2_sample_validation_google_flan_t5_xxl_mode_A_CM_Q_rices_ns_1000" [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

提供机构:
CVasNLPExperiments
原始信息汇总

数据集概述

数据集名称

VQAv2_sample_validation_google_flan_t5_xxl_mode_A_CM_Q_rices_ns_1000

数据集特征

  • id: 整数类型 (int64)
  • question: 字符串类型 (string)
  • true_label: 字符串序列类型
  • prediction: 字符串类型 (string)

数据集分割

  • 分割名称: fewshot_0_clip_tags_LAION_ViT_H_14_2B_with_openai_Attributes_LAION_ViT_H_14_2B_descriptors_text_davinci_003_full_DETA_detections_deta_swin_large_o365_coco_classes_caption_all_patches_Salesforce_blip_image_captioning_large_clean_
  • 数据大小: 142104 字节
  • 样本数量: 1000

数据集大小

  • 下载大小: 53610 字节
  • 数据集总大小: 142104 字节
搜集汇总
数据集介绍
CVasNLPExperiments/VQAv2_sample_validation_google_flan_t5_xxl_mode_A_CM_Q_rices_ns_1000 数据集图片
构建方式
该数据集源自VQAv2验证集的一个子样本,包含1000个样本,旨在评估多模态大模型在视觉问答任务上的表现。构建过程中,采用了基于CLIP标签、OpenAI属性描述、DETA目标检测结果以及BLIP图像描述等多种视觉特征提取方法,并结合了RICES(Retrieval-based In-Context Example Selection)策略,从1000个候选样本中为每个问题选取最相关的上下文示例。模型预测由google_flan_t5_xxl在模式A下生成,其中问题与上下文示例拼接形成输入,最终得到每个问题的预测答案。
特点
数据集特色在于其融合了多源视觉信息与检索增强的上下文学习机制。每个样本包含唯一标识符、自然语言问题、真实标签(支持多个正确答案)以及模型预测。视觉特征涵盖从CLIP到DETA的多种粒度,确保了场景理解的全面性。同时,RICES策略通过检索最相似的示例,提升了零样本或小样本场景下的推理能力。该设计特别适用于分析不同视觉编码与上下文选择策略对多模态模型性能的影响。
使用方法
数据集可直接用于评估视觉问答模型的泛化能力,尤其适合对比不同视觉特征或上下文示例选择策略的效果。使用时,加载HuggingFace数据集后,可通过'id'字段索引样本,利用'question'和'true_label'进行标准评测,或使用'prediction'字段分析模型输出。研究者可进一步拆分数据为开发集与测试集,或结合原有的VQAv2评估脚本计算准确率。此外,该数据集支持自定义上下文示例数量,便于进行消融实验或灵敏度分析。
背景与挑战
背景概述
视觉问答(VQA)作为连接计算机视觉与自然语言处理的关键任务,长期以来致力于使模型能够基于图像内容准确回答自然语言问题。在此背景下,VQAv2数据集作为该领域的权威基准,由佐治亚理工学院等机构的研究人员于2017年创建,旨在克服VQA v1中存在的语言偏见问题,通过引入互补图像对来确保模型真正理解视觉内容而非依赖统计捷径。该数据集包含超过20万张图像和110万个问答对,覆盖了广泛的生活场景与复杂推理需求,对推动多模态学习、视觉推理及模型鲁棒性研究产生了深远影响。本样本验证集(VQAv2_sample_validation_google_flan_t5_xxl_mode_A_CM_Q_rices_ns_1000)则聚焦于评估大型语言模型(如Flan-T5)在视觉问答任务中的表现,通过检索增强与上下文学习机制,探索模型在少样本场景下的泛化能力。
当前挑战
当前VQA领域面临的核心挑战在于模型对视觉与语言模态的深度对齐与推理能力。一方面,现有模型常受语言先验误导,倾向于基于问题模式而非图像内容给出答案,例如在VQAv2中,模型需区分语义相似但视觉差异细微的问题对,这要求其具备精准的视觉定位与语义理解能力。另一方面,构建高质量VQA数据集本身充满困难:需平衡问题多样性、答案准确性及视觉覆盖度,同时避免标注偏见。本样本集利用检索增强策略(如RICES)从百万级候选池中选取相似样本,但如何确保检索结果与当前问答对的语义一致性、如何处理长尾分布下的罕见场景,仍是亟待解决的难题。此外,大型模型在推理时的高计算成本与可解释性不足,也限制了其在实时或关键领域的应用。
常用场景
经典使用场景
在视觉与语言交叉领域的研究中,VQAv2数据集常被用作多模态推理能力的基准测试。该数据集包含图像、问题及对应答案,要求模型在理解视觉内容的基础上进行语义解析与逻辑推断。其经典使用场景聚焦于评估模型在开放式视觉问答任务中的表现,尤其关注模型能否准确捕捉图像中的细粒度视觉线索,并将其与自然语言问题中的语义约束相匹配,从而生成合理且精准的答案。
实际应用
在实际应用中,基于VQAv2训练的模型可被部署于智能辅助系统,例如为视障人士提供实时场景描述与问答服务,或赋能教育领域中的自动图像辅导工具。此外,其在电子商务场景中可用于商品细节查询,用户仅需以自然语言提问即可获取精准的视觉信息反馈,从而提升交互效率与用户体验。
衍生相关工作
该数据集衍生了一系列经典工作,包括基于注意力机制的多模态融合模型(如ViLBERT、LXMERT)以及端到端的视觉语言预训练框架(如VLP、UNITER)。这些工作以VQAv2为评估平台,探索了视觉特征与文本表示的深度交互策略,并催生了诸如跨模态对比学习、细粒度视觉定位等研究方向,进一步推动了视觉问答领域的技术边界。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务