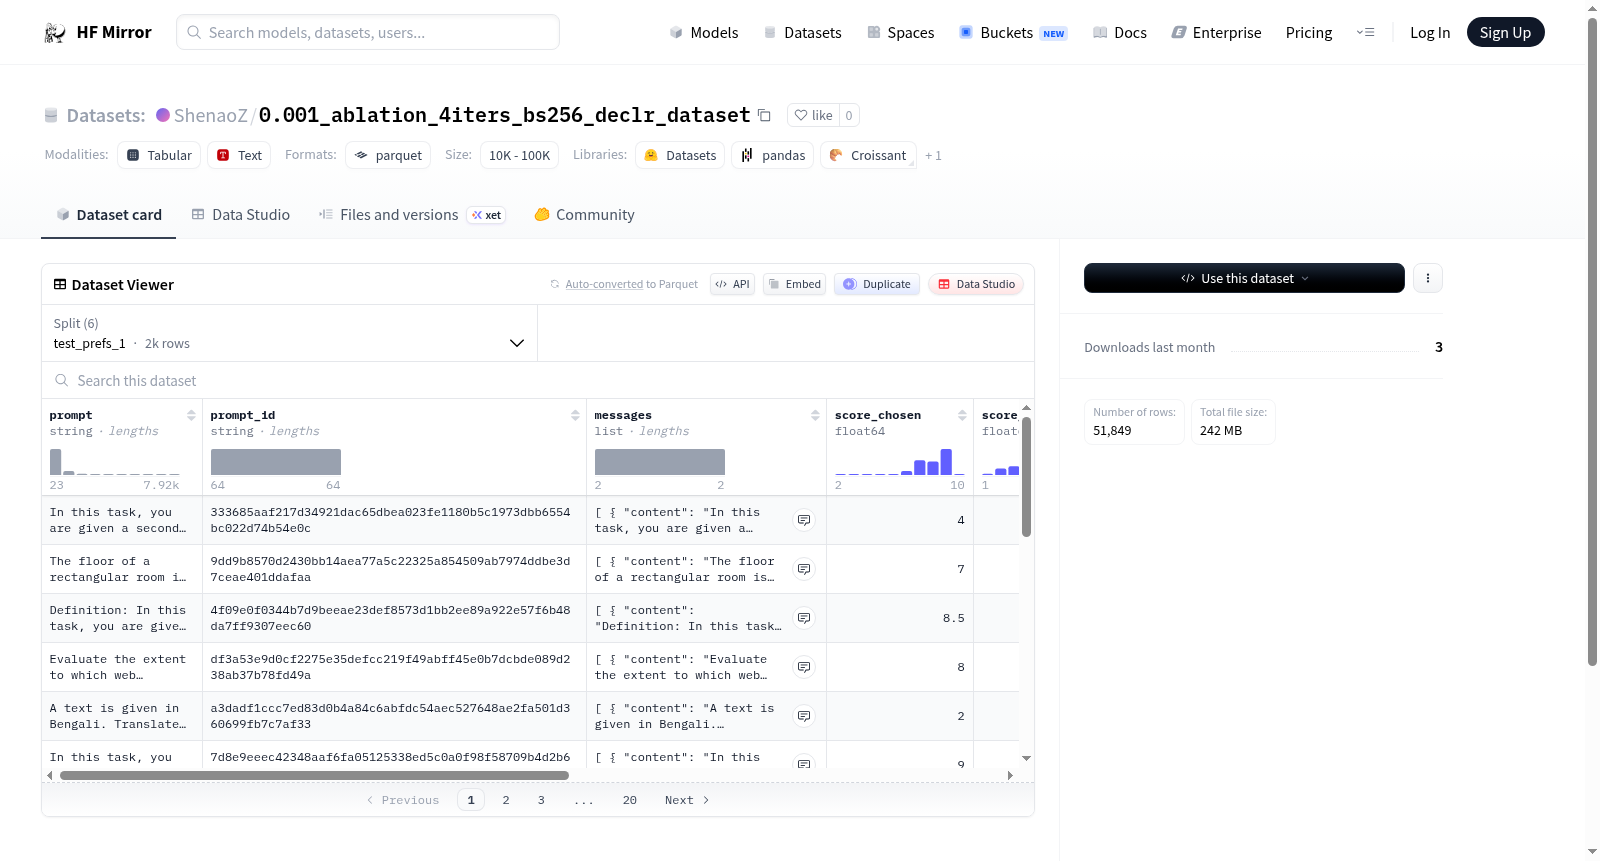
ShenaoZ/0.001_ablation_4iters_bs256_declr_dataset
收藏资源简介:
--- dataset_info: features: - name: prompt dtype: string - name: prompt_id dtype: string - name: messages list: - name: content dtype: string - name: role dtype: string - name: score_chosen dtype: float64 - name: score_rejected dtype: float64 - name: reference_response dtype: string - name: chosen list: - name: content dtype: string - name: role dtype: string - name: rejected list: - name: content dtype: string - name: role dtype: string splits: - name: test_prefs_1 num_bytes: 17324928 num_examples: 2000 - name: train_prefs_1 num_bytes: 132033790 num_examples: 15283 - name: test_prefs_2 num_bytes: 16914327 num_examples: 2000 - name: train_prefs_2 num_bytes: 130331686 num_examples: 15283 - name: test_prefs_3 num_bytes: 16762482 num_examples: 2000 - name: train_prefs_3 num_bytes: 128728639 num_examples: 15283 download_size: 242350753 dataset_size: 442095852 configs: - config_name: default data_files: - split: test_prefs_1 path: data/test_prefs_1-* - split: train_prefs_1 path: data/train_prefs_1-* - split: test_prefs_2 path: data/test_prefs_2-* - split: train_prefs_2 path: data/train_prefs_2-* - split: test_prefs_3 path: data/test_prefs_3-* - split: train_prefs_3 path: data/train_prefs_3-* --- # Dataset Card for "0.001_ablation_4iters_bs256_declr_dataset" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)
数据集信息: 特征: - 字段名:prompt,数据类型:字符串(string) - 字段名:prompt_id,数据类型:字符串(string) - 字段名:messages,类型为列表,列表元素包含: - content:内容,数据类型:字符串(string) - role:角色,数据类型:字符串(string) - 字段名:score_chosen,数据类型:64位浮点型(float64) - 字段名:score_rejected,数据类型:64位浮点型(float64) - 字段名:reference_response,数据类型:字符串(string) - 字段名:chosen,类型为列表,列表元素包含: - content:内容,数据类型:字符串(string) - role:角色,数据类型:字符串(string) - 字段名:rejected,类型为列表,列表元素包含: - content:内容,数据类型:字符串(string) - role:角色,数据类型:字符串(string) 数据集拆分: - 拆分名称:test_prefs_1,字节大小:17324928,样本数量:2000 - 拆分名称:train_prefs_1,字节大小:132033790,样本数量:15283 - 拆分名称:test_prefs_2,字节大小:16914327,样本数量:2000 - 拆分名称:train_prefs_2,字节大小:130331686,样本数量:15283 - 拆分名称:test_prefs_3,字节大小:16762482,样本数量:2000 - 拆分名称:train_prefs_3,字节大小:128728639,样本数量:15283 下载总大小:242350753 字节,数据集总字节大小:442095852 字节 配置项: - 配置名称:default,数据文件: - 拆分test_prefs_1:路径为data/test_prefs_1-* - 拆分train_prefs_1:路径为data/train_prefs_1-* - 拆分test_prefs_2:路径为data/test_prefs_2-* - 拆分train_prefs_2:路径为data/train_prefs_2-* - 拆分test_prefs_3:路径为data/test_prefs_3-* - 拆分train_prefs_3:路径为data/train_prefs_3-* --- # 数据集卡片:"0.001_ablation_4iters_bs256_declr_dataset" [更多信息待补充](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)
数据集概述
数据集名称
"0.001_ablation_4iters_bs256_declr_dataset"
数据集特征
- prompt (字符串类型)
- prompt_id (字符串类型)
- messages (列表类型,包含以下子特征)
- content (字符串类型)
- role (字符串类型)
- score_chosen (浮点数类型,64位)
- score_rejected (浮点数类型,64位)
- reference_response (字符串类型)
- chosen (列表类型,包含以下子特征)
- content (字符串类型)
- role (字符串类型)
- rejected (列表类型,包含以下子特征)
- content (字符串类型)
- role (字符串类型)
数据集分割
- test_prefs_1
- 字节数: 17324928
- 示例数: 2000
- train_prefs_1
- 字节数: 132033790
- 示例数: 15283
- test_prefs_2
- 字节数: 16914327
- 示例数: 2000
- train_prefs_2
- 字节数: 130331686
- 示例数: 15283
- test_prefs_3
- 字节数: 16762482
- 示例数: 2000
- train_prefs_3
- 字节数: 128728639
- 示例数: 15283
数据集大小
- 下载大小: 242350753字节
- 数据集大小: 442095852字节
配置信息
- config_name: default
- data_files (按分割列出文件路径模式)
- test_prefs_1: data/test_prefs_1-*
- train_prefs_1: data/train_prefs_1-*
- test_prefs_2: data/test_prefs_2-*
- train_prefs_2: data/train_prefs_2-*
- test_prefs_3: data/test_prefs_3-*
- train_prefs_3: data/train_prefs_3-*