
D-ExpTracker__qwen25_15b_instruct_bestofn_atags_countdown_4arg_10__v1
收藏数据链接:
官方服务:
资源简介:
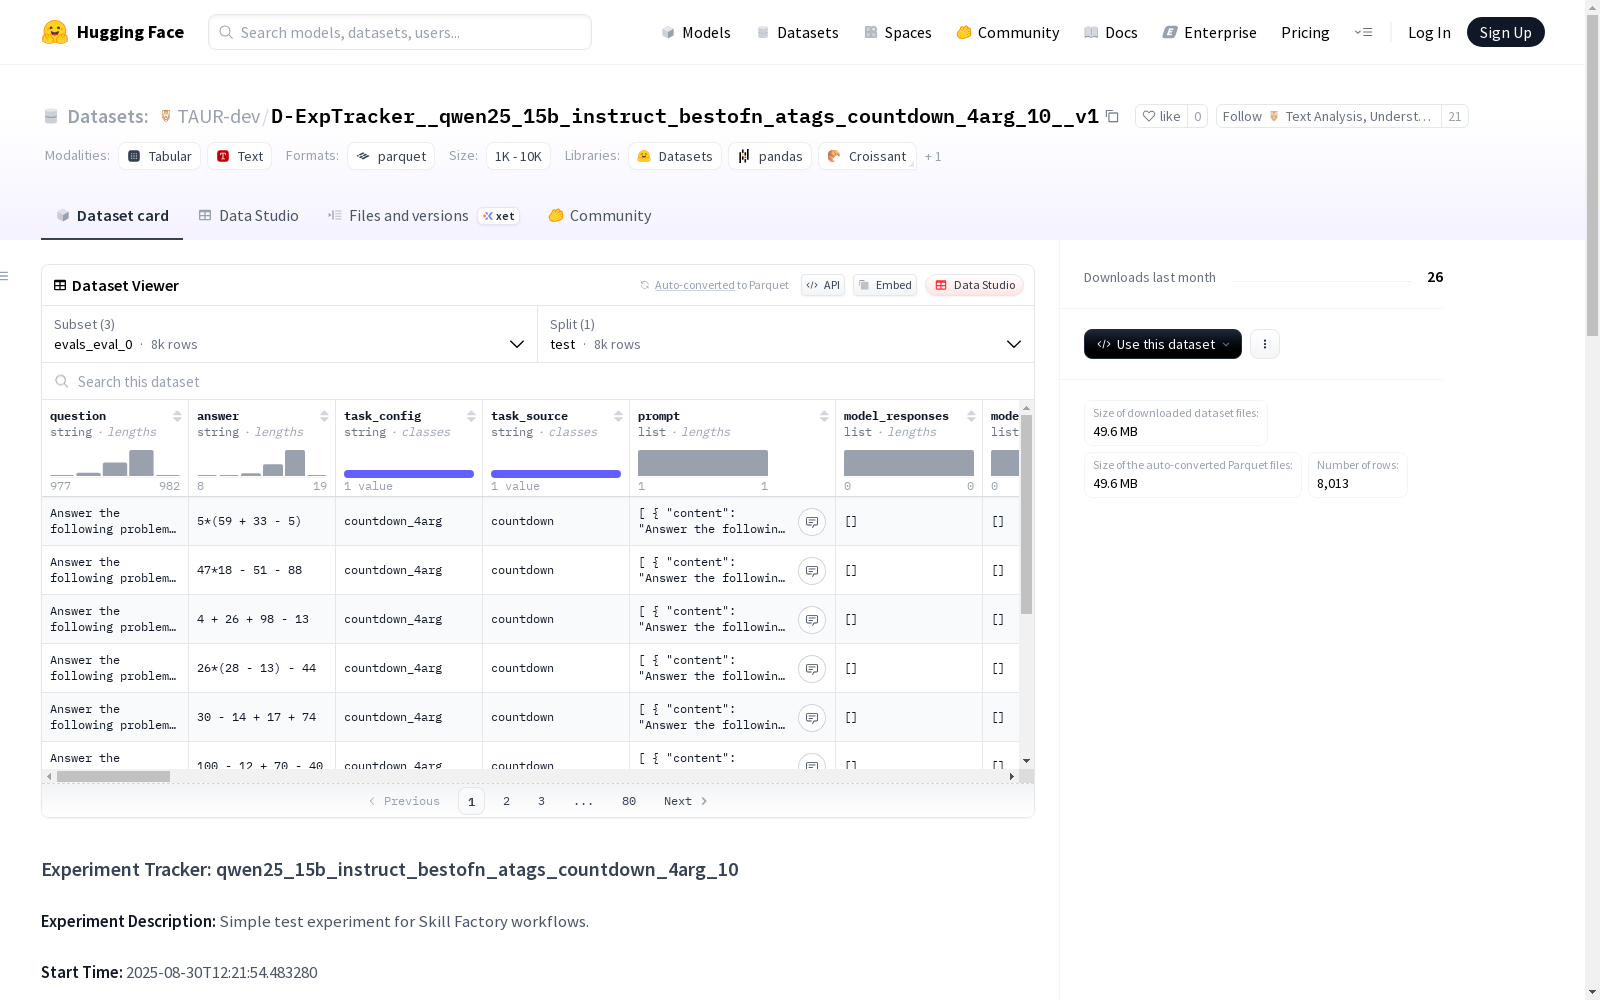
该数据集是用于Skill Factory工作流的简单测试实验,包含了问题、答案、任务配置、任务来源、提示以及模型响应等多个特征的实验数据。
This dataset is a simple test experiment for the Skill Factory workflow, which contains experimental data with multiple features including questions, answers, task configurations, task sources, prompts, and model responses.
创建时间:
2025-08-30
原始信息汇总
数据集概述
基本信息
- 数据集名称: D-ExpTracker__qwen25_15b_instruct_bestofn_atags_countdown_4arg_10__v1
- 实验描述: Simple test experiment for Skill Factory workflows
- 开始时间: 2025-08-30T12:21:54.483280
- 总阶段数: 1
数据集配置
evals_eval_0 配置
- 特征字段:
- question (字符串)
- answer (字符串)
- task_config (字符串)
- task_source (字符串)
- prompt (列表结构,包含content和role字段)
- model_responses (序列)
- model_responses__eval_is_correct (序列)
- all_other_columns (字符串)
- original_split (字符串)
- metadata (字符串)
- model_responses__best_of_n_atags (字符串序列)
- model_responses__best_of_n_atags__finish_reason_length_flags (布尔序列)
- model_responses__best_of_n_atags__length_partial_responses (字符串序列)
- prompt__best_of_n_atags__metadata (结构体,包含api_url、backend、chat_template_applied、generation_params、model_name、prompt等字段)
- model_responses__best_of_n_atags__metadata (结构体,包含backend、model_name、n_responses字段)
- model_responses__best_of_n_atags__eval_is_correct (布尔序列)
- model_responses__best_of_n_atags__eval_extracted_answers (字符串序列)
- model_responses__best_of_n_atags__eval_extraction_metadata (列表,包含extraction_type、non_overlapping_spans、original_span、span_end、span_start、total_spans_found字段)
- model_responses__best_of_n_atags__eval_evaluation_metadata (列表,包含answer_block、error、evaluation_method、extraction_result、final_answer、is_correct、reason字段)
- model_responses__best_of_n_atags__internal_answers__eval_is_correct (布尔序列的序列)
- model_responses__best_of_n_atags__internal_answers__eval_extracted_answers (字符串序列的序列)
- model_responses__best_of_n_atags__internal_answers__eval_extraction_metadata (列表的列表,包含confidence、extraction_type、original_span、pattern_used、position、span_end、span_start、span_text字段)
- model_responses__best_of_n_atags__internal_answers__eval_evaluation_metadata (列表的列表,包含answer_block、error、final_answer、is_correct字段)
- model_responses__best_of_n_atags__metrics (结构体,包含flips_by、flips_total、num_correct、pass_at_n、percent_correct、skill_count、total_responses字段)
- eval_date (字符串)
- split (字符串)
- revision_name (字符串)
- model_path (字符串)
- checkpoint_step (整型)
- stage_name (字符串)
- stage_number (整型)
- timestamp (字符串)
- eval_repo_id (字符串)
- 测试集: 8,000个样本,129,048,267字节
- 下载大小: 29,644,260字节
- 数据集大小: 129,048,267字节
logs__evaluation_eval_0 配置
- 特征字段:
- timestamp (字符串)
- end_timestamp (字符串)
- stage_name (字符串)
- stage_number (整型)
- level (字符串)
- message (字符串)
- stdout_content (字符串)
- stderr_content (字符串)
- experiment_name (字符串)
- elapsed_time_seconds (浮点型)
- stage_complete (布尔型)
- 训练集: 2个样本,299,773,281字节
- 下载大小: 19,942,093字节
- 数据集大小: 299,773,281字节
metadata 配置
- 特征字段:
- experiment_name (字符串)
- start_time (字符串)
- description (字符串)
- base_org (字符串)
- stage_number (字符串)
- stage_type (字符串)
- status (字符串)
- 训练集: 11个样本,16,588字节
- 下载大小: 8,806字节
- 数据集大小: 16,588字节
使用方式
可通过datasets库加载特定配置: python from datasets import load_dataset
加载实验元数据
metadata = load_dataset(TAUR-dev/D-ExpTracker__qwen25_15b_instruct_bestofn_atags_countdown_4arg_10__v1, experiment_metadata)
搜集汇总
数据集介绍
构建方式
在人工智能模型评估领域,D-ExpTracker数据集通过结构化实验追踪框架构建,采用多配置体系记录模型响应与评估数据。该数据集整合了问题-答案对、任务配置元数据及模型生成轨迹,通过best-of-n采样策略收集多维度响应序列,并嵌入自动化评估管道对模型输出进行正确性标注与答案提取。构建过程注重实验可复现性,完整保留了生成参数、时间戳及评估元数据,形成端到端的实验追踪体系。
使用方法
研究人员可通过HuggingFace数据集库加载特定配置进行深入分析,使用load_dataset函数分别调用评估结果、实验元数据或训练日志等模块。典型应用场景包括模型响应质量评估、生成策略对比研究和技能掌握度分析。用户可依据model_responses序列研究多采样响应的一致性,通过eval_evaluation_metadata分析答案提取效果,或利用metrics结构进行宏观性能统计。数据集支持跨实验对比研究,其结构化设计便于集成到自动化评估流水线中。
背景与挑战
背景概述
在人工智能研究领域,实验追踪与模型评估数据集作为支撑大语言模型系统化开发的重要基础设施,由TAUR-dev研究团队于2025年创建。该数据集专注于记录Qwen2.5-15B-Instruct模型在Best-of-N采样策略下的多轮对话性能评估数据,核心研究问题在于通过结构化实验数据追踪来解决模型迭代过程中的可复现性与性能分析难题。其创新性地整合了模型响应序列、评估元数据及实验日志等多维信息,为大语言模型的系统性优化提供了关键数据支撑,显著推动了实验管理标准化进程。
当前挑战
该数据集面临的领域挑战主要体现在大语言模型多轮对话评估的复杂性上,需要精准捕捉模型在Best-of-N采样策略下的响应质量波动与一致性表现。构建过程中的技术挑战包括:多维度评估指标的系统化整合,特别是对模型响应正确性、提取答案准确性和内部一致性指标的同步追踪;实验元数据与评估结果的高效关联存储,确保数据溯源性与可解释性;以及大规模评估数据(含8000个样本)的标准化处理与存储优化,避免数据结构冗余的同时保持扩展性。
常用场景
经典使用场景
在大型语言模型训练与评估领域,该数据集作为实验追踪系统的核心载体,专门记录Qwen-25B模型在最佳N采样策略下的多轮对话性能。其结构化存储了从问题生成、模型响应到自动评估的全流程数据,为研究者提供了可复现的实验框架。通过标准化记录模型在计数任务中的表现指标,该数据集成为比较不同采样策略效果的基准平台。
解决学术问题
该数据集有效解决了大语言模型迭代过程中实验可复现性差的学术难题。通过完整保存每次实验的超参数配置、响应序列和评估元数据,研究者能够精确分析模型行为模式。其提供的多维度评估指标(如正确率、响应翻转次数等)为理解模型推理机制提供了量化依据,显著推进了语言模型透明化研究进程。
实际应用
在实际工业场景中,该数据集支撑着智能对话系统的持续优化 pipeline。企业可依据其记录的模型响应质量数据,针对性调整生成策略参数。教育科技领域借助其构建的评估体系,能够开发更可靠的数学推理辅助工具。该数据集提供的标准化评估框架,已成为部署前模型性能验证的重要依据。
数据集最近研究
最新研究方向
在大型语言模型评估领域,D-ExpTracker数据集聚焦于多轮对话系统的精确性能度量,其结构化评估框架支持对模型响应质量、答案提取准确性和推理链可靠性的多维分析。当前研究热点集中于利用最佳N采样策略优化模型输出稳定性,通过反射机制和投票系统提升复杂问题求解能力。该数据集为自动化评估体系提供了可复现的实验基准,推动了对模型内部决策过程的可解释性研究,对构建下一代可信人工智能系统具有重要支撑作用。
以上内容由遇见数据集搜集并总结生成


