遇见数据集

ValerianFourel/geodml-papersize

收藏
Hugging Face2026-05-24 更新2026-05-31 收录
官方服务:

资源简介:

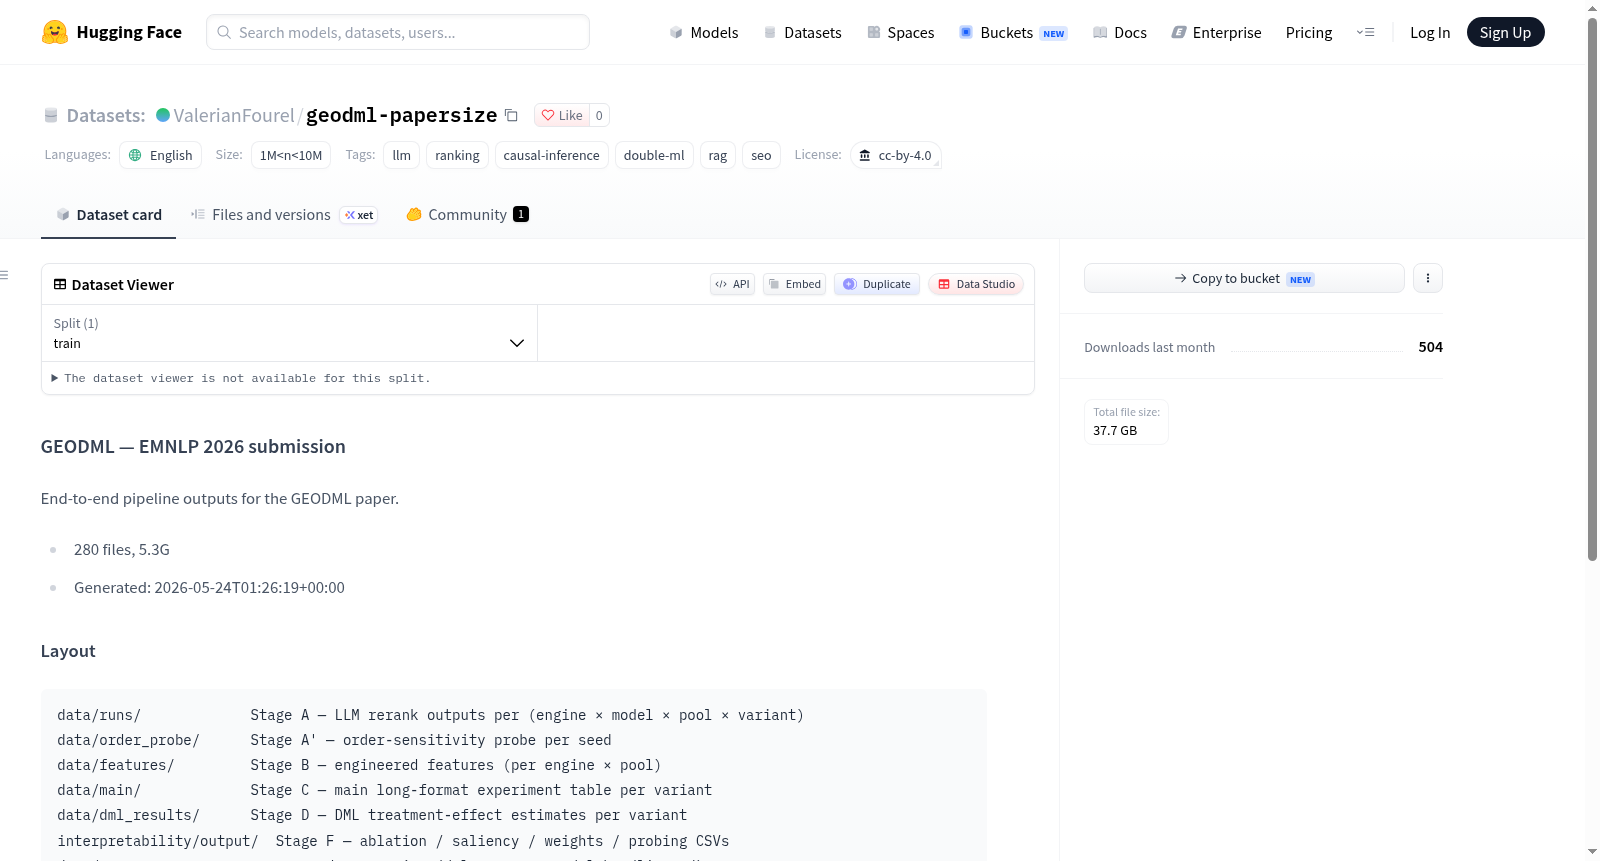
--- license: cc-by-4.0 language: en pretty_name: GEODML — Generative-Engine Optimization Double Machine Learning size_categories: - 1M<n<10M tags: - llm - ranking - causal-inference - double-ml - rag - seo --- # GEODML — EMNLP 2026 submission End-to-end pipeline outputs for the GEODML paper. - 280 files, 5.3G - Generated: 2026-05-24T01:26:19+00:00 ## Layout ``` data/runs/ Stage A — LLM rerank outputs per (engine × model × pool × variant) data/order_probe/ Stage A' — order-sensitivity probe per seed data/features/ Stage B — engineered features (per engine × pool) data/main/ Stage C — main long-format experiment table per variant data/dml_results/ Stage D — DML treatment-effect estimates per variant interpretability/output/ Stage F — ablation / saliency / weights / probing CSVs docs/ paper-ready summaries (dml_summary_*, dml_headline.md) ``` ## Headline DML estimates See `docs/dml_headline.md` for the canonical PLR+LightGBM estimates, pooled across (engine × pool × model) subsets per (variant × treatment × outcome). ## Citation If you use this dataset, please cite the GEODML paper (EMNLP 2026).

GEODML (Generative-Engine Optimization Double Machine Learning) is a dataset submitted for EMNLP 2026, containing end-to-end pipeline outputs. This dataset focuses on generative engine optimization and double machine learning methods, covering stages such as LLM reranking, feature engineering, and treatment effect estimation. It includes 280 files with a total size of 5.3 GB, and was generated on May 24, 2026. Its structure encompasses multiple stages: Stage A (LLM reranking outputs), Stage A (sequential sensitivity probes), Stage B (engineered features), Stage C (main experimental tables), Stage D (DML treatment effect estimation), and interpretability outputs. This dataset is applicable to tasks including LLMs, ranking, causal inference, double machine learning, and RAG.
提供机构:
ValerianFourel
搜集汇总
数据集介绍
ValerianFourel/geodml-papersize 数据集图片
构建方式
在生成式引擎优化与因果推断交叉领域,GEODML数据集以端到端流水线方式构建,覆盖从大语言模型重排序到双重机器学习效应估计的完整实验链条。其构建始于多种引擎、模型、池与变体组合下的LLM重排序输出,继而通过顺序敏感性探测、特征工程、长格式主实验表构建,最终以双重机器学习方法估计处理效应,并辅以消融、显著性、权重与探测分析。整套流程产生280个文件,总规模约5.3GB,数据生成时间戳为2026年5月24日,确保了实验环节的可追溯性与可复现性。
特点
该数据集在规模与结构上兼具广度与深度,体积介于1M至10M样本区间,涵盖英语语境下的排名、因果推断、双重机器学习、检索增强生成与搜索引擎优化等多重标签。其核心特征在于分层布局:运行目录记录引擎与模型维度的重排序结果,顺序探测目录捕捉种子级敏感性,特征目录与主实验目录分别承载工程化特征及长格式实验表,双重机器学习结果目录给出处理效应估计,可解释性输出目录则提供消融与显著性证据。文档目录中汇总了论文级摘要与头条估计,便于直接引用。
使用方法
研究者可依据目录结构按阶段调用数据:从运行目录获取LLM重排序输出以复现基础排序行为,利用顺序探测目录评估种子稳定性,借助特征目录与主实验目录进行特征分析与主效应建模,通过双重机器学习结果目录提取处理效应估计值,并参考可解释性输出目录完成消融与显著性检验。文档目录中的摘要文件与头条估计文件为快速把握核心结论提供便利。若在研究中采用该数据集,应按照EMNLP 2026投稿论文的引用要求进行规范引用,以确保学术溯源的完整性。
背景与挑战
背景概述
在生成式引擎优化(Generative Engine Optimization, GEO)逐渐成为信息检索与自然语言处理交叉前沿的背景下,GEODML数据集应运而生,作为EMNLP 2026投稿论文的配套资源,由相关研究团队于2026年构建。其核心研究问题在于如何利用双机器学习(Double Machine Learning, DML)框架,因果识别生成式引擎中排序策略对内容曝光与用户行为的干预效应。该数据集整合了多引擎、多模型、多池化策略下的LLM重排序输出与因果效应估计,为检索增强生成(RAG)与因果推断的融合提供了大规模实证基础,对推动生成式搜索的公平性、可解释性与策略优化具有潜在影响力。
当前挑战
GEODML所直面的领域问题在于生成式引擎排序机制中因果效应估计的复杂性:传统相关性度量难以剥离混杂因素,而动态交互环境下的干预识别更易受排序敏感性与模型异质性干扰。构建过程中,数据集需协调多阶段流水线(从LLM重排序到DML估计)的一致性,处理高达5.3G、280个文件的异构输出,并确保跨引擎、跨池化策略的特征工程与治疗效应估计可复现。此外,顺序敏感性探针与消融分析进一步加剧了数据标注与计算资源管理的难度,对因果假设的稳健性提出了严峻考验。
常用场景
经典使用场景
在信息检索与生成式引擎优化的交叉领域,GEODML数据集为评估大语言模型重排序策略的因果效应提供了标准化实验场。其经典使用场景依托Stage A至Stage F的层次化流水线:研究者首先利用LLM对候选文档进行重排序,继而通过顺序敏感性探针检验排序稳定性,随后提取工程化特征并构建长格式实验表,最终借助双重机器学习(DML)估计不同处理变量对排序结果的因果影响。该数据集以引擎、模型、候选池与变体为多维划分,支持对生成式引擎排序机制的精细归因分析。
衍生相关工作
基于GEODML数据集及其配套的EMNLP 2026论文,已衍生出一系列围绕生成式引擎优化与因果机器学习的经典工作。其中,PLR+LightGBM的DML估计框架被后续研究拓展至多处理变量与连续处理场景,催生了针对LLM排序稳定性的顺序敏感度分析方法;Stage F的可解释性输出则启发了基于显著性归因与探针诊断的排序特征研究。部分工作进一步将数据集的跨引擎实验设计迁移至多模态检索与对话式搜索场景,形成了从单一排序任务向复杂生成式交互系统延伸的研究脉络,持续丰富着因果推断在信息检索中的应用图景。
数据集最近研究
最新研究方向
在大语言模型驱动信息检索与生成式引擎优化的交叉领域,该数据集聚焦于利用双机器学习框架对生成式引擎优化中的因果效应进行严谨估计。针对传统相关性排序评估难以剥离混杂因素的瓶颈,研究者借助去偏机器学习方法,将引擎、模型与池化策略的多维组合纳入统一因果推断流程,并引入顺序敏感探针以检验输出稳定性。这一方向与当前检索增强生成系统对可信归因的迫切需求高度契合,为生成式搜索中的策略干预提供了可复现的基准,推动了因果推断与信息检索的深度融合。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务