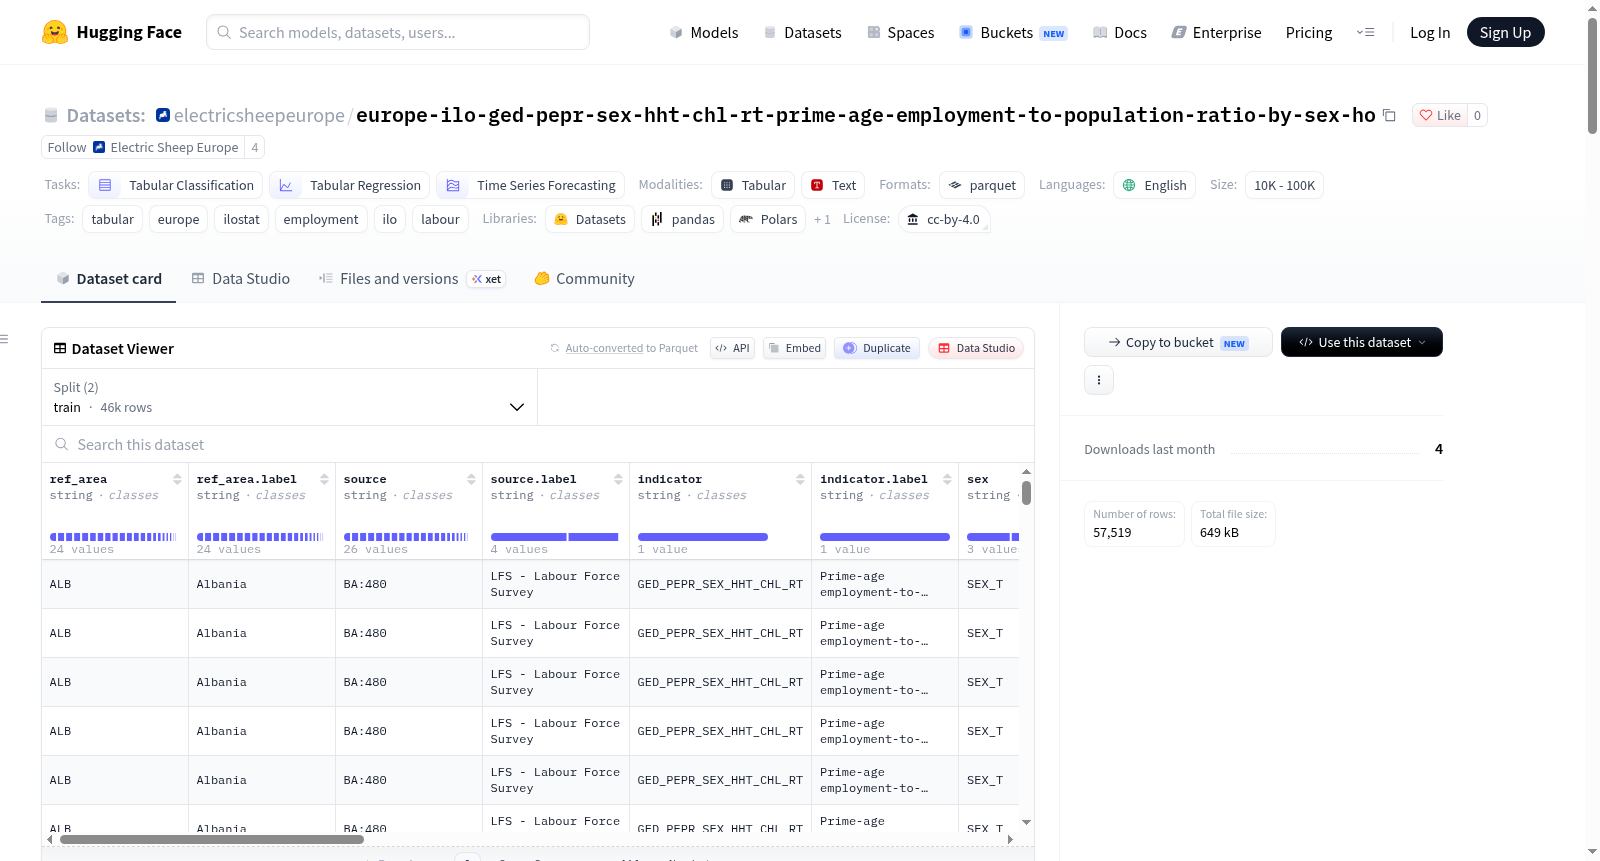
electricsheepeurope/europe-ilo-ged-pepr-sex-hht-chl-rt-prime-age-employment-to-population-ratio-by-sex-ho
收藏资源简介:
该数据集包含欧洲30个国家从2000年至2024年的57,519个观测值,专注于黄金年龄就业人口比按性别、家庭类型和是否有孩子划分(%)这一指标。数据来源于国际劳工组织(ILO)的ILOSTAT统计数据库,通过API获取并过滤为欧洲国家。数据集涵盖了就业统计,包括按性别(总计、男性、女性)、家庭类型和是否有孩子等维度进行细分,适用于表格分类、回归和时间序列预测等任务。数据以结构化表格形式提供,包含国家代码、来源、指标、时间、观测值及质量标志等列,并附有使用示例和注意事项。
license: CC-BY-4.0 language: - en task_categories: - 表格分类 - 表格回归 - 时间序列预测 multilinguality: 单语言 size_categories: - 10000 < 样本数 < 100000 tags: - 表格数据 - 欧洲 - ILOSTAT - 就业 - 国际劳工组织(ILO) - 劳动 pretty_name: "按性别、家庭类型及子女存在情况划分的适龄劳动人口就业人口比(欧洲,ILOSTAT)" # 按性别、家庭类型及子女存在情况划分的适龄劳动人口就业人口比(欧洲,ILOSTAT) 🇪🇺 **57519条观测样本** · **30个欧洲国家** · **2000–2024年** · *由[Electric Sheep Europe](https://huggingface.co/electricsheepeurope)重新封装发布*      ## 快速概览 本数据集包含覆盖30个欧洲国家、时间跨度为2000至2024年的就业相关数据,共计**57519条观测样本**,仅包含**1项独立指标**。 ## 数据来源说明 **国际劳工组织统计数据库(ILOSTAT)**是国际劳工组织(ILO)的官方中央统计数据库,也是全球领先的劳动统计权威数据源。该库整合了就业、失业、薪资、工作时长、童工、非正规经济、社会保障、职业伤害以及可持续发展目标(SDG)体面工作目标等多类指标,数据来源涵盖全国劳动力调查、家庭收入调查、机构调查及行政记录。其覆盖全球200余个经济体,由国际劳工组织统计司负责数据的标准化协调。 - **数据来源**:[ILOSTAT](https://www.ilo.org/shinyapps/bulkexplorer/?id=GED_PEPR_SEX_HHT_CHL_RT) - **发布方**:国际劳工组织(ILO) - **许可证**:[CC-BY-4.0](https://creativecommons.org/licenses/by/4.0/) - **研究主题**:就业 ## 研究方法 数据直接从ILOSTAT的REST API接口`https://rplumber.ilo.org/data/indicator?id=GED_PEPR_SEX_HHT_CHL_RT`获取,并筛选出欧洲地区的ISO3国家代码。ILOSTAT采用国际劳工统计学家会议(International Conference of Labour Statisticians, ICLS)的定义对原始调查微观数据进行标准化协调;数据来源信息将在`source.label`字段中标记,以保证可追溯性。 ## 地理覆盖范围 30个欧洲国家。以下按样本行数排序展示部分国家: | 国家代码 | 样本行数 | 起始年份 | 终止年份 | |---------|-----:|-----------:|----------:| | `AUT` | 2,810 | 2000 | 2023 | | `BEL` | 2,808 | 2000 | 2023 | | `DEU` | 2,803 | 2000 | 2023 | | `HUN` | 2,788 | 2000 | 2023 | | `ESP` | 2,780 | 2000 | 2023 | | `ROU` | 2,767 | 2000 | 2023 | | `SVN` | 2,719 | 2000 | 2023 | | `EST` | 2,666 | 2000 | 2023 | | `LVA` | 2,601 | 2001 | 2023 | | `BGR` | 2,547 | 2001 | 2023 | | `LTU` | 2,528 | 2002 | 2023 | | `GRC` | 2,487 | 2001 | 2024 | | `HRV` | 2,433 | 2002 | 2023 | | `NLD` | 2,383 | 2000 | 2020 | | `GBR` | 2,380 | 2000 | 2019 | | ... | _其余15个国家_ | | | ## 指标(示例) - `GED_PEPR_SEX_HHT_CHL_RT` — 按性别、家庭类型及子女存在情况划分的适龄劳动人口就业人口比(%) ## 数据结构 | 字段名 | 数据类型 | 字段说明 | 示例值 | |--------|------|-------------|---------| | `ref_area` | `string` | ISO 3166-1 alpha-3 国家代码 | `ALB` | | `ref_area.label` | `string` | 英文国家名称 | `Albania` | | `source` | `string` | ILOSTAT 来源代码(例如劳动力调查) | `BA:480` | | `source.label` | `string` | 英文来源名称 | `LFS - 劳动力调查` | | `indicator` | `string` | ILOSTAT 指标代码 | `GED_PEPR_SEX_HHT_CHL_RT` | | `indicator.label` | `string` | 英文指标名称 | `Prime-age employment-to-population ra…` | | `sex` | `string` | 按性别分组(SEX_T = 总计,SEX_M = 男性,SEX_F = 女性) | `SEX_T` | | `sex.label` | `string` | — | `总计` | | `classif1` | `string` | 第一分类变量(年龄、教育程度、身份等) | `HHT_AGGREGATE_TOTAL` | | `classif1.label` | `string` | — | `家庭类型:总计` | | `classif2` | `string` | 可选的第二分类变量 | `CHL_AGET6_TOTAL` | | `classif2.label` | `string` | — | `6岁以下子女存在情况:总计` | | `time` | `int64` | 观测年份 | `2023` | | `obs_value` | `float64` | 观测指标值(单位详见指标定义) | `79.344` | | `obs_status` | `string` | 观测状态标记(例如临时、不可靠) | `U` | | `obs_status.label` | `string` | — | `不可靠` | | `note_indicator` | `string` | — | `—` | | `note_indicator.label` | `string` | — | `—` | | `note_source` | `string` | — | `R1:3513` | | `note_source.label` | `string` | — | `Repository: ILO-STATISTICS - Micro da…` | ## 分解维度 以下字段提供数据分解维度: - **`sex`**(共3个唯一取值):`SEX_T`、`SEX_M`、`SEX_F` ## 数据质量与注意事项 - 数据为年度频率。部分指标同时发布月度或季度序列,但本数据集未包含此类数据。 - 当同一国家×年份的同一指标存在多个数据源时,将采用国际劳工组织选定的“最优数据源”。 - 分解维度字段(`sex`、`classif1`、`classif2`)仅在指标支持对应细分时非空。 ## 使用方法 使用以下Python代码加载本数据集并转换为Pandas DataFrame: python from datasets import load_dataset ds = load_dataset("electricsheepeurope/europe-ilo-ged-pepr-sex-hht-chl-rt-prime-age-employment-to-population-ratio-by-sex-ho") df = ds["train"].to_pandas() print(df.head()) ### 筛选单个国家数据 python germany = df[df["ref_area"] == "DEU"] ### 单指标时间序列可视化 python sample = (df[df["indicator"] == "GED_PEPR_SEX_HHT_CHL_RT"] .sort_values("time")) sample.plot(x="time", y="obs_value", title="GED_PEPR_SEX_HHT_CHL_RT") ### 转换为国家×年份矩阵 python matrix = (df[df["indicator"] == "GED_PEPR_SEX_HHT_CHL_RT"] .pivot_table(index="time", columns="ref_area", values="obs_value")) print(matrix.tail()) ## 引用格式 bibtex @misc{europe_ilo_ged_pepr_sex_hht_chl_rt_prime_age_employment_to_population_ratio_by_sex_ho_2024, title = {Prime-age employment-to-population ratio by sex, household type and presence of children ( | Europe (ILOSTAT)}, author = {International Labour Organization (ILO)}, year = {2024}, url = {https://www.ilo.org/shinyapps/bulkexplorer/?id=GED_PEPR_SEX_HHT_CHL_RT}, publisher = {HuggingFace Datasets, repackaged by Electric Sheep Europe}, howpublished = {url{https://huggingface.co/datasets/electricsheepeurope/europe-ilo-ged-pepr-sex-hht-chl-rt-prime-age-employment-to-population-ratio-by-sex-ho}} } ## 许可证 本数据集采用[CC-BY-4.0](https://creativecommons.org/licenses/by/4.0/)许可证发布。原始数据版权归国际劳工组织(ILO)所有。使用本数据集时,请同时引用上述原始数据源及Electric Sheep Europe的重新封装版本。 ## 关于Electric Sheep Electric Sheep Europe是Electric Sheep项目的组成部分,该项目旨在为HuggingFace平台构建统一的、适用于机器学习的欧洲地区数据层。我们从权威开源数据源获取数据,标准化数据结构,封装为Parquet格式,并发布格式统一的数据集卡片,使研究人员与开发者可通过`load_dataset()`函数在数秒内启动研究工作。 浏览完整数据集集合:[huggingface.co/electricsheepeurope](https://huggingface.co/electricsheepeurope) --- _数据溯源:2026年5月26日通过Electric Sheep流水线获取。源URL:https://www.ilo.org/shinyapps/bulkexplorer/?id=GED_PEPR_SEX_HHT_CHL_RT_