遇见数据集

income/fever-top-20-gen-queries

收藏
Hugging Face2023-01-24 更新2024-03-04 收录
官方服务:

资源简介:

BEIR基准是一个异构基准,由18个不同的数据集组成,代表了9个信息检索任务。这些任务包括事实核查、问答、生物医学信息检索、新闻检索、论点检索、重复问题检索、引用预测、推文检索和实体检索。数据集是单语的,所有任务均为英语。数据集结构包括语料库、查询和qrels(相关性判断文件),每种文件都有特定的格式。数据集支持一个排行榜,用于评估模型在任务特定指标上的表现。README还提到了使用DocT5query模型为NFCorpus数据集生成合成查询。

BEIR benchmark is a heterogeneous benchmark composed of 18 distinct datasets spanning 9 information retrieval tasks. These tasks include fact checking, question answering, biomedical information retrieval, news retrieval, argument retrieval, duplicate question retrieval, citation prediction, tweet retrieval, and entity retrieval. All datasets are monolingual, with all tasks conducted in English. The dataset structure consists of three core components: corpus, queries, and qrels (relevance judgment files), each with a specific format. The benchmark supports a leaderboard for evaluating model performance on task-specific metrics. The README also mentions using the DocT5query model to generate synthetic queries for the NFCorpus dataset.

提供机构:
income
原始信息汇总

数据集概述

  • 名称: BEIR Benchmark
  • 别名: BEIR
  • 语言: 英语 (en)
  • 许可证: CC-BY-SA-4.0
  • 多语言性: 单语
  • 任务类别: 文本检索

数据集组成

  • 大小分类:
    • msmarco: 1M<n<10M
    • trec-covid: 100k<n<1M
    • nfcorpus: 1K<n<10K
    • nq: 1M<n<10M
    • hotpotqa: 1M<n<10M
    • fiqa: 10K<n<100K
    • arguana: 1K<n<10K
    • touche-2020: 100K<n<1M
    • cqadupstack: 100K<n<1M
    • quora: 100K<n<1M
    • dbpedia: 1M<n<10M
    • scidocs: 10K<n<100K
    • fever: 1M<n<10M
    • climate-fever: 1M<n<10M
    • scifact: 1K<n<10K

数据集结构

  • 文件格式:
    • corpus: .jsonl 文件,包含文档的唯一标识符、标题和文本。
    • queries: .jsonl 文件,包含查询的唯一标识符和文本。
    • qrels: .tsv 文件,包含查询标识符、文档标识符和相关性评分。

数据集创建

  • 来源数据: 来自18个不同数据集,涵盖9种信息检索任务。
  • 预处理: 所有数据集已预处理,可供实验使用。

使用注意事项

  • 社会影响: 未提供详细信息。
  • 偏见讨论: 未提供详细信息。
  • 其他已知限制: 未提供详细信息。

附加信息

  • 数据集维护者: 未提供详细信息。

  • 许可证信息: 未提供详细信息。

  • 引用信息:

    @inproceedings{ thakur2021beir, title={{BEIR}: A Heterogeneous Benchmark for Zero-shot Evaluation of Information Retrieval Models}, author={Nandan Thakur and Nils Reimers and Andreas R{"u}ckl{e} and Abhishek Srivastava and Iryna Gurevych}, booktitle={Thirty-fifth Conference on Neural Information Processing Systems Datasets and Benchmarks Track (Round 2)}, year={2021}, url={https://openreview.net/forum?id=wCu6T5xFjeJ} }

  • 贡献者: 感谢 @Nthakur20 添加此数据集。

搜集汇总
数据集介绍
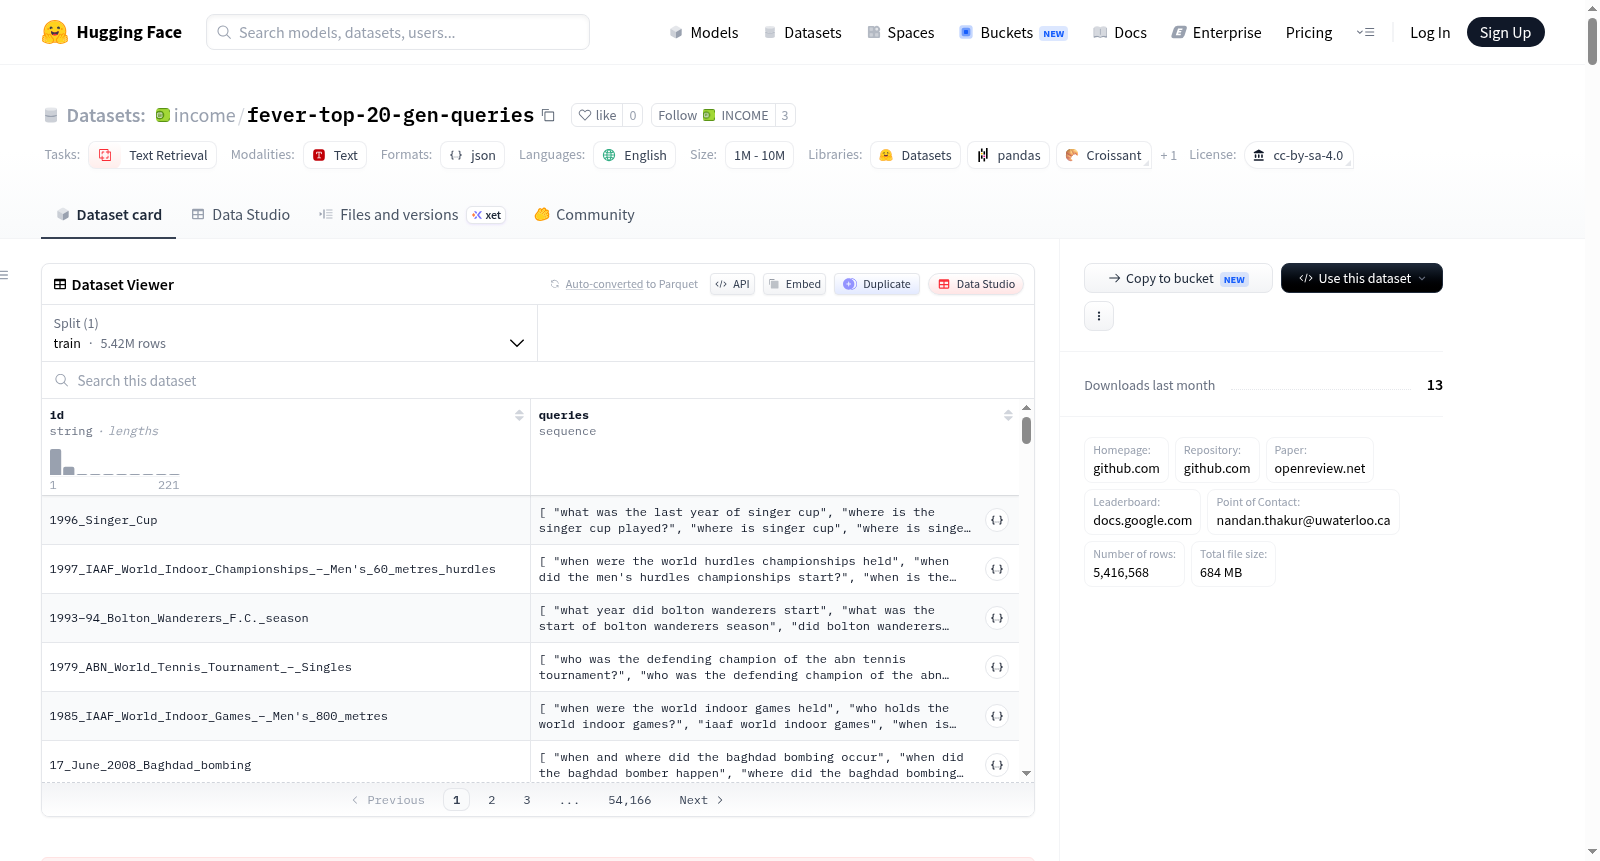
income/fever-top-20-gen-queries 数据集图片
构建方式
在信息检索领域,数据增强技术对于提升模型泛化能力至关重要。该数据集基于BEIR基准中的NFCorpus语料库构建,采用DocT5query模型(BeIR/query-gen-msmarco-t5-base-v1)为语料库中的每个段落生成合成查询。具体而言,对于NFCorpus中每一个具有唯一标识符(id)的文档,该模型通过序列到序列的生成范式,自动产出20条与之语义相关的问题。这一过程依托于evaluate_anserini_docT5query_parallel.py脚本实现并行化处理,从而高效地扩充了原始语料库的查询覆盖范围,为后续检索模型的训练与评估提供了丰富的伪查询数据。
使用方法
使用该数据集时,研究者可将其作为检索模型训练或评估的增强资源。具体而言,用户可通过HuggingFace Datasets库加载数据集,利用其中的文档标识符(id)与原始BEIR基准的corpus.jsonl文件进行关联。在训练阶段,可将每个文档对应的20条生成查询视为正例,结合负采样策略构建训练三元组,用于优化密集检索或稀疏检索模型。此外,这些合成查询也可直接用于文档扩展(DocT5Query)技术,即在索引阶段将生成的查询附加到原始文档文本中,以弥合查询与文档之间的词汇鸿沟。研究者还可基于这些数据评估模型对多样化查询表述的鲁棒性,从而推动信息检索系统的性能提升。
背景与挑战
背景概述
在信息检索领域,零样本迁移学习能力是评估模型泛化性能的关键指标。BEIR基准测试(Benchmark for Evaluation of Information Retrieval)由加拿大滑铁卢大学Nandan Thakur、德国达姆施塔特工业大学Nils Reimers等研究人员于2021年提出,旨在构建一个涵盖18个数据集、9类检索任务(如事实核查、问答、生物医学检索等)的异构评估框架。该基准的核心研究问题在于揭示现有检索模型在未见任务上的表现差距,其发布对推动信息检索领域从任务特定训练向通用检索范式转型产生了深远影响。其中,NFCorpus子集专注于生物医学领域,通过生成20条合成查询(采用DocT5query模型),为细粒度文档检索提供了更丰富的训练信号。
当前挑战
该数据集面临的挑战体现在两个层面。在领域问题层面,生物医学信息检索需应对专业术语歧义性、跨模态知识关联(如文本与实验数据的耦合)以及查询意图的隐晦表达,传统词匹配方法难以捕捉深层语义。在构建过程中,合成查询的生成依赖于预训练语言模型(如BeIR/query-gen-msmarco-t5-base-v1),可能引入噪声或偏离真实用户查询分布;同时,NFCorpus原始语料规模较小(约3600篇文档),导致合成查询的多样性受限,易产生语义冗余。此外,跨数据集迁移时的标注一致性(如qrels中相关性判定的主观偏差)进一步增加了评估的复杂性。
常用场景
经典使用场景
该数据集作为BEIR基准测试的组成部分,聚焦于信息检索领域的零样本评估场景。其核心用途在于为检索模型提供涵盖事实核查、问答、生物医学检索等9类任务的多样化测试平台,通过统一的预处理格式和标准化评估协议,衡量模型在未见任务上的泛化能力。研究者常利用其包含的NFCorpus等子集,评估稠密检索与稀疏检索方法在跨领域场景中的表现,尤其关注模型能否在缺乏领域内训练数据的情况下,依然精准定位相关文档。
解决学术问题
该数据集旨在解决信息检索领域长期存在的评估碎片化问题,即不同任务使用各异的数据格式与指标,导致模型性能难以横向比较。通过整合18个源自不同领域的子集,BEIR为学术界提供了首个统一的零样本检索基准,从而系统性地揭示现有模型在领域迁移时的性能衰退现象。其意义在于推动了检索模型泛化能力的研究,促使学界从追求单一任务最优转向关注跨任务鲁棒性,进而催生了对检索架构、训练策略及表示学习方法的深层反思与改进。
实际应用
在实际应用中,该数据集衍生的模型广泛用于构建跨领域的通用搜索引擎和知识库问答系统。例如,基于其训练出的检索器可部署于医疗文献检索平台,辅助医生快速定位临床试验证据;或应用于新闻聚合工具,实现跨主题的精准信息筛选。此外,其零样本特性使得企业能够在不标注海量领域数据的前提下,快速适配垂直场景的检索需求,如法律文书检索或科研论文推荐,显著降低部署成本并提升响应效率。
数据集最近研究
最新研究方向
在信息检索领域,基于BEIR基准的零样本评估范式正引领前沿研究方向,其中合成查询生成技术成为提升检索模型泛化能力的关键突破口。该数据集聚焦于NFCorpus生物医学文献语料,通过DocT5query模型为每篇文档生成20条合成查询,旨在解决传统检索任务中标注数据稀缺的瓶颈。这一方向与近期大语言模型驱动的查询扩展和文档增强热点紧密关联,特别是在事实核查、科学文献检索等需要精准语义匹配的场景中,合成查询能够有效弥合文档与真实用户查询之间的语义鸿沟。该研究不仅推动了检索增强生成(RAG)技术的发展,也为构建更鲁棒的零样本检索系统提供了高质量训练信号,对提升生物医学领域的信息获取效率具有深远影响。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务