
erkam/clevr-full-v5
收藏官方服务:
资源简介:
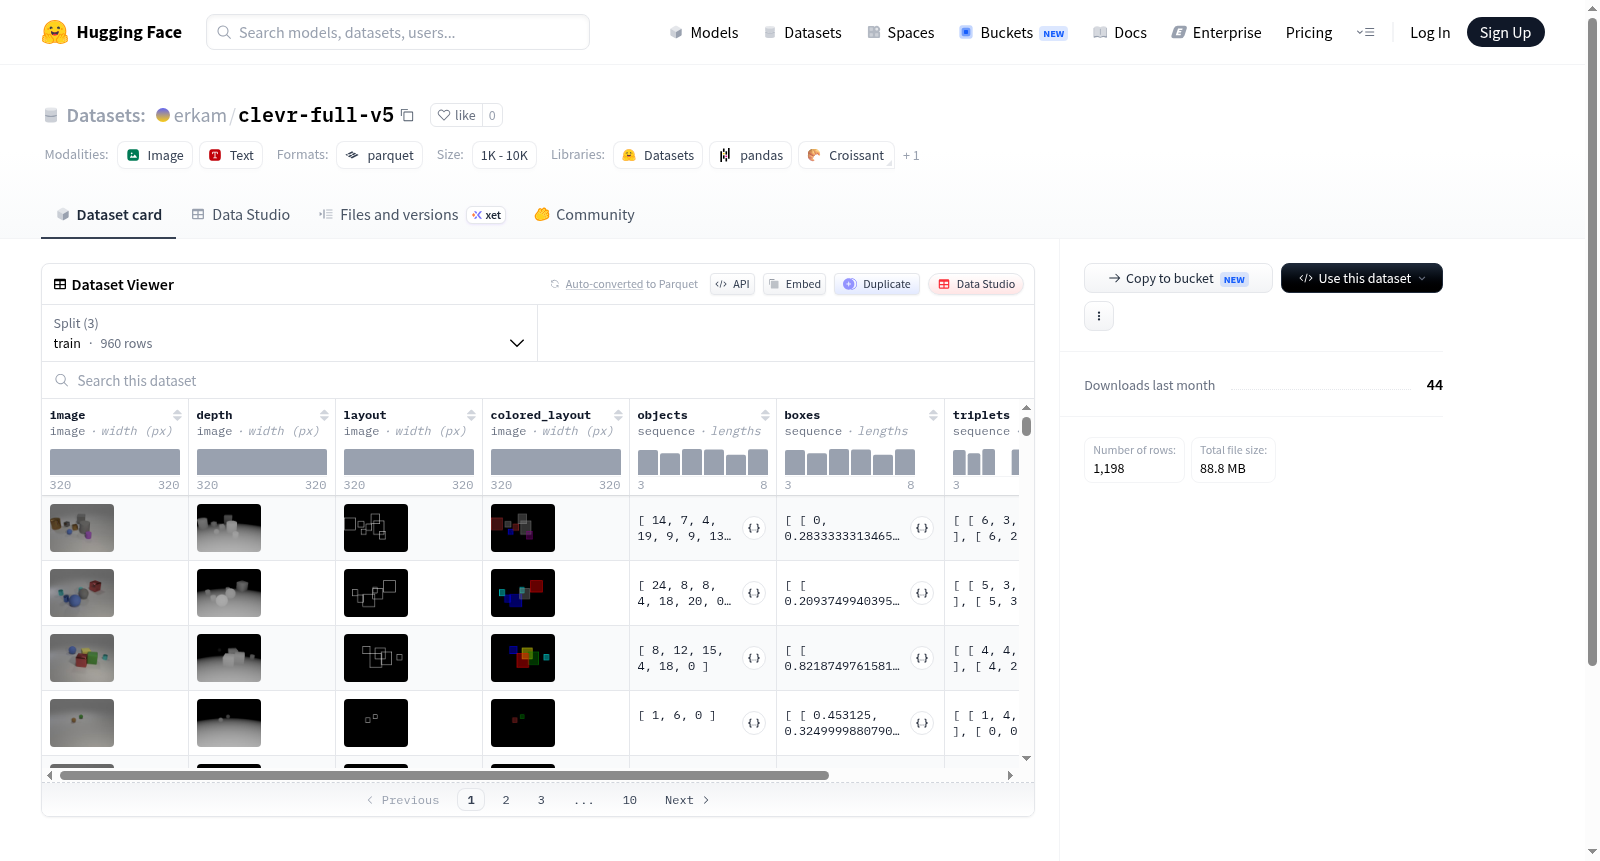
数据集clevr-full-v5包含25个对象和4种空间关系。数据集的特征包括图像、深度、布局、彩色布局、对象、边界框、三元组和对象字符串等信息。数据集被分为训练集、验证集和测试集,分别包含960、119和119个样本。
The dataset clevr-full-v5 contains 25 objects and 4 types of spatial relations. Its features include images, depth maps, layouts, colored layouts, objects, bounding boxes, triplets, and object strings. The dataset is split into training, validation, and test sets, which contain 960, 119, and 119 samples respectively.
提供机构:
erkam原始信息汇总
数据集概述
数据集配置
- 配置名称: default
- 数据文件:
- 训练集: data/train-*
- 验证集: data/val-*
- 测试集: data/test-*
数据集信息
特征
- 图像:
- 名称: image
- 数据类型: image
- 深度图:
- 名称: depth
- 数据类型: image
- 布局图:
- 名称: layout
- 数据类型: image
- 彩色布局图:
- 名称: colored_layout
- 数据类型: image
- 对象序列:
- 名称: objects
- 数据类型: int64
- 边界框序列:
- 名称: boxes
- 数据类型: float32
- 三元组序列:
- 名称: triplets
- 数据类型: int64
- 对象字符串:
- 名称: objects_str
- 数据类型: string
数据分割
- 训练集:
- 名称: train
- 字节数: 72217786.0
- 样本数: 960
- 验证集:
- 名称: val
- 字节数: 8935628.0
- 样本数: 119
- 测试集:
- 名称: test
- 字节数: 8912087.0
- 样本数: 119
数据集大小
- 下载大小: 88745185
- 数据集大小: 90065501.0
其他信息
- 对象数量: 25
- 空间关系数量: 4
搜集汇总
数据集介绍
构建方式
在计算机视觉与场景理解领域,精确的空间关系推理是模型智能评估的核心挑战。erkam/clevr-full-v5数据集基于经典的CLEVR框架构建,通过程序化生成技术创建了包含25个物体与4种空间关系的复杂场景。数据集包含960个训练样本、119个验证样本和119个测试样本,每个样本均提供原始图像、深度图、语义布局图及彩色布局图等多模态视觉信息。同时,数据以结构化的三元组形式记录物体间的空间关系,并附有物体类别字符串与边界框坐标,为场景解析任务提供了完整且标准化的标注体系。
特点
该数据集的显著特点在于其精细的物体数量与关系复杂度设计。相较于标准CLEVR数据集,v5版本将单场景物体数提升至25个,并限定为4种明确的二元空间关系,在保持可解释性的同时极大增强了场景的拥挤度与推理难度。多模态数据输出(图像、深度、布局)使模型能够从不同视觉层次学习特征,而三元组标注则直接服务于关系检测与场景图生成任务。此外,数据划分严格、样本规模适中,既适合快速迭代验证,又能有效评估模型在有限数据下的泛化能力。
使用方法
该数据集适用于训练和评估视觉推理模型,特别是需要理解物体间空间关系的任务。使用时可从HuggingFace Datasets库直接加载,默认配置下自动划分训练、验证与测试集。图像数据可直接输入卷积神经网络进行特征提取,深度与布局图可作为辅助监督信号或用于多任务学习。三元组与边界框信息适合构建场景图生成模型,而物体字符串标签则便于进行语义匹配与属性预测。研究者亦可将多模态输入融合,设计端到端的空间关系推理系统,以验证模型在复杂场景下的结构化理解能力。
背景与挑战
背景概述
CLEVR-full-v5数据集由研究团队于近年创建,旨在推进视觉推理与场景理解领域的研究。该数据集基于经典的CLEVR基准,但扩展至包含25个物体及4种空间关系,提供了更复杂的合成场景图像。核心研究问题聚焦于如何让模型从图像中精准解析物体属性、空间布局及关系三元组,从而评估视觉问答与推理系统的能力。通过提供多模态标注(包括图像、深度图、布局图及结构化物体信息),该数据集为计算机视觉与自然语言处理的交叉研究提供了关键资源,在推动可解释AI与组合式推理模型的发展中具有重要影响力。
当前挑战
数据集当前面临的核心挑战在于其合成场景与真实世界的差距,尽管物体数量与关系复杂度提升,但模型在泛化至自然图像时仍存在适应性难题。构建过程中,需精准标注25个物体的空间关系(如相对位置、遮挡),这对自动化渲染与标注流程的精度要求极高,物体间的微小重叠或视角变化可能导致标注歧义。此外,三元组关系(如‘A在B左侧且C在A上方’)的组合爆炸增加了数据平衡难度,部分稀有关系样本不足,易使模型产生偏差。这些挑战限制了数据集在复杂视觉推理任务中的鲁棒性验证效果。
常用场景
经典使用场景
CLEVR-Full-v5数据集作为视觉推理与场景理解领域的经典基准,其核心应用场景聚焦于多目标空间关系推理与结构化场景解析。该数据集包含25个物体及4种空间关系(如左、右、前、后),通过提供图像、深度图、布局图及彩色布局图等多模态输入,结合物体标签、边界框与三元组关系标注,为模型提供了从像素级感知到符号级推理的完整学习范式。研究者常利用该数据集训练模型回答复杂视觉问题,例如“位于红色立方体左侧的蓝色球体数量是多少”,从而系统评估模型在组合性推理、多跳推理及零样本泛化方面的能力。数据集的精细化标注设计使其成为验证神经符号系统、图神经网络及Transformer架构在结构化视觉任务中性能的理想平台。
衍生相关工作
该数据集催生了一系列具有里程碑意义的学术工作。在视觉推理领域,基于CLEVR任务提出的MAC网络(Memory, Attention, and Composition)首次将迭代注意力机制与显式推理步骤相结合,实现了对复杂多跳问题的可解释性回答。神经模块网络(Neural Module Networks)利用该数据集验证了动态网络组合策略在结构化推理中的有效性,为后续的模块化深度学习奠定了方法论基础。图神经网络方向的工作如Relation Networks和Graph Attention Networks,通过在该数据集上的优异表现证明了显式关系建模对视觉推理的重要性。近期,基于CLEVR-Full-v5的预训练策略研究(如CLIP与ViT的变体)进一步揭示了大规模视觉语言模型在组合性泛化上的能力边界,推动了视觉推理与自然语言理解的深度融合。
数据集最近研究
最新研究方向
在计算机视觉与自然语言处理的交叉领域,场景理解与视觉推理能力的提升成为前沿热点。CLEVR数据集作为经典的合成图像视觉推理基准,其最新版本clevr-full-v5通过引入25个物体及4种空间关系,为复杂场景中的组合式推理任务提供了更精细的标注资源。该数据集不仅包含图像、深度图和布局信息,还提供了物体属性、边界框及关系三元组,有力支撑了基于图神经网络和Transformer架构的视觉推理模型研究。近期研究聚焦于利用该数据集训练模型在零样本或少样本条件下进行关系推理,并与神经符号系统结合以增强可解释性。其影响在于推动视觉问答从简单识别迈向深层逻辑推理,为具身智能和自动化决策系统奠定基础。
以上内容由遇见数据集搜集并总结生成


