Work_UA
收藏资源简介:
WorkUA简历数据集包含84,316份来自Work.ua网站的公开简历条目。每份简历条目包括教育背景、工作经验、技能、语言、残疾状况、退伍军人状态、驾驶执照持有情况以及额外的个人资料元数据等信息。该数据集旨在用于简历解析模型、信息提取系统、职位与候选人匹配算法、针对乌克兰语文档的自然语言处理管道以及数据工程和机器学习训练工作流的研究与开发。
The WorkUA Resume Dataset comprises 84,316 public resume entries sourced from the Work.ua website. Each resume entry includes educational background, work experience, skills, language proficiencies, disability status, veteran status, driving license holding status, and additional profile metadata. This dataset is intended for research and development work covering resume parsing models, information extraction systems, job-candidate matching algorithms, natural language processing pipelines for Ukrainian-language documents, as well as data engineering and machine learning training workflows.
WorkUA Resumes Dataset
数据集概述
该数据集包含84316份从Work.ua公开页面收集的简历条目。每个条目代表从候选人简历中提取的结构化信息,包括教育背景、工作经历、技能、语言能力、残疾状况、退伍军人状况、驾照信息和其他个人资料元数据。
主要用途
- 简历解析模型训练
- 信息提取系统开发
- 职位-候选人匹配算法研究
- 乌克兰语文档的自然语言处理流程
- 数据工程和机器学习训练工作流
数据结构
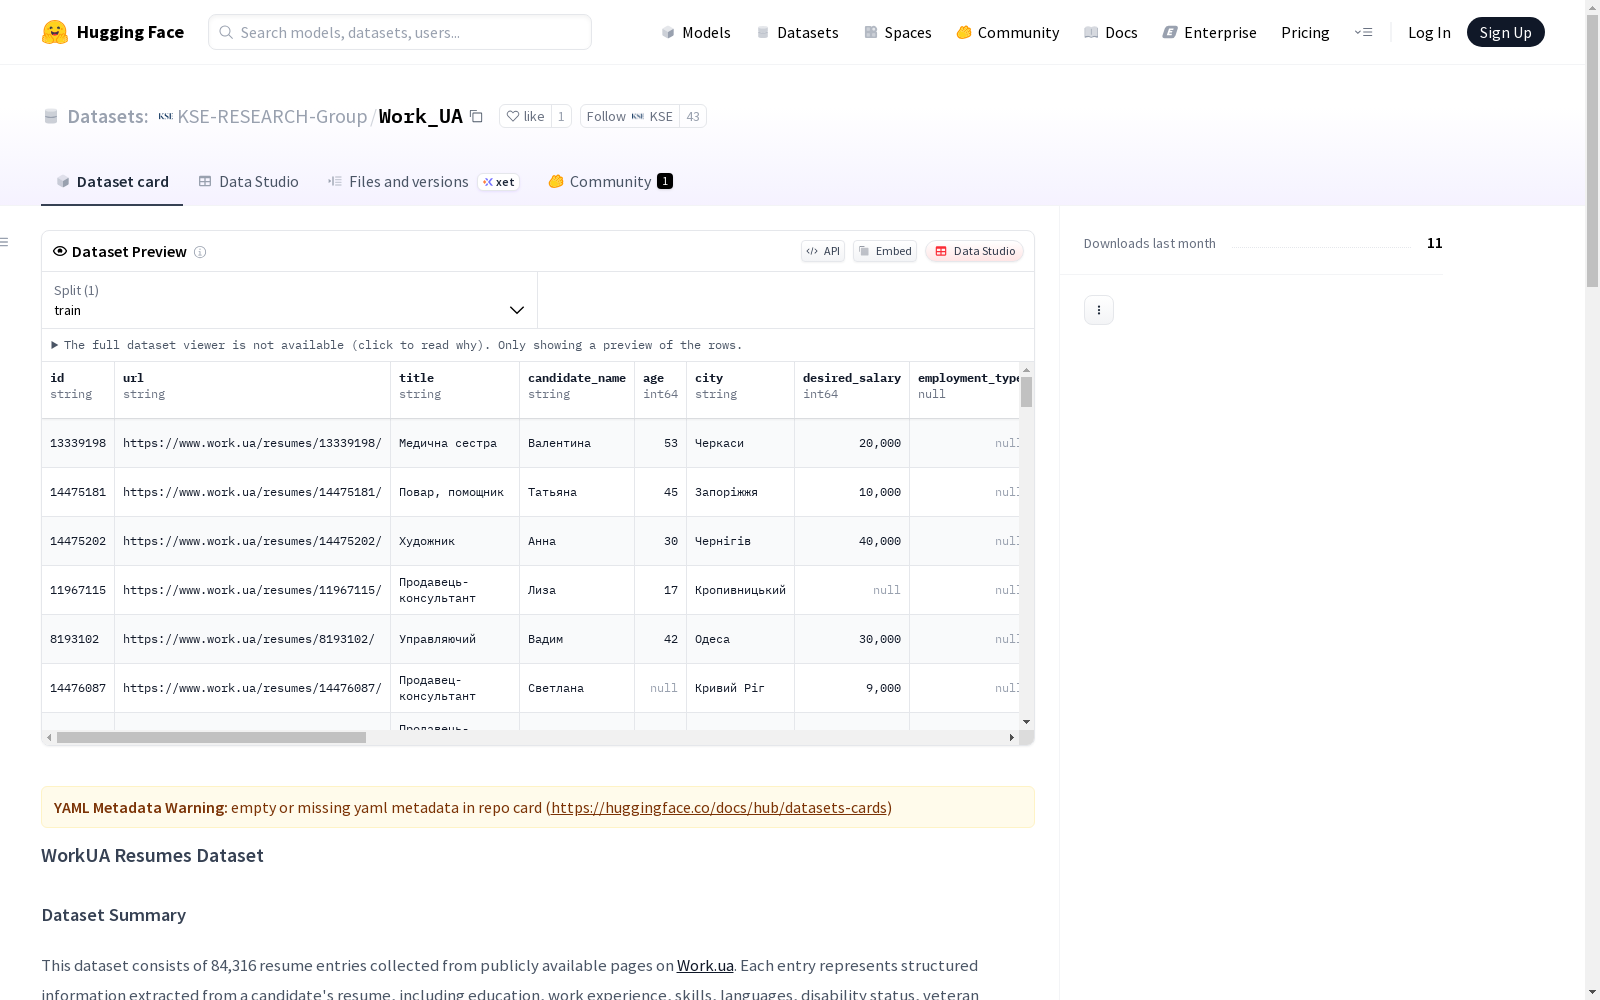
数据集以Polars DataFrame格式提供,包含21个字段。
字段结构
- id: 字符串
- url: 字符串
- title: 字符串
- candidate_name: 字符串
- age: 整型
- city: 字符串
- desired_salary: 整型
- employment_type: 字符串
- work_location_preference: 字符串
- driver_license: 布尔型
- creation_date: 日期时间型
- other_resumes: 结构体列表(包含title、url、resume_id、description字段)
- veteran: 布尔型
- disability: 字符串
- work_experiences: 结构体列表(包含position、start_date、end_date、company、city、industry、responsibilities字段)
- recommendations: 结构体列表(包含name、position字段)
- languages: 结构体列表(包含language、level字段)
- skills: 字符串列表
- educations: 结构体列表(包含institution、faculty、city、level、start_year、end_year字段)
- additional_educations: 结构体列表(包含institution、start_year、end_year字段)
- additional_info: 字符串
预期应用
- 训练简历解析器
- 语义搜索研究
- 文本分类
- 职业推荐系统
- 申请人排名模型
局限性
- 由于原始文档的差异性,某些字段可能不完整
伦理考量
这些简历不包含任何敏感或个人身份信息。