multiturn_chat-mtbench
收藏资源简介:
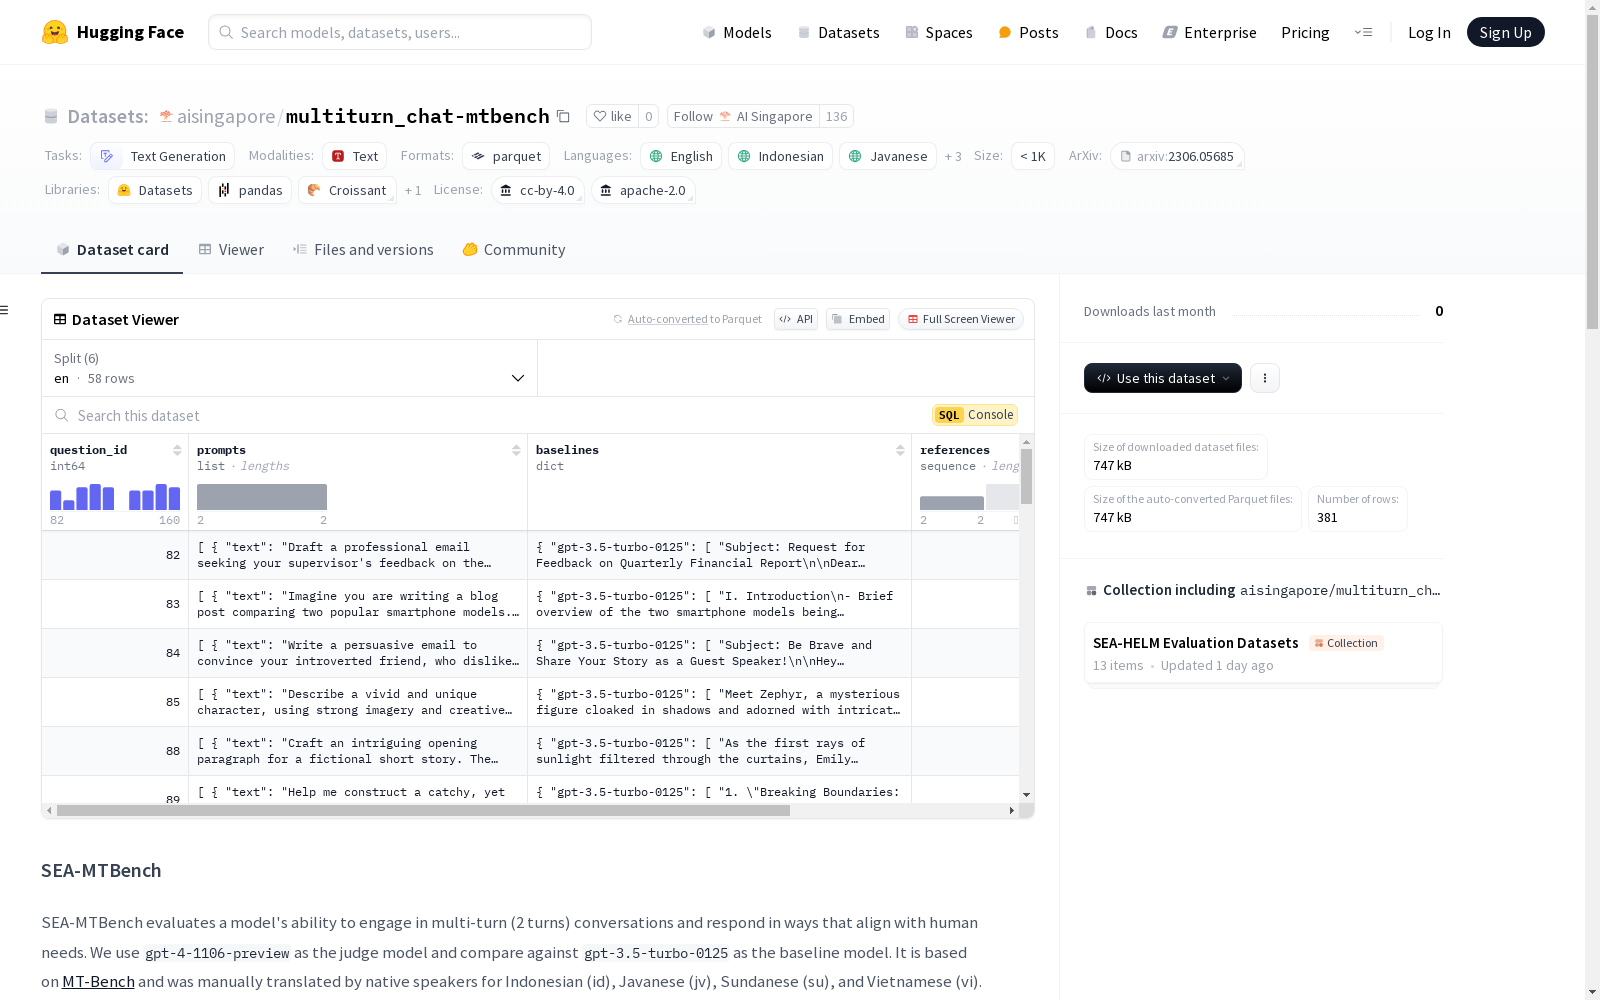
SEA-MTBench 数据集用于评估模型在多轮对话中的表现,特别是模型如何响应以符合人类需求。该数据集基于 MT-Bench,并由母语者手动翻译成印尼语、爪哇语、巽他语和越南语。泰语部分使用了 MT-Bench Thai。数据集包含不同语言的多个拆分,每个拆分都有详细的统计信息,包括示例数量和不同模型的令牌数量。数据集的许可证包括 CC BY 4.0 和 Apache 2.0。
The SEA-MTBench dataset is developed for evaluating model performance in multi-turn conversations, especially how models generate responses that align with human requirements. Built on the MT-Bench dataset, it was manually translated into Indonesian, Javanese, Sundanese, and Vietnamese by native speakers. The Thai subset adopts MT-Bench Thai. The dataset comprises multiple language-specific splits, each accompanied by detailed statistics including the number of examples and token counts across various models. The dataset is licensed under CC BY 4.0 and Apache 2.0.