遇见数据集

Anime_subtitles_CN

收藏
Hugging Face2024-06-30 更新2024-12-12 收录
官方服务:

资源简介:

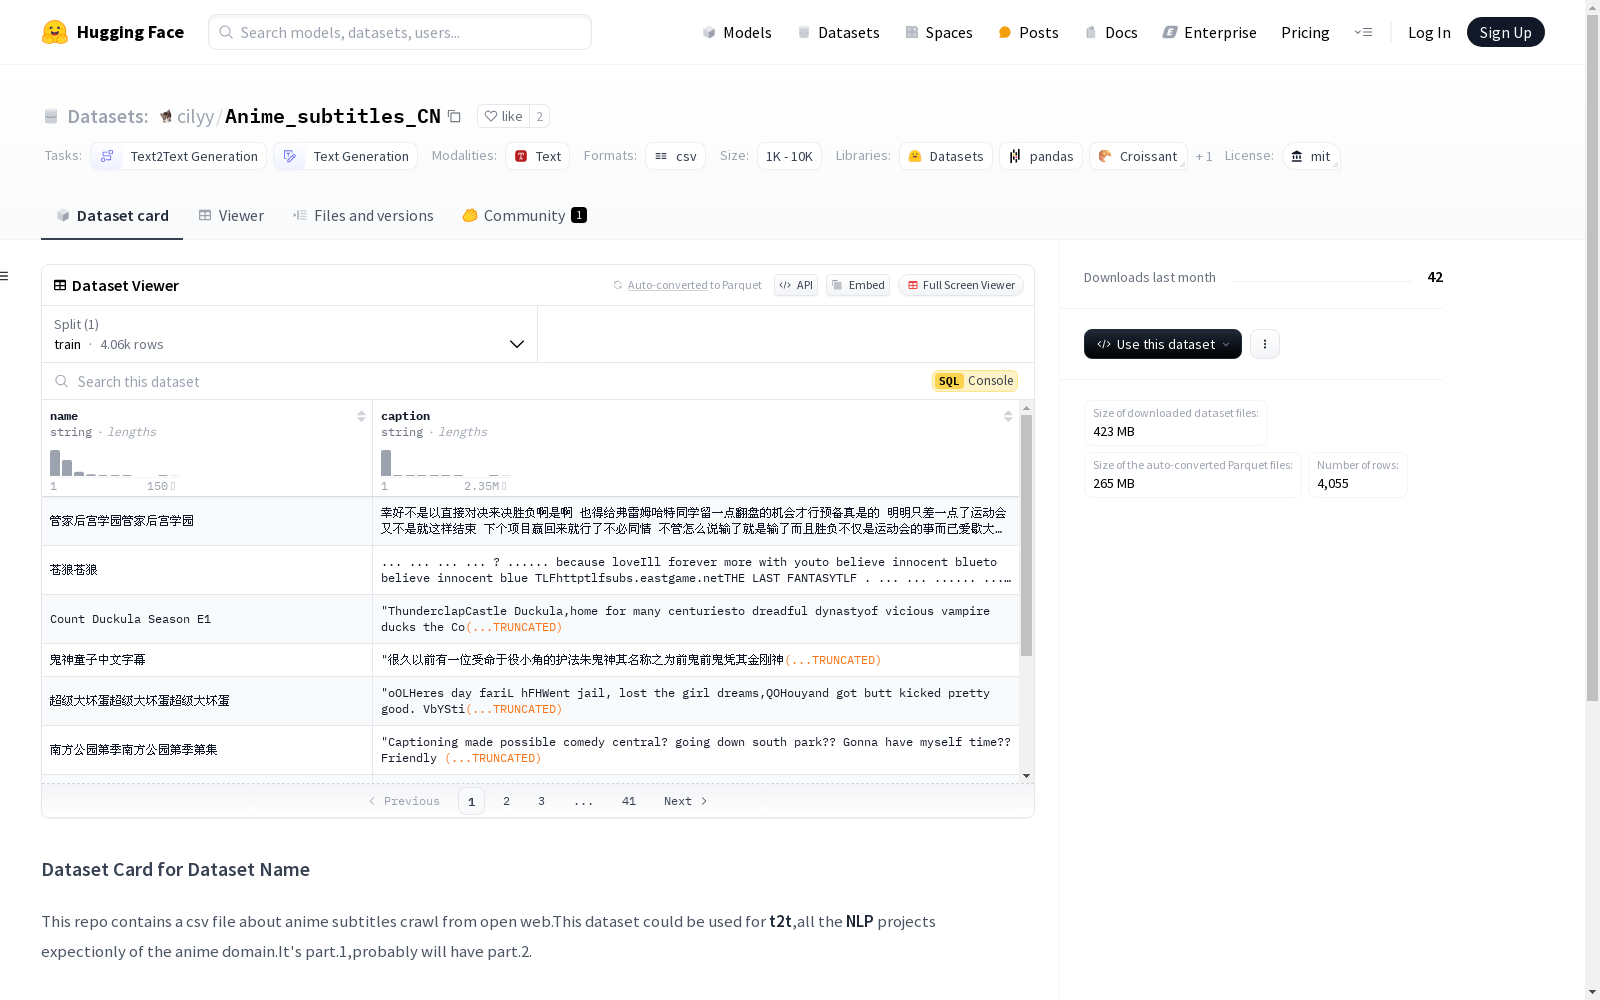
该数据集包含一个关于动漫字幕的CSV文件,名为'anime_subtitles.csv',包含两个特征('name' 和 'caption')和4055行数据,大小约为400MB。每个'name'代表一个季度或电影,'caption'包含角色所说的所有对话,但没有角色名字或其他信息。大多数'name'和'caption'是简体中文。数据集适用于文本到文本生成和文本生成任务,特别是与动漫领域相关的NLP项目。

This dataset includes a CSV file named 'anime_subtitles.csv' focused on anime subtitles. It contains two features ('name' and 'caption'), 4055 rows of data, and has a total size of approximately 400 MB. Each entry in the 'name' field represents a season or a movie, while the 'caption' field contains all dialogue spoken by characters, with no character names or other supplementary information included. Most entries in both the 'name' and 'caption' fields are in Simplified Chinese. This dataset is applicable to text-to-text generation and text generation tasks, particularly NLP projects related to the anime domain.

创建时间:
2024-06-30
原始信息汇总

数据集卡片

数据集描述

  • 文件名: anime_subtitles.csv
  • 大小: 约400MB
  • 行数: 4055行
  • 特征: 包含两个特征(name和caption)
  • 内容描述:
    • name代表一个季度或电影
    • caption包含角色所说的所有对话,但不包括角色名字或其他信息
    • 大部分name和caption是简体中文

用途

  • 适用于文本到文本生成和文本生成任务
  • 特别适用于动漫领域的自然语言处理项目
  • 目前为第一部分,可能会有第二部分
搜集汇总
数据集介绍
Anime_subtitles_CN 数据集图片
构建方式
Anime_subtitles_CN数据集通过从开放网络爬取动漫字幕构建而成,涵盖了多种动漫作品的对白内容。数据集以CSV文件形式存储,包含4055行数据,每行记录了一个动漫季或电影的名称及其对应的对白文本。对白文本经过清洗,去除了角色名称及其他非对白信息,确保了数据的纯净度。
特点
该数据集的特点在于其专注于动漫领域的对白文本,所有数据均为中文简体字幕,适用于文本生成及文本到文本的转换任务。数据集规模适中,约400MB,涵盖了丰富的动漫作品,为自然语言处理项目提供了宝贵的资源。
使用方法
使用Anime_subtitles_CN数据集时,用户可通过克隆仓库直接下载数据文件。数据集适用于文本生成、机器翻译及其他自然语言处理任务,尤其适合动漫领域的文本分析与模型训练。用户可根据需求对数据进行进一步处理,以适配特定的研究或应用场景。
背景与挑战
背景概述
Anime_subtitles_CN数据集是一个专注于动漫领域的文本数据集,创建时间不详,但其内容主要来源于公开网络爬取的动漫字幕。该数据集由两部分组成,目前公开的是第一部分,包含4055行数据,涉及多个动漫季或电影的字幕对话。数据集的核心研究问题在于如何利用这些字幕数据进行文本生成和文本到文本的转换任务,特别是在自然语言处理(NLP)领域中。这一数据集的出现,为动漫领域的语言模型训练和字幕生成技术提供了宝贵资源,对推动相关领域的研究具有重要意义。
当前挑战
Anime_subtitles_CN数据集在应用过程中面临多重挑战。首先,数据集主要解决的是动漫字幕的文本生成问题,这要求模型能够理解并生成符合语境和角色性格的对话,这对模型的上下文理解能力提出了较高要求。其次,数据集的构建过程中,由于字幕来源的多样性和复杂性,如何确保数据的准确性和一致性是一个技术难题。此外,数据集中大部分内容为简体中文,这对非中文母语的研究者来说,可能增加了使用和理解上的难度。这些挑战不仅考验着数据集的实用性,也对后续的研究和应用提出了更高的标准。
常用场景
经典使用场景
Anime_subtitles_CN数据集在自然语言处理领域,尤其是文本生成和文本到文本转换任务中,展现了其独特的价值。该数据集通过提供大量动漫字幕文本,为研究人员和开发者提供了一个丰富的语料库,用于训练和测试各种NLP模型。特别是在动漫领域的文本生成任务中,该数据集能够帮助模型更好地理解和生成符合动漫风格的对话内容。
衍生相关工作
基于Anime_subtitles_CN数据集,许多经典的研究工作得以展开。例如,研究人员利用该数据集开发了专门针对动漫领域的文本生成模型,这些模型在生成符合动漫风格的对话方面表现出色。此外,该数据集还促进了跨语言字幕生成技术的研究,推动了多语言NLP技术的发展。
数据集最近研究
最新研究方向
近年来,随着自然语言处理技术的飞速发展,Anime_subtitles_CN数据集在动漫领域的应用逐渐成为研究热点。该数据集包含了大量中文动漫字幕,为文本生成和文本到文本的转换任务提供了丰富的语料资源。研究者们利用这一数据集,探索了动漫对话生成、情感分析以及跨语言翻译等前沿方向。特别是在动漫对话生成领域,该数据集的应用显著提升了生成文本的自然度和连贯性,为动漫产业的内容创作和自动化翻译提供了有力支持。此外,随着多模态学习技术的兴起,Anime_subtitles_CN数据集也被用于结合视觉和文本信息,推动动漫内容的多模态理解和生成研究。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务