遇见数据集

SADA22-MSA

收藏
Hugging Face2025-05-12 更新2025-05-13 收录
官方服务:

资源简介:

SADA数据集(沙特阿拉伯语音数据集)是一个大规模的阿拉伯语音语料库,旨在支持开发高质量的人工智能模型进行阿拉伯语音处理。它包含超过667小时的转录阿拉伯音频记录,主要包括各种沙特方言,是由沙特数据和人工智能中心与沙特广播局合作策划的。

SADA dataset (Saudi Arabian Speech Dataset) is a large-scale Arabic speech corpus designed to support the development of high-quality artificial intelligence models for Arabic speech processing. It contains over 667 hours of transcribed Arabic audio recordings, primarily covering various Saudi dialects, and was curated by the Saudi Data and Artificial Intelligence Authority in collaboration with the Saudi Broadcasting Authority.

创建时间:
2025-05-09
原始信息汇总

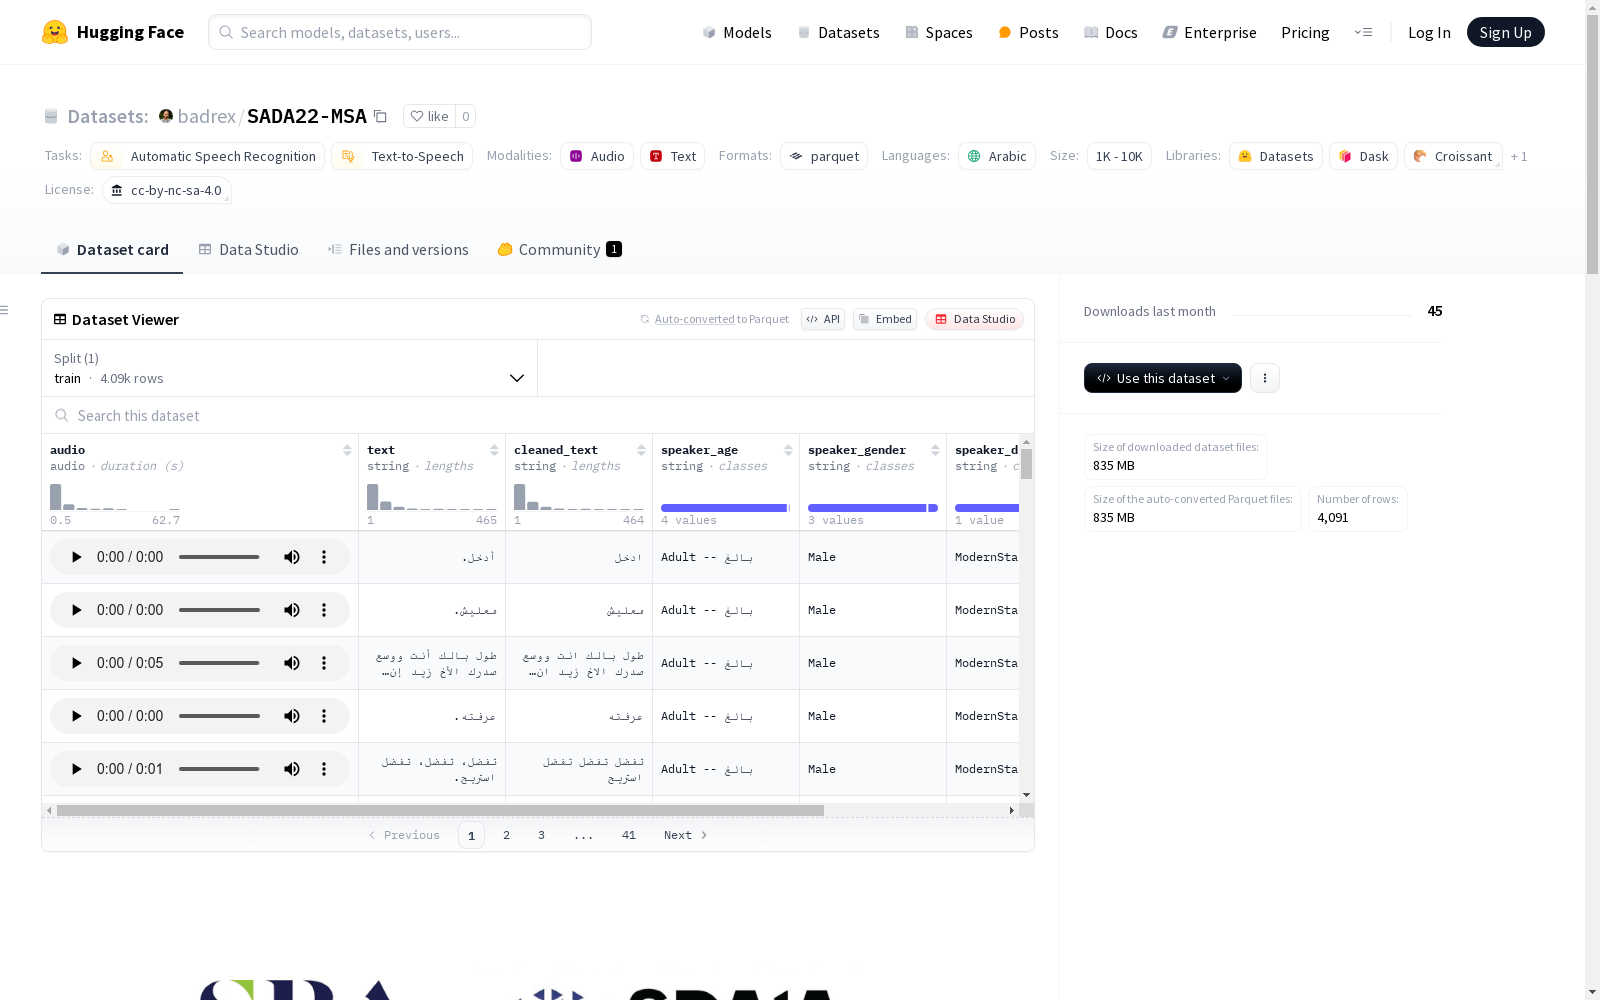
数据集卡片:SADA (Saudi Audio Dataset for Arabic) MSA部分

数据集概述

  • 名称:SADA (Saudi Audio Dataset for Arabic) MSA部分
  • 描述:大规模阿拉伯语语音语料库,支持阿拉伯语语音处理的高质量AI模型开发
  • 数据量:667小时以上转录阿拉伯语音频
  • 主要内容:沙特方言为主的阿拉伯语内容
  • 来源:57个以上电视节目提取的多样化口语内容
  • 合作机构:SDAIA国家人工智能中心与沙特广播管理局

关键特性

  • 音频格式:原始音频(.wav等支持格式)
  • 文本信息:
    • text:原始转录文本
    • cleaned_text:规范化版本转录文本
  • 说话者元数据:
    • speaker_age:年龄组(成人/老年人/未知)
    • speaker_gender:性别(男/女/未知)
    • speaker_dialect:方言分类(纳吉迪/希贾兹/哈利吉/未知)

数据集结构

  • 特征字段:
    • audio (音频)
    • text (字符串)
    • cleaned_text (字符串)
    • speaker_age (字符串)
    • speaker_gender (字符串)
    • speaker_dialect (字符串)
    • length (浮点数)
  • 数据拆分:
    • 训练集:4091个样本,836MB

支持任务

  • 自动语音识别(ASR)
  • 文本转语音(TTS)
  • 说话人日志
  • 方言识别
  • 性别和年龄分类

语言信息

  • 主要语言:阿拉伯语(ar)
  • 方言类型:沙特各地区方言(纳吉迪/希贾兹/哈利吉)

许可信息

  • 许可证类型:CC BY-NC-SA 4.0
  • 许可链接:https://creativecommons.org/licenses/by-nc-sa/4.0/

获取注意

⚠️ 当前仅为现代标准阿拉伯语(MSA)部分,完整数据集见:https://www.kaggle.com/datasets/sdaiancai/sada2022

引用格式

bibtex @misc{SADA2022, title={SADA: Saudi Audio Dataset for Arabic}, author={SDAIA and Saudi Broadcasting Authority}, year={2022}, howpublished={url{https://www.kaggle.com/datasets/sdaiancai/sada2022}}, note={CC BY-NC-SA 4.0} }
搜集汇总
数据集介绍
SADA22-MSA 数据集图片
构建方式
SADA22-MSA数据集作为阿拉伯语语音处理领域的重要资源,其构建过程体现了严谨的学术规范。该数据集由沙特数据与人工智能局(SDAIA)与沙特广播管理局(SBA)联合开发,源数据精选自57档电视节目的公开内容,通过专业团队进行人工转写和标注。音频素材经过严格的质量控制流程,包括降噪处理、语音分段和文本归一化,最终形成包含原始音频、转写文本及丰富元数据的结构化语料库。
特点
该数据集最显著的特点是专注于现代标准阿拉伯语(MSA)的语音样本,包含4091条高质量音频-文本对,总时长约647小时。每条数据均标注说话人年龄、性别等人口统计特征,以及经过标准化的文本转写内容。其音频采样规格统一,文本经过专业语言学处理,特别适合阿拉伯语语音识别、语音合成等任务的模型训练。作为目前公开的最大规模沙特阿拉伯语数据集之一,其方言纯度和数据完整性在学术界具有独特价值。
使用方法
研究人员可通过HuggingFace平台直接加载该数据集,其标准化的音频格式与文本标注支持端到端的语音处理流程。典型应用场景包括:使用audio字段进行声学模型训练,通过cleaned_text字段优化语言模型,或利用speaker_*元数据开发说话人分类系统。需要注意的是,本版本仅包含现代标准阿拉伯语子集,完整数据集需通过Kaggle平台获取。使用时应遵守CC-BY-NC-SA 4.0许可协议,并按规定引用原始论文。
背景与挑战
背景概述
SADA22-MSA数据集是沙特阿拉伯国家人工智能中心(SDAIA)与沙特广播管理局(SBA)于2022年联合构建的大规模阿拉伯语语音语料库,专注于现代标准阿拉伯语(MSA)变体。作为SADA语料库的子集,该数据集旨在填补阿拉伯语语音资源稀缺的空白,尤其针对包含丰富方言特征的沙特阿拉伯地区语音数据。数据集包含来自57档电视节目的667小时高质量音频及文本转录,标注了说话人年龄、性别和方言等元数据,为语音识别、文本转语音等多模态任务提供了重要基础资源。其构建不仅推动了阿拉伯语自然语言处理技术的发展,更为保护语言多样性提供了学术价值。
当前挑战
阿拉伯语语音处理面临方言变体复杂、音系规则差异显著等核心挑战,SADA22-MSA需解决现代标准阿拉伯语与地域方言的语音表征差异问题。数据构建过程中,电视节目原始音频存在背景噪声、多人对话重叠等干扰因素,需通过专业人工标注实现精准分段与文本归一化。此外,说话人元数据标注需平衡隐私保护与学术需求,方言分类体系的设计也需兼顾语言学规范与计算实用性。这些挑战使得该数据集在语音对齐精度、方言分类颗粒度等方面仍需持续优化。
常用场景
经典使用场景
在阿拉伯语语音处理领域,SADA22-MSA数据集因其丰富的现代标准阿拉伯语(MSA)语音样本而成为研究者的重要资源。该数据集广泛用于训练和评估自动语音识别(ASR)系统,特别是在处理阿拉伯语多方言变体时表现出色。其多样化的语音内容和详尽的元数据标注,为语音合成(TTS)和方言识别任务提供了坚实的基础。
衍生相关工作
基于SADA22-MSA数据集,研究者们已经开发出多种先进的阿拉伯语语音处理模型。例如,一些工作专注于利用该数据集进行多方言语音识别,另一些则探索其在说话人年龄和性别分类中的应用。这些衍生研究不仅丰富了阿拉伯语语音技术的学术成果,也为实际应用提供了更多可能性。
数据集最近研究
最新研究方向
在阿拉伯语语音处理领域,SADA22-MSA数据集因其丰富的方言多样性和详尽的元数据标注,正成为推动阿拉伯语自动语音识别(ASR)和文本转语音(TTS)技术发展的关键资源。近年来,研究者们利用该数据集探索了多方言混合建模、低资源方言自适应等前沿方向,特别是在沙特方言的语音识别性能优化方面取得了显著进展。与此同时,该数据集也被广泛应用于说话人日志、性别与年龄分类等辅助任务,为阿拉伯语语音技术的全面升级提供了重要支撑。随着中东地区人工智能应用的快速增长,SADA22-MSA数据集在促进阿拉伯语自然语言处理技术本地化、保护语言多样性方面的社会价值日益凸显。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务