
genbio-ai/transcript_isoform_expression_prediction
收藏官方服务:
资源简介:
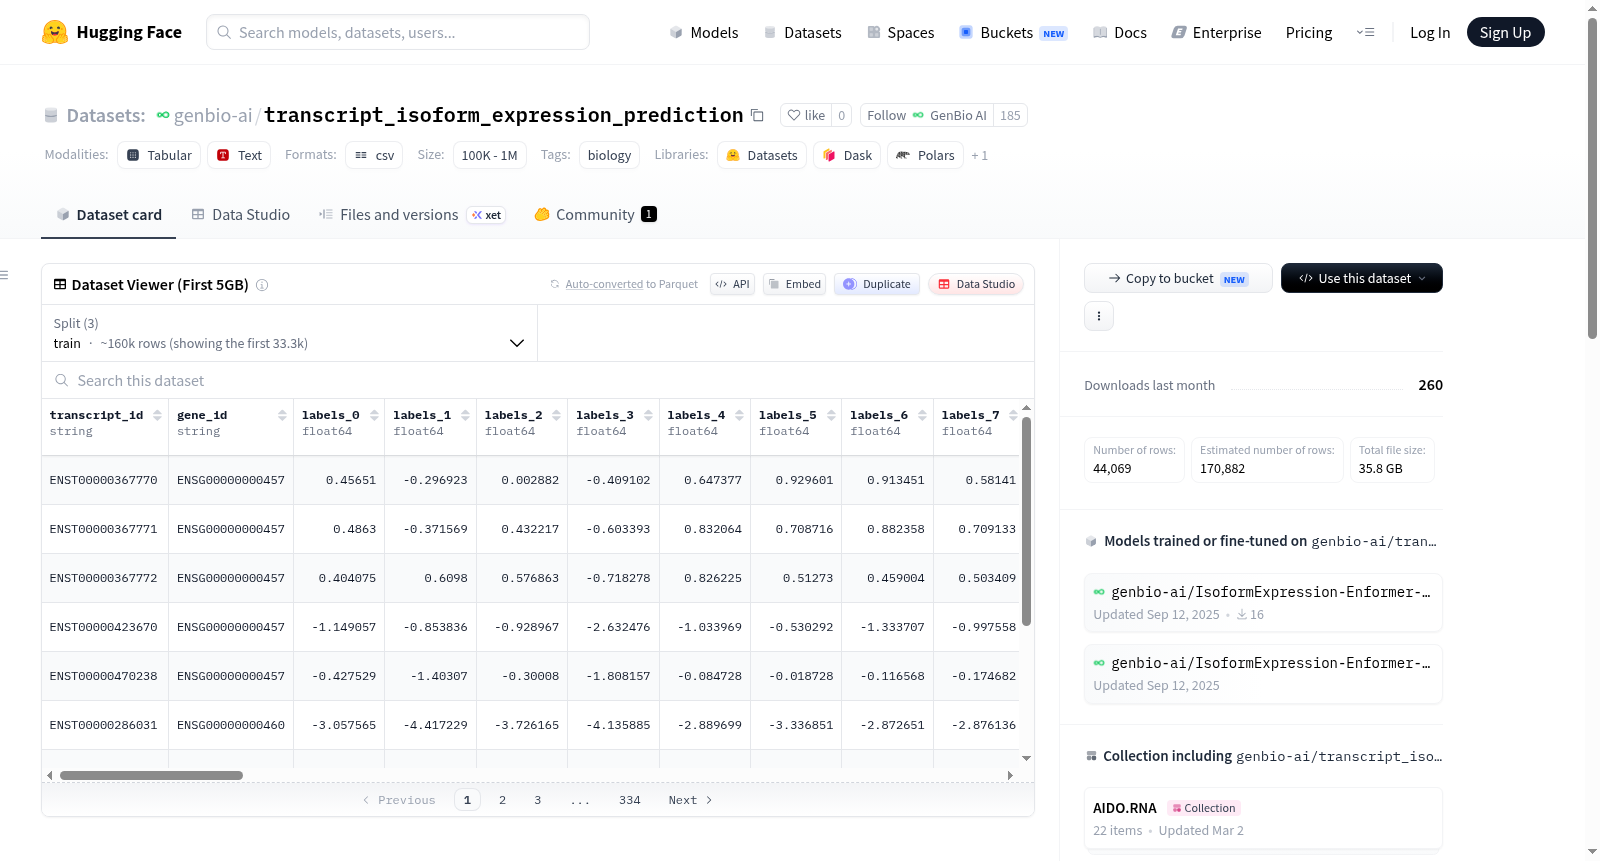
这是一个根据IsoFormer论文预处理流程整理的转录本异构体表达数据集,包含19个染色体的训练集、第20染色体的验证集以及第21和22染色体的测试集。每个数据集文件包含转录本ID、基因ID、30个不同组织的转录本异构体表达水平以及相关的基因位置和序列信息。
This is a transcript isoform expression dataset curated following the preprocessing pipeline in the IsoFormer paper, including training sets for 19 chromosomes, a validation set for chromosome 20, and a test set for chromosomes 21 and 22. Each dataset file contains transcript ID, gene ID, transcript isoform expression levels in 30 different tissues, as well as related gene location and sequence information.
提供机构:
genbio-ai搜集汇总
数据集介绍
构建方式
该数据集整合自GTEx门户,基于Garau-Luis等人(2024)的预处理流程构建。研究团队从GTEx分析V8的批量组织表达数据中获取RNA-seq转录本TPM文件,该文件涵盖近1000名人类个体、30种非病变组织的转录本表达数据。为获得群体水平的组织特异性表达信息,对个体间的表达测量值进行平均处理。针对每个转录本,利用其Ensembl转录本ID,以人类参考基因组GRCh38为模板,检索以转录起始位点为中心、总长度为197k的DNA序列,并同步获取编码蛋白质的氨基酸序列。最终,每个样本包含DNA序列、RNA序列、潜在蛋白质序列及在30种组织中的表达水平。数据集按染色体划分:1-19号染色体用于训练(17.5万样本),20号染色体用于验证(4000样本),21-22号染色体用于测试(6500样本),并对标签执行log₂(0.0001+x)变换。
特点
本数据集呈现多模态生物学特性,融合了DNA、RNA及蛋白质三种序列信息与高维组织特异性表达谱,为计算生物学提供了丰富的特征空间。其标签维度高达30,对应于30种不同组织的转录本异构体表达量,反映了人体组织间的转录复杂性。数据集严格按染色体划分训练、验证与测试集,有效避免了基因泄漏风险,保障了模型泛化能力的可靠评估。此外,数据集特设编码起始位点、编码终止位点及剪接位点等精细注释列,加深了对转录本结构变异的理解。更新日志亦指出,针对负链基因的坐标注释已进行修正,体现了数据集的严谨性与可维护性。
使用方法
用户可直接通过HuggingFace平台加载该数据集,利用Python的datasets库轻松划分并访问各模块。每份样本包含转录本ID、基因ID、30维表达标签、染色体坐标、链方向及DNA/RNA/蛋白质序列。模型研究中,建议以DNA序列预测30维组织特异表达向量为主要任务,可结合Transformer架构进行序列建模;RNA与蛋白质序列可作为辅助模态,用于多模态融合或对比学习。标签经log变换处理,预测时需注意反归一化操作。同时,数据集提供的剪接位点与编码区坐标可用于增强模型对可变剪接事件的识别能力,适用于基因表达调控机制探索等下游任务。
背景与挑战
背景概述
转录本异构体表达预测是精准医学与功能基因组学中的关键问题,其旨在通过序列信息推断组织特异的基因表达模式。该数据集由研究人员基于GTEx v8数据构建,整合了来自近1000名个体、30种非疾病组织的RNA-seq转录本表达量,并依据Garau-Luis等人(2024)的预处理流程进行标准化处理。通过将染色体的1-19号作为训练集、20号作为验证集、21-22号作为测试集,数据集包含了175k、4k和6.5k个样本。每个样本均提供长度197k的DNA序列、RNA序列、蛋白序列(若编码蛋白)及30种组织的表达水平,为多模态序列与表达量关系的建模提供了宝贵资源,推动了转录本调控机制的计算研究。
当前挑战
该数据集面临的挑战主要体现在两方面。领域问题层面,转录本异构体表达预测需解决从长程DNA序列中捕获调控元件与剪接模式,以及整合RNA和蛋白序列的跨模态信息,以应对组织特异性表达的高度异质性。构建过程中,困难包括从原始GTEx数据中准确提取并校正转录本坐标(如负链基因的TSS与TES反向错误)、处理超过19.7万碱基的超长序列导致的计算资源瓶颈,以及跨染色体划分时确保训练与测试集基因的独立性,避免基因泄漏影响模型泛化能力。
常用场景
经典使用场景
该数据集聚焦于人类转录本亚型表达预测这一前沿课题,整合了来自GTEx项目近1000个个体的30种非疾病组织的转录本表达数据。研究者可利用该数据集,基于转录本起始位点两侧197kb的DNA序列、RNA序列及蛋白质序列等多元模态信息,预测不同组织中特定转录本的表达水平。这一经典任务不仅验证了序列信息与组织特异性表达之间的内在关联,还为探索基因调控的分子机制提供了重要数据基础。
解决学术问题
该数据集有效解决了转录本亚型表达预测中数据稀缺与模态单一的核心难题。通过提供大规模、跨组织、多模态的序列与表达数据,它推动了基因组学与深度学习交叉领域的研究进展,特别是支持了基于序列模型的组织特异性表达推断方法的开发。其意义在于,为解析转录本调控的复杂性提供了标准化基准,促进了非编码区域与转录本表达关系的量化分析,对理解基因表达调控网络具有深远学术影响。
衍生相关工作
该数据集衍生了一系列具有影响力的研究工作,其中经典的Garau-Luis等人基于此数据构建的多模态深度学习模型,首次系统性地将长程DNA序列、RNA序列及蛋白质序列整合用于转录本表达预测。此外,数据集促进了基于Transformer架构的基因组语言模型的发展,推动了跨染色体泛化能力的评估,并启发了后续关于序列模态融合策略与组织特异性表达可解释性分析的研究方向。
以上内容由遇见数据集搜集并总结生成


