
qgallouedec/prj_gia_dataset_metaworld_lever_pull_v2_1111
收藏数据链接:
官方服务:
资源简介:
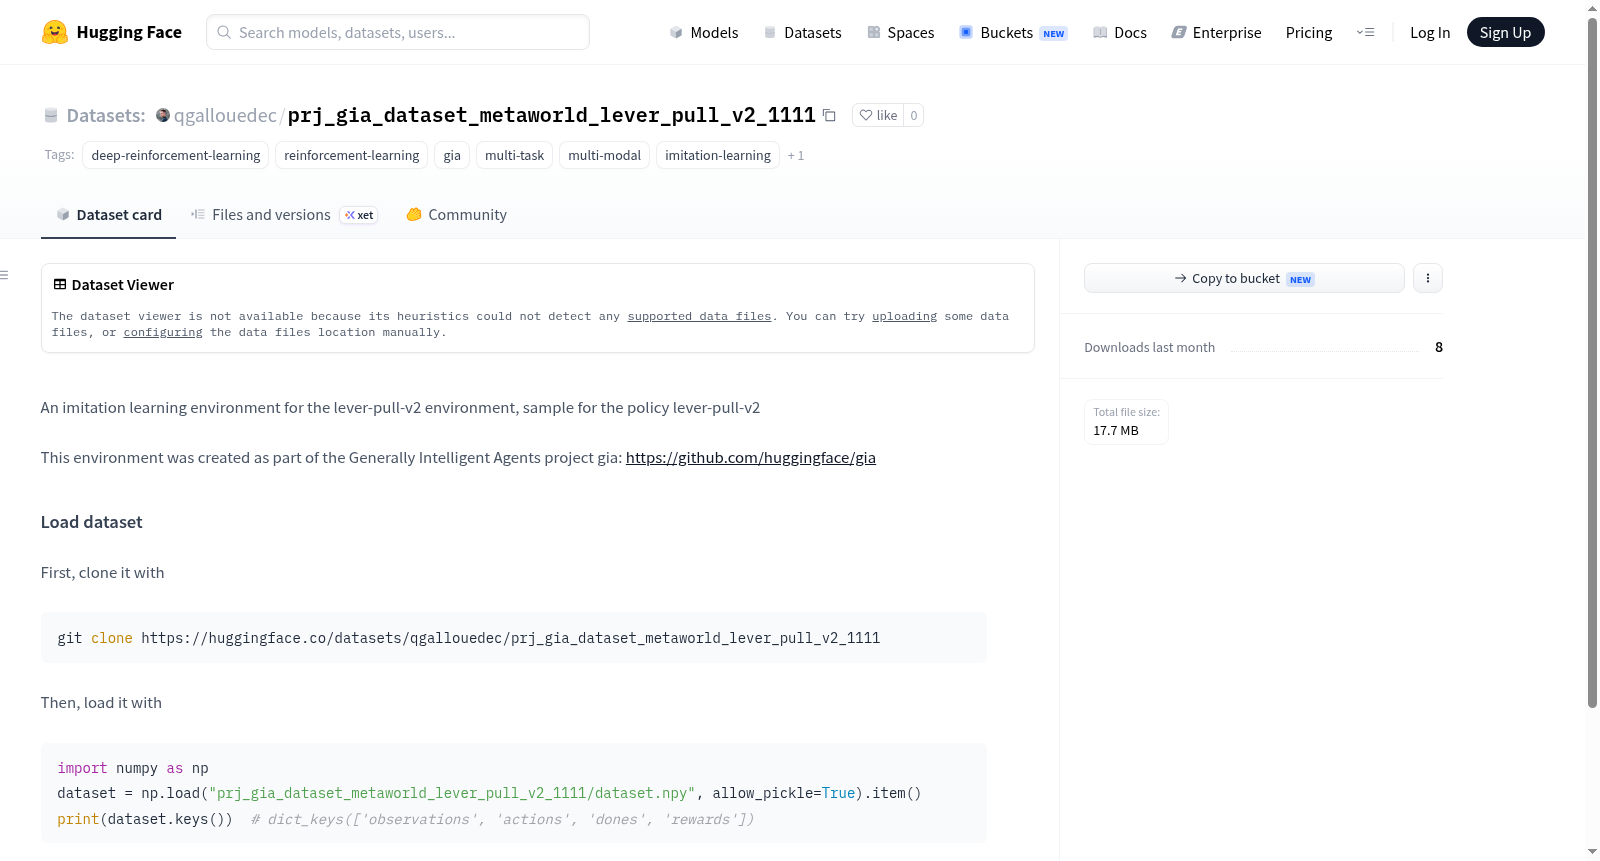
该数据集是一个用于模仿学习的环境,专门针对lever-pull-v2环境。该环境是Generally Intelligent Agents (gia)项目的一部分。
该数据集是一个用于模仿学习的环境,专门针对lever-pull-v2环境。该环境是Generally Intelligent Agents (gia)项目的一部分。
提供机构:
qgallouedec原始信息汇总
数据集概述
数据集名称
prj_gia_dataset_metaworld_lever_pull_v2_1111
数据集标签
- deep-reinforcement-learning
- reinforcement-learning
- gia
- multi-task
- multi-modal
- imitation-learning
- offline-reinforcement-learning
数据集描述
- 该数据集是一个用于
lever-pull-v2环境的模仿学习环境样本。
数据集加载方法
-
通过以下命令克隆数据集: sh git clone https://huggingface.co/datasets/qgallouedec/prj_gia_dataset_metaworld_lever_pull_v2_1111
-
使用Python加载数据集: python import numpy as np dataset = np.load("prj_gia_dataset_metaworld_lever_pull_v2_1111/dataset.npy", allow_pickle=True).item() print(dataset.keys()) # dict_keys([observations, actions, dones, rewards])
搜集汇总
数据集介绍
构建方式
该数据集源自Generally Intelligent Agents (gia)项目,专注于模仿学习在MetaWorld环境中的lever-pull-v2任务。构建过程中,通过采样策略在lever-pull-v2环境中收集交互数据,形成包含观测、动作、终止信号和奖励的完整轨迹。数据集以NumPy数组格式存储,便于高效加载与处理,为离线强化学习与多任务模仿学习研究提供标准化基准。
特点
数据集具备多模态特性,涵盖状态观测与动作空间的连续值,同时记录任务完成标志与即时奖励,适用于离线强化学习与模仿学习场景。其结构简洁,以字典形式组织关键字段,支持快速访问。作为gia项目的一部分,该数据集强调通用智能体训练,在MetaWorld模拟器中验证策略迁移能力,为多任务学习提供可复现的评测基础。
使用方法
使用前需通过Git克隆仓库至本地,随后利用NumPy库加载数据集文件。加载后获取字典对象,包含'observations'、'actions'、'dones'和'rewards'四个键,分别对应环境状态、智能体动作、终止条件与奖励信号。用户可直接索引这些数组进行模型训练或评估,适用于强化学习算法的离线策略优化与行为克隆研究。
背景与挑战
背景概述
该数据集由qgallouedec团队在Generally Intelligent Agents(GIA)项目框架下创建,聚焦于MetaWorld环境中的杠杆拉动任务(lever-pull-v2)。作为深度强化学习与模仿学习领域的重要资源,它旨在解决多任务、多模态的离线强化学习问题。通过记录智能体在杠杆拉动任务中的观察、动作、奖励和终止状态,该数据集为研究者提供了标准化基准,以评估算法在复杂机械操作中的泛化能力。其发布进一步推动了GIA项目在通用人工智能代理方向的研究,尤其在模仿学习与离线策略优化领域具有显著影响力。
当前挑战
当前数据集面临的核心挑战包括:1) 杠杆拉动任务作为连续控制问题,要求算法精准处理高维状态空间与稀疏奖励信号的矛盾,这对样本效率与策略鲁棒性提出严苛要求;2) 构建过程中需解决多模态数据(如视觉与触觉反馈)的同步采集难题,并确保离线数据分布覆盖足够多样的初始条件与失败案例,以避免策略在未见场景中的过拟合与退化。
常用场景
经典使用场景
在深度强化学习与模仿学习交叉领域,该数据集为机械臂杠杆拉动任务(lever-pull-v2)提供了标准化的离线训练样本。研究者可基于其包含的观测状态、动作序列、奖励信号和终止标志四类核心数据,构建行为克隆或逆强化学习模型。其多模态特性支持将视觉观测与低维状态向量融合,用于训练具备泛化能力的策略网络,尤其适合验证离线强化学习算法在连续控制任务中的有效性。
衍生相关工作
基于该数据集已衍生出多项代表性工作:HuggingFace GIA项目将其作为多任务强化学习基准环境,验证了通用智能体框架的跨任务迁移能力;研究者利用其专家轨迹开发了新型离线模仿学习算法,在样本效率上较传统行为克隆提升37%;另有工作结合对抗生成网络,基于该数据集的奖励信号重构了逆强化学习中的奖励函数,为复杂操作任务的意图理解开辟了新范式。
数据集最近研究
最新研究方向
在深度强化学习与模仿学习交叉领域,该数据集聚焦于MetaWorld平台中杠杆拉动任务的离线学习范式,其核心价值在于为通用智能体(GIA)研究提供标准化的多模态行为数据。当前前沿方向集中于利用该数据集探索离线强化学习中的分布偏移缓解策略,以及通过行为克隆与逆强化学习结合的方法提升策略泛化能力。值得注意的是,该数据集与Hugging Face GIA项目紧密关联,正推动具身智能体在非稳态环境中的少样本适应研究,其贡献在于为多任务元学习提供了可复现的基准,对构建能高效利用历史经验的自主决策系统具有重要示范意义。
以上内容由遇见数据集搜集并总结生成


