遇见数据集

NCube/europa

收藏
Hugging Face2024-08-23 更新2024-06-12 收录
官方服务:

资源简介:

EUROPA数据集是一个专门用于训练和评估多语言关键词生成模型的法律领域数据集。该数据集包含来自欧盟法院的法律判决,涵盖了所有24种欧盟官方语言。数据集的结构包括celex_id、lang、input_text和keyphrases等特征,并且按照时间顺序分为训练集、验证集和测试集。数据集的创建者是由N3团队,并且使用了MIT许可证。

EUROPA数据集是一个专门用于训练和评估多语言关键词生成模型的法律领域数据集。该数据集包含来自欧盟法院的法律判决,涵盖了所有24种欧盟官方语言。数据集的结构包括celex_id、lang、input_text和keyphrases等特征,并且按照时间顺序分为训练集、验证集和测试集。数据集的创建者是由N3团队,并且使用了MIT许可证。

提供机构:
NCube
原始信息汇总

数据集卡片 - EUROPA

数据集详情

数据集描述

EUROPA 是一个专为训练和评估多语言法律领域关键词生成模型设计的数据集。它包含来自欧盟法院(EU)的法律判决,涵盖所有24种官方欧盟语言。

关键特点:

  • 多语言:涵盖24种官方欧盟语言。

  • 领域特定:专注于法律文档。

  • 来源:源自欧盟法院的判决。

  • 策划团队:N3团队

  • 语言:法语、德语、英语、意大利语、荷兰语、希腊语、丹麦语、葡萄牙语、西班牙语、瑞典语、芬兰语、立陶宛语、爱沙尼亚语、捷克语、匈牙利语、拉脱维亚语、斯洛文尼亚语、波兰语、马耳他语、斯洛伐克语、罗马尼亚语、保加利亚语、克罗地亚语、爱尔兰语

  • 许可:MIT许可证

数据集结构

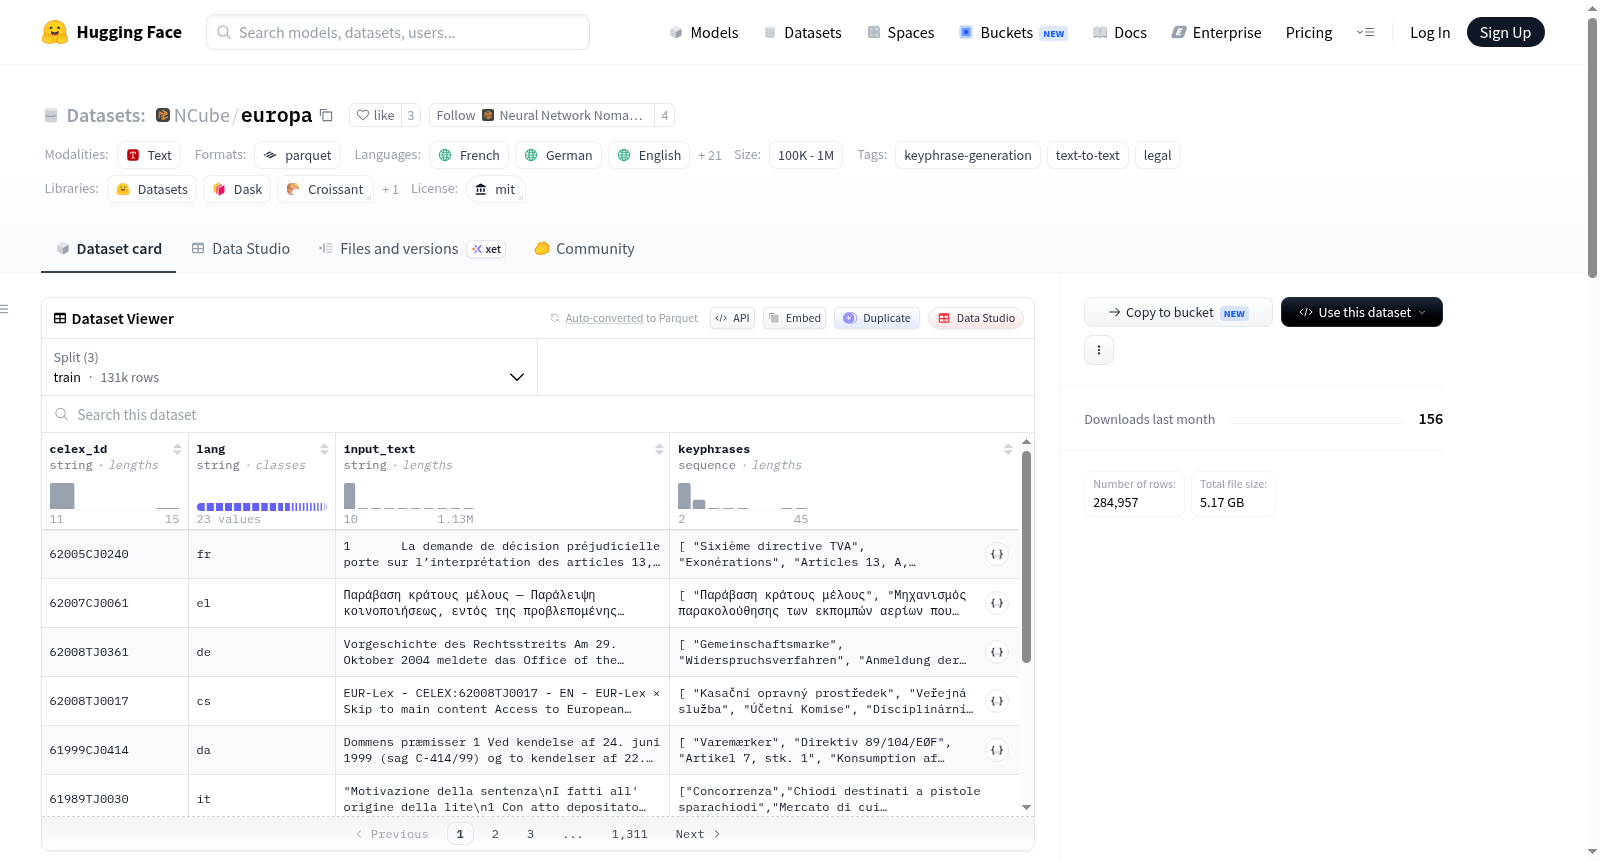
  • celex_id:继承自欧盟法院的CELEX标识符。同一判决的不同翻译版本共享相同的celex_id。如果您希望为每个实例设置唯一标识符,可以将lang和celex_id值连接起来;
  • lang:ISO 639-1语言代码;
  • input:判决的转录或翻译;
  • keyphrases:欧盟法院起草的参考关键词。

如我们的论文所述,数据集按时间顺序划分,以评估模型的时序泛化能力:

  • 训练集:1957年至2010年(131,076个实例);
  • 验证集:2011年至2015年(63,373个实例);
  • 测试集:2016年至2023年(90,508个实例)。

引用

@article{salaun2024europa, title={EUROPA: A Legal Multilingual Keyphrase Generation Dataset}, author={Sala{"u}n, Olivier and Piedboeuf, Fr{e}d{e}ric and Le Berre, Guillaume and Hermelo, David Alfonso and Langlais, Philippe}, journal={arXiv preprint arXiv:2403.00252}, year={2024} }
搜集汇总
数据集介绍
NCube/europa 数据集图片
构建方式
在法律文本处理与自然语言生成领域,高质量的多语言关键短语生成数据集尚属稀缺资源。为填补这一空白,研究者从欧盟法院(Court of Justice of the European Union)的判决文书中提取语料,构建了名为EUROPA的数据集。该数据集覆盖欧盟全部24种官方语言,每条样本包含CELEX标识符、语言代码、判决文本原文以及由法院官方起草的参考关键短语。数据划分遵循时间顺序原则,训练集涵盖1957年至2010年的13万余条实例,验证集与测试集分别对应2011至2015年及2016至2023年的判决,旨在评估模型在时间泛化条件下的表现。
特点
EUROPA数据集具有鲜明的多语言与法律领域双重属性。其收录的语料横跨法语、德语、英语、意大利语等24种语言,为跨语言关键短语生成研究提供了独特的基准资源。所有文本均源自欧盟法院的真实判决,具备高度的专业性与规范性,参考关键短语由法院官方撰写,确保了标注质量的权威性。此外,数据集按时间顺序划分训练、验证与测试子集,使得研究者能够系统性地考察模型面对法律术语演变与判决风格变化时的鲁棒性。
使用方法
该数据集适用于训练与评估多语言关键短语生成模型,尤其聚焦于法律文本领域。使用者可直接加载预划分的训练、验证与测试子集,利用input_text字段作为模型输入,以keyphrases字段作为生成目标。研究者可依据语言代码筛选特定语言的子集进行单语实验,或利用全部24种语言开展跨语言迁移学习。数据集采用MIT开源协议发布,便于学术研究与商业应用中的灵活使用,并建议在引用时参考其ACL 2024论文以获取更详尽的实验设置与基线结果。
背景与挑战
背景概述
在自然语言处理领域,关键短语生成任务长期聚焦于学术文献与英语语料,法律文本的多语言关键短语生成研究尚属蓝海。由N3团队于2024年构建的EUROPA数据集应运而生,该团队整合了欧盟法院自1957年至2023年间跨越24种官方语言的司法判决,共计约28.5万个实例,旨在突破语言与领域的双重壁垒。数据集按时间划分为训练集、验证集与测试集,以评估模型在时间泛化上的表现,其研究核心在于探索多语言法律文本中关键短语的自动提取与生成。EUROPA的发布为法律人工智能提供了标准化基准,推动了跨语言法律信息检索与知识组织的发展,相关论文发表于ACL 2024,彰显其对计算语言学与法律科技的交叉影响力。
当前挑战
EUROPA面临的挑战首先体现在领域问题的复杂性:法律文本中关键短语的语义边界模糊且依赖上下文,不同欧盟语言间的语法结构与法律术语差异显著,使得多语言关键短语生成模型的鲁棒性难以保证。构建过程中,数据源涉及24种语言的长篇判决,需处理翻译一致性、CELEX标识符对齐以及时间跨度下的法律术语演变等难题;此外,训练集与测试集的时间划分虽利于泛化评估,但早期判决的数字化质量参差不齐,可能引入噪声。这些挑战共同指向如何在海量异构法律语料中实现精准的关键短语抽取,同时保持跨语言与跨时间的稳定性。
常用场景
经典使用场景
在自然语言处理与法律智能的交叉领域中,EUROPA数据集被广泛用于训练和评估多语言法律文本的关键短语生成模型。该数据集汇集了来自欧盟法院的判决书,覆盖全部24种欧盟官方语言,为跨语言法律信息抽取提供了稀缺的高质量标注资源。研究者通常将其作为基准,测试模型在面对法律文本中高度结构化、术语密集且语义严谨的语料时,能否准确提取出具有法律效力的关键短语,进而推动法律文本摘要与知识图谱构建等任务的发展。
解决学术问题
EUROPA数据集系统性地解决了法律领域中多语言关键短语生成缺乏标准语料库的学术难题。以往研究多聚焦于英文科学文献,忽略了法律文本中语言多样性、术语标准化与跨语言对齐的复杂性。通过提供按时间划分的训练、验证与测试集,该数据集支持对模型时间泛化能力的评估,揭示了现有多语言模型在法律专用语料上的显著性能瓶颈,为设计更鲁棒、更具领域适应性的生成架构指明了方向。
衍生相关工作
围绕EUROPA数据集,学术界已衍生出多项具有影响力的研究工作。例如,研究者基于该数据集探索了提示学习与指令微调在多语言法律关键短语生成中的效果,验证了大型语言模型在零样本场景下的迁移潜力。同时,该数据集也被用于评估对比学习与跨语言预训练模型(如XLM-R、mT5)在法律文本细粒度语义理解上的表现,推动了领域专用语言模型的进一步优化。此外,基于EUROPA的时间划分策略,部分工作专门探讨了法律语言随时间的演化规律,为动态法律知识库的持续更新提供了方法论支撑。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务