
speech-quality-somos-pairwise-diff1.0
收藏官方服务:
资源简介:
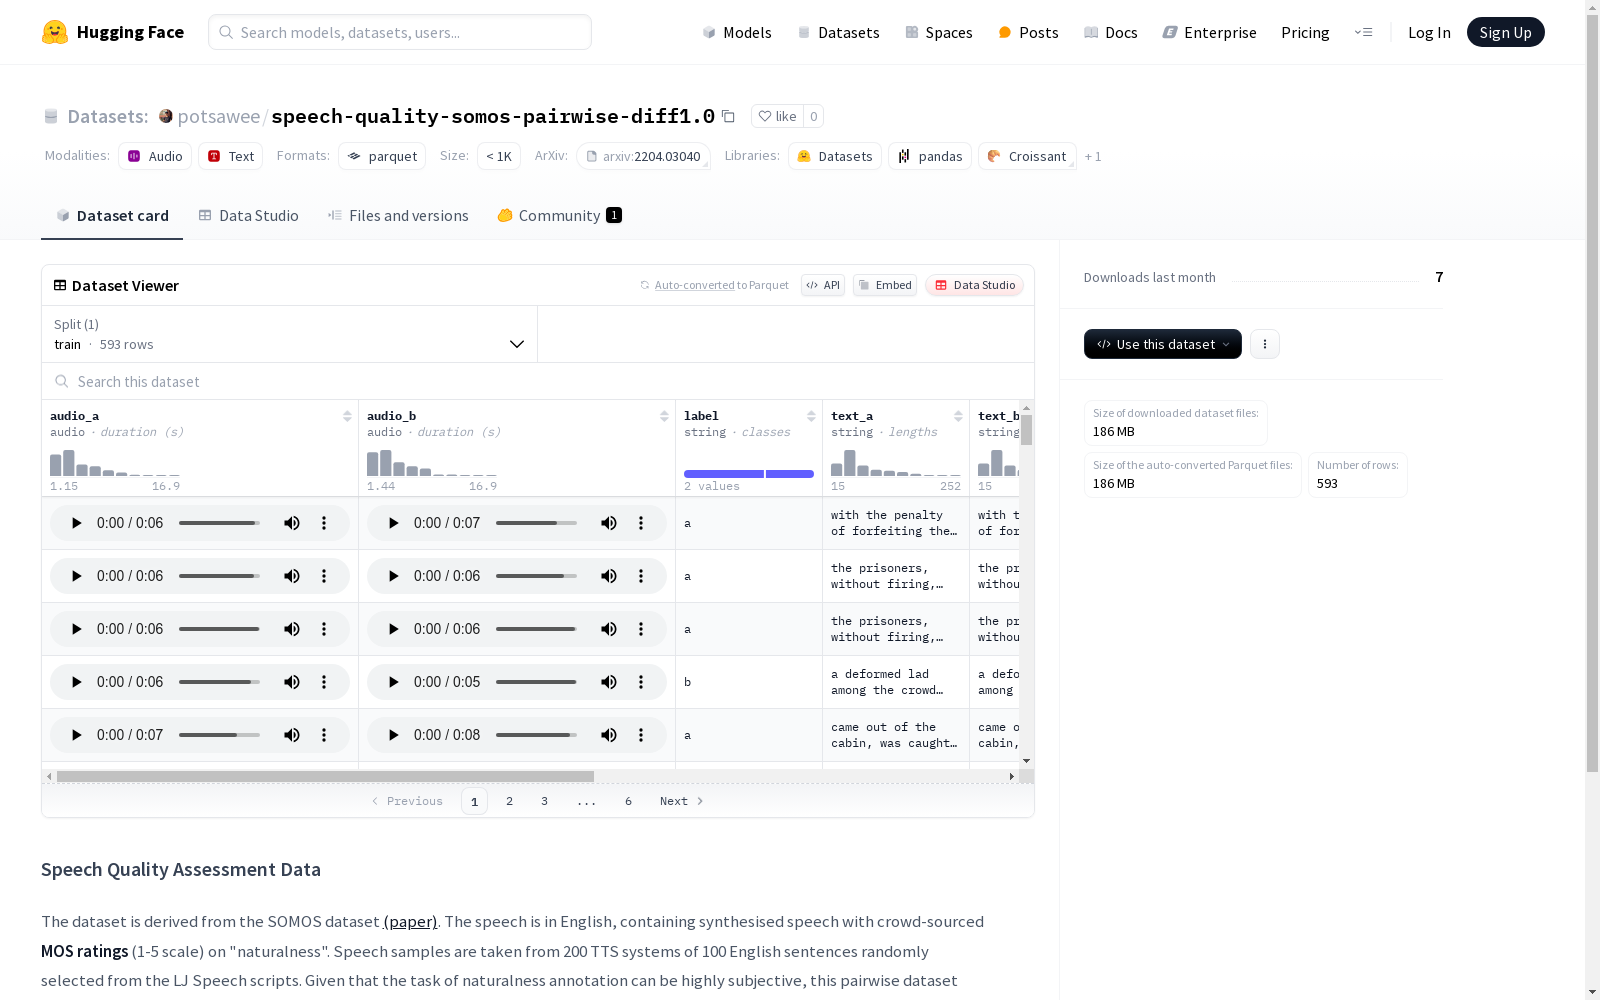
这是一个英语语音质量评估数据集,包含合成语音的众包MOS评分(1-5等级),评分基于语音的自然度。数据集中的语音样本来自于200个TTS系统,这些系统随机选取了LJ Speech脚本中的100个英语句子。只有当两个音频样本的平均MOS评分差异大于1.0时,这些成对的样本才会被包含在数据集中。标签指示哪个音频样本听起来更自然。
This is an English speech quality assessment dataset containing crowdsourced MOS (Mean Opinion Score) ratings on a 1-5 scale for synthesized speech, where the ratings are based on speech naturalness. The speech samples in the dataset are sourced from 200 TTS systems, each of which randomly selected 100 English sentences from the LJ Speech script. Only paired audio samples with an average MOS score difference greater than 1.0 are included in the dataset. The label indicates which of the two audio samples sounds more natural.
创建时间:
2025-04-28
原始信息汇总
数据集概述
基本信息
- 数据集名称: Speech Quality Assessment Data
- 来源: 派生自SOMOS数据集 (论文链接)
- 语言: 英语
- 内容: 包含合成语音及众包的"自然度"MOS评分(1-5分制)
数据特征
- 音频特征:
audio_a: 音频Aaudio_b: 音频B
- 文本特征:
text_a: 音频A对应的文本text_b: 音频B对应的文本
- 评分特征:
mos_a: 音频A的MOS评分mos_b: 音频B的MOS评分
- 标识符:
uttId_a: 音频A的 utterance IDuttId_b: 音频B的 utterance ID
- 标签:
label: 表示哪个音频更自然a: 音频A比音频B更自然b: 音频B比音频A更自然
数据来源
- 语音样本来自200个TTS系统
- 100个英语句子随机选自LJ Speech脚本
- 仅包含MOS评分平均差异大于1.0的语音对
数据集结构
- 训练集:
- 样本数量: 593
- 大小: 266,699,987字节
- 下载大小: 186,483,559字节
- 总大小: 266,699,987字节
搜集汇总
数据集介绍
构建方式
该数据集源自SOMOS数据集,专注于英语合成语音的自然度评估。通过从200个文本转语音系统中随机选取100个LJ Speech脚本句子构建样本库,采用众包方式获取平均意见分数(MOS,1-5分制)标注。为降低主观标注偏差,创新性地筛选MOS评分差异大于1.0的语音对,形成具有显著区分度的对比数据。每个样本包含两段语音及其对应的文本转录、MOS分数和唯一标识符,通过专业音频处理流程确保数据质量。
特点
数据集核心价值在于其精细设计的对比评估体系,所有语音对均满足MOS分差≥1.0的严格标准,有效增强模型训练的区分能力。包含593组平行样本,每组配备双通道音频、原始文本及精确MOS评分,支持端到端的语音质量对比分析。独特的二元标注机制(label=a/b)直观反映语音自然度的相对优劣,为语音合成系统的迭代优化提供精准反馈。音频采样规格统一,文本内容覆盖多样化发音场景,具有较高的学术研究价值。
使用方法
该数据集适用于开发语音质量评估模型,建议采用对比学习框架处理成对音频数据。加载时需同步读取audio_a/b两段语音及其MOS分数,利用label字段构建监督信号。典型应用场景包括:训练神经网络预测语音自然度相对排序,验证语音增强算法效果,或作为TTS系统输出的自动评估基准。使用时应保持训练集原有划分,注意处理变长音频时需统一采样率,文本转录信息可用于多模态联合建模。
背景与挑战
背景概述
在语音合成技术快速发展的背景下,评估合成语音的自然度成为关键挑战。'speech-quality-somos-pairwise-diff1.0'数据集源自SOMOS数据集,由国际研究团队于2022年构建,旨在提供一种可靠的语音质量评估基准。该数据集聚焦于英语合成语音的自然度评价,包含200种不同文本转语音系统生成的语音样本,基于LJ Speech语料库中的100个英文句子构建。通过众包方式获取平均意见分数,采用1-5分的MOS评分体系,为语音合成系统的性能比较提供了重要依据。
当前挑战
语音自然度评估面临主观性强、标准不统一的固有难题。该数据集通过筛选MOS评分差异大于1.0的语音对来降低标注噪声,但如何确保跨系统、跨语句评分的可比性仍是核心挑战。在构建过程中,研究者需处理众包评分的一致性控制问题,平衡数据规模与标注质量的矛盾。同时,语音样本来自多样化的TTS系统,系统间的参数差异为建立统一的评估框架带来技术难度。数据集的设计还需考虑语音内容、说话人特征等混淆因素对评分的影响。
常用场景
经典使用场景
在语音合成技术的研究中,speech-quality-somos-pairwise-diff1.0数据集被广泛用于评估不同文本到语音(TTS)系统的自然度表现。通过提供成对的语音样本及其对应的平均意见分数(MOS)差异,该数据集为研究者提供了一个标准化的基准,用于比较和优化TTS系统的输出质量。这种成对比较的方法尤其适用于主观性较强的自然度评估任务。
实际应用
在实际应用中,该数据集被用于开发和优化语音合成系统的质量评估工具。例如,语音助手和有声读物平台的开发者可以利用该数据集来测试和提升其TTS系统的自然度,从而改善用户体验。此外,该数据集还可用于语音修复和增强技术的评估,为相关应用提供技术支撑。
衍生相关工作
基于该数据集,研究者们开展了一系列经典工作,包括开发新的语音质量评估模型和优化现有TTS系统的自然度。例如,一些研究利用该数据集训练深度学习模型,以自动预测语音样本的MOS分数。这些工作不仅扩展了数据集的应用范围,还为语音合成技术的进步提供了重要参考。
以上内容由遇见数据集搜集并总结生成


