QWQ-LONGCOT-500K
收藏资源简介:
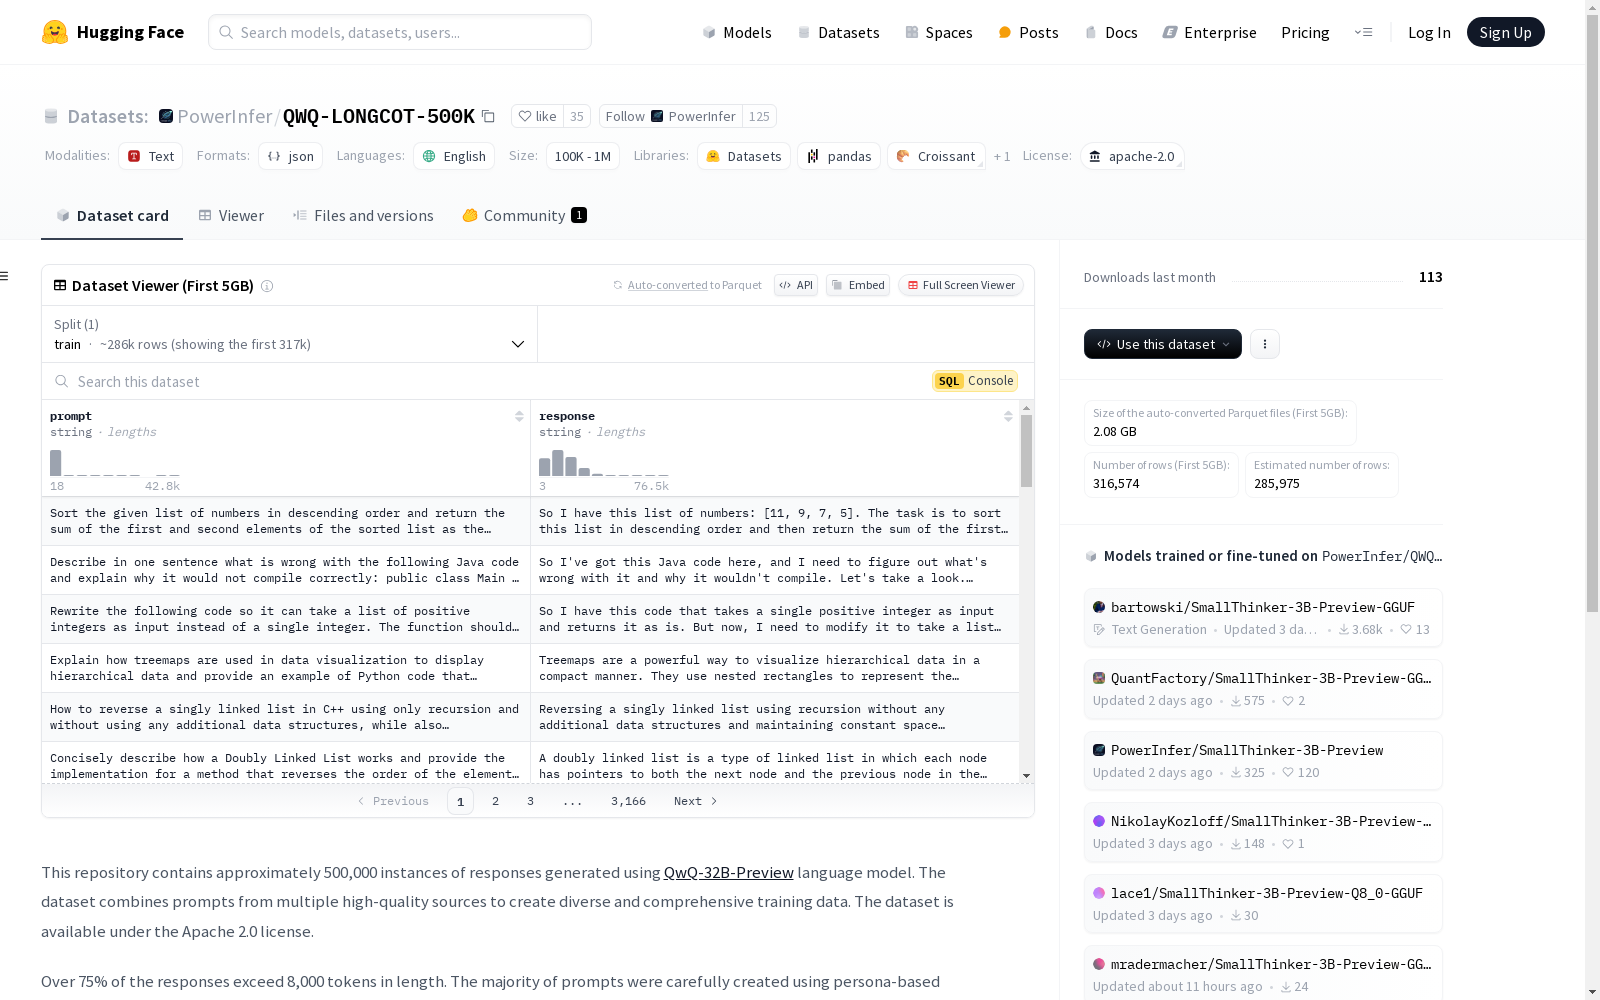
QWQ-LONGCOT-500K 是一个大规模的对话型推理数据集,旨在提升语言模型在长篇对话中的推理能力,包含多种复杂的对话场景和问题类型。该数据集包含 500,000 条多轮对话,每个对话提供了上下文信息与问题,以及相关的答案。对话内容涉及多种推理任务,如因果推理、常识推理等。QWQ-LONGCOT-500K 由人工标注生成,结合了多个领域的知识,旨在训练语言模型处理更加复杂的对话推理任务。该数据集可用于大模型的微调,特别是在对话生成和推理领域的应用,包括智能客服、对话式AI等。
QWQ-LONGCOT-500K is a large-scale conversational reasoning dataset developed to enhance the reasoning capabilities of language models in long-form conversations. It covers diverse complex conversational scenarios and question types. The dataset contains 500,000 multi-turn dialogues, each with contextual information, related questions and corresponding answers. The dialogue content involves various reasoning tasks, such as causal reasoning and commonsense reasoning. QWQ-LONGCOT-500K is manually annotated and generated, integrating knowledge from multiple fields, aiming to train language models to handle more complex conversational reasoning tasks. This dataset can be used for fine-tuning large language models, especially for applications in the fields of conversational generation and reasoning, including intelligent customer service and conversational AI.
数据集概述
基本信息
- 数据集名称: QWQ-LONGCOT-500K
- 许可证: Apache 2.0
- 语言: 英语 (en)
数据集内容
- 数据量: 约500,000条实例
- 数据来源: 使用QwQ-32B-Preview语言模型生成的响应
- 数据特点:
- 超过75%的响应长度超过8,000个token
- 大多数提示使用基于角色的方法精心创建,以生成具有挑战性的指令
- 数据结合了多个高质量来源的提示,以创建多样化和全面的训练数据
偏见、风险与限制
- 语言限制: 数据集主要为英语
- 偏见与错误: 数据集继承了用于种子源和生成模型的数据中已知的偏见、错误和遗漏
- 领域限制: 数据集不旨在代表任何特定领域,包含通用数据
- 数据准确性: 数据集是合成生成的,可能包含不准确之处,不能准确反映现实世界现象
- 泛化能力: 由于数据集的合成性质,其泛化到现实世界案例的能力可能有限
- 用途: 数据旨在用于模型训练和合成数据生成的研究和实验