
ittailup/google-la-voices
收藏官方服务:
资源简介:
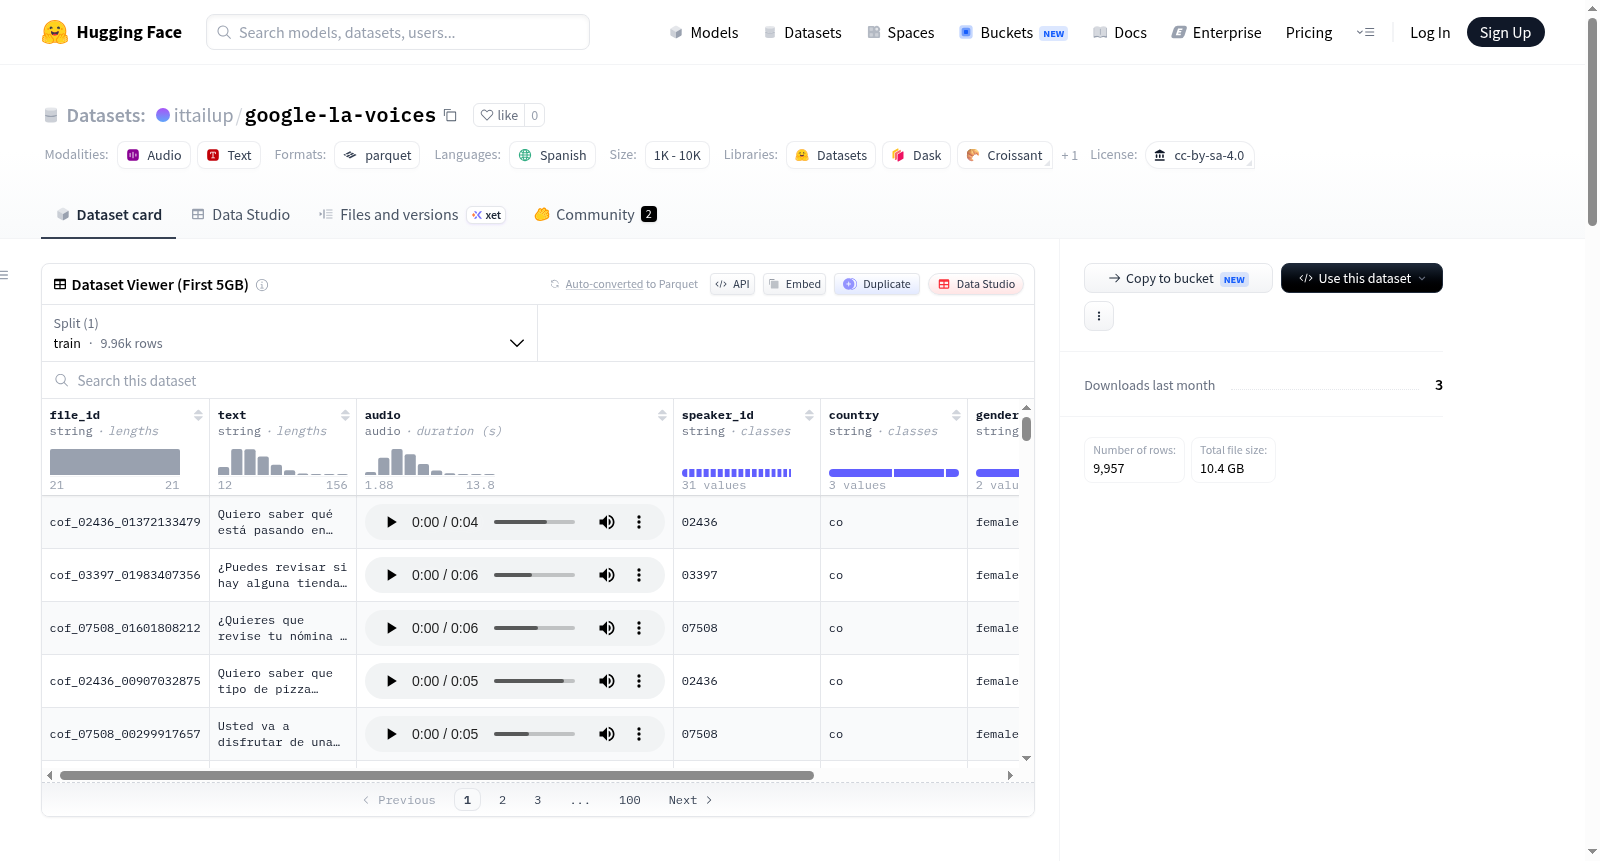
数据集google-la-voices主要包含音频和文本数据,涉及多个说话者、国家和性别。数据集的特征包括文件ID、文本、音频、说话者ID、国家、性别和持续时间。数据集分为训练集,包含24437个样本,总大小为13065525050.19字节。数据集的许可证为cc-by-sa-4.0,语言为西班牙语。此外,README还提供了关于说话者、国家和性别的持续时间统计信息。
数据集google-la-voices主要包含音频和文本数据,涉及多个说话者、国家和性别。数据集的特征包括文件ID、文本、音频、说话者ID、国家、性别和持续时间。数据集分为训练集,包含24437个样本,总大小为13065525050.19字节。数据集的许可证为cc-by-sa-4.0,语言为西班牙语。此外,README还提供了关于说话者、国家和性别的持续时间统计信息。
提供机构:
ittailup原始信息汇总
数据集概述
特征信息
- file_id: 字符串类型
- text: 字符串类型
- audio: 音频类型
- speaker_id: 字符串类型
- country: 字符串类型
- gender: 字符串类型
- duration: 浮点数类型
数据分割
- train: 包含24437个样本,总大小为13065525050.19字节
下载与数据集大小
- 下载大小: 10411959256字节
- 数据集大小: 13065525050.19字节
许可与语言
- 许可: cc-by-sa-4.0
- 语言: 西班牙语(es)
详细统计
说话者时长
| Speaker | Duration (seconds) |
|---|---|
| 00295 | 1606.144 |
| 00610 | 7026.261 |
| 01208 | 3284.907 |
| 01523 | 6309.888 |
| 02121 | 4687.445 |
| 02436 | 4654.080 |
| 02484 | 9379.925 |
| 02485 | 130.219 |
| 03034 | 5186.048 |
| 03349 | 5143.381 |
| 03397 | 7852.203 |
| 03398 | 118.101 |
| 03853 | 638.037 |
| 04310 | 8260.437 |
| 04311 | 105.472 |
| 04766 | 590.165 |
| 05223 | 8257.773 |
| 05679 | 846.251 |
| 06136 | 10207.707 |
| 06592 | 863.659 |
| 07049 | 7580.715 |
| 07060 | 575.659 |
| 07505 | 1743.531 |
| 07508 | 8169.131 |
| 07973 | 641.109 |
| 08421 | 7091.713 |
| 08784 | 8907.605 |
| 08886 | 649.387 |
| 09334 | 7352.247 |
| 09697 | 7443.029 |
| 09799 | 755.456 |
国家时长
| Country | Duration (seconds) |
|---|---|
| ar | 28902.4 |
| cl | 25737.899 |
| co | 27286.101 |
| pe | 33189.803 |
| pr | 3610.027 |
| ve | 17331.457 |
性别时长
| Gender | Duration (seconds) |
|---|---|
| female | 71820.288 |
| male | 64237.398 |
搜集汇总
数据集介绍
构建方式
在低资源语音合成领域,高质量的多说话人语料库构建始终是一项严峻挑战。该数据集源自一项针对拉丁美洲西班牙语的大规模众包采集工作,通过精心设计的远程录音协议,广泛招募来自阿根廷、智利、哥伦比亚、秘鲁、波多黎各和委内瑞拉等多个国家的母语者参与录制。每位说话人在受控环境下朗读指定文本,音频文件经自动质量筛选与人工校验双重审核,最终保留了31位说话人的24437条语音样本,总时长超过136000秒。数据集以标准格式存储每条样本的音频波形、对应文本、说话人标识、国籍、性别及时长信息,并遵循CC-BY-SA-4.0许可协议开放共享。
特点
该数据集的核心特色在于其丰富的地理与性别多样性。语料覆盖六个拉丁美洲西班牙语变体,其中秘鲁、阿根廷和哥伦比亚的语音时长占比最高,分别为33190秒、28902秒和27286秒,有效捕捉了区域间的发音与韵律差异。性别分布均衡,女性说话人贡献71820秒,男性贡献64237秒,避免了单一声学特征的偏倚。此外,每位说话人的录音时长差异显著,从最短的105秒到最长的10208秒,这种非均匀分布为评估说话人自适应与多说话人语音合成模型的鲁棒性提供了天然测试场景。数据集还附有详细的元数据,便于研究者进行细粒度的声学与语言分析。
使用方法
研究者可通过HuggingFace Datasets库便捷加载该数据集,调用load_dataset('ittailup/google-la-voices')即可获取包含训练集的Dataset对象。每条样本提供'audio'字段(内含采样率与波形数组)、'text'转录文本及'speaker_id'等元数据。在语音合成任务中,可基于'speaker_id'和'country'字段构建说话人嵌入或区域自适应模块;在语音识别场景下,可直接使用'audio'与'text'配对进行端到端训练。由于数据规模适中,建议采用五折交叉验证评估模型泛化能力。音频文件以标准编码格式存储,可直接输入至Wav2Vec2、Tacotron或FastSpeech等主流框架,无需额外预处理。
背景与挑战
背景概述
在低资源文本转语音(Text-to-Speech, TTS)研究领域,拉丁美洲西班牙语因其地域多样性而面临数据稀缺的困境。谷歌公司与学术研究者于2020年联合构建了Google LA Voices数据集,旨在弥补这一空白。该数据集由Adriana Guevara-Rukoz等学者主导,收录了来自阿根廷、智利、哥伦比亚、秘鲁、波多黎各和委内瑞拉等六个拉丁美洲国家的31位发音人共计约24,437条语音样本,总时长超过38小时。其核心研究问题在于如何通过大规模众包采集,为低资源语言变体提供高质量、多口音的语音数据,以推动TTS系统的地域适应性。该数据集以CC-BY-SA-4.0许可发布,已成为拉丁美洲西班牙语语音合成研究的重要基准,显著提升了该领域对语音多样性的关注。
当前挑战
Google LA Voices数据集所面临的挑战主要源于低资源TTS系统的固有难题。首先,拉丁美洲西班牙语内部存在显著的语音变异,包括不同国家间的口音、语调和节奏差异,这对模型在跨地域泛化能力上提出了严峻考验。其次,数据构建过程中,众包采集难以保证录音环境的统一性,导致背景噪声、录音设备差异和发音人个体特征(如性别比例失衡,女性样本约占53%)成为影响数据质量的潜在因素。此外,部分发音人样本时长极短(如不足130秒),限制了模型对少样本说话人的学习能力。最后,数据覆盖的六个国家中,波多黎各样本仅占总时长的约3%,这种地域分布不均进一步加剧了模型在低资源口音上的性能瓶颈。
常用场景
经典使用场景
在低资源语言语音合成领域,ittailup/google-la-voices数据集作为拉丁美洲西班牙语的多说话人语音语料库,其经典使用场景集中于文本到语音(TTS)系统的训练与评估。该数据集包含来自31位说话人的录音,覆盖阿根廷、智利、哥伦比亚、秘鲁、波多黎各和委内瑞拉等六国口音,并标注了性别与时长信息,为构建具有地域多样性和声学鲁棒性的语音合成模型提供了高质量基础。研究者常利用其平衡的说话人分布与丰富的口音变体,开展多说话人TTS模型的迁移学习与自适应研究,尤其适用于低资源场景下的语音生成任务。
解决学术问题
该数据集核心解决了低资源拉丁美洲西班牙语语音合成中数据匮乏与口音多样性不足的学术难题。此前,主流TTS研究多聚焦于高资源语言如英语或标准西班牙语,导致拉丁美洲地区方言与口音在语音技术中的代表性严重缺失。通过提供涵盖六国口音、总时长超136小时的标注语音数据,该数据集使研究者得以探索跨地域口音的声学建模、说话人自适应与口音解耦等前沿问题,推动了多口音TTS系统的泛化能力提升,并为低资源语言语音技术的公平性与包容性研究奠定了数据基石。
衍生相关工作
该数据集衍生了一系列经典学术工作,包括Guevara-Rukoz等人(2020)在LREC上发表的众包拉丁美洲西班牙语低资源TTS研究,该论文详细介绍了数据采集方法与基线系统构建。后续工作进一步探索了基于该数据集的跨语言迁移学习、说话人自适应TTS与口音转换技术,例如利用预训练模型结合少量目标口音数据进行微调,显著提升合成语音的自然度与口音保真度。此外,该数据集也被用于评估语音合成中的公平性指标,推动多口音场景下TTS系统的性能对比与标准化评测。
以上内容由遇见数据集搜集并总结生成


