遇见数据集

Ethosoft/nedo-turkish-sft-mixtures

收藏
Hugging Face2026-05-26 更新2026-05-31 收录
官方服务:

资源简介:

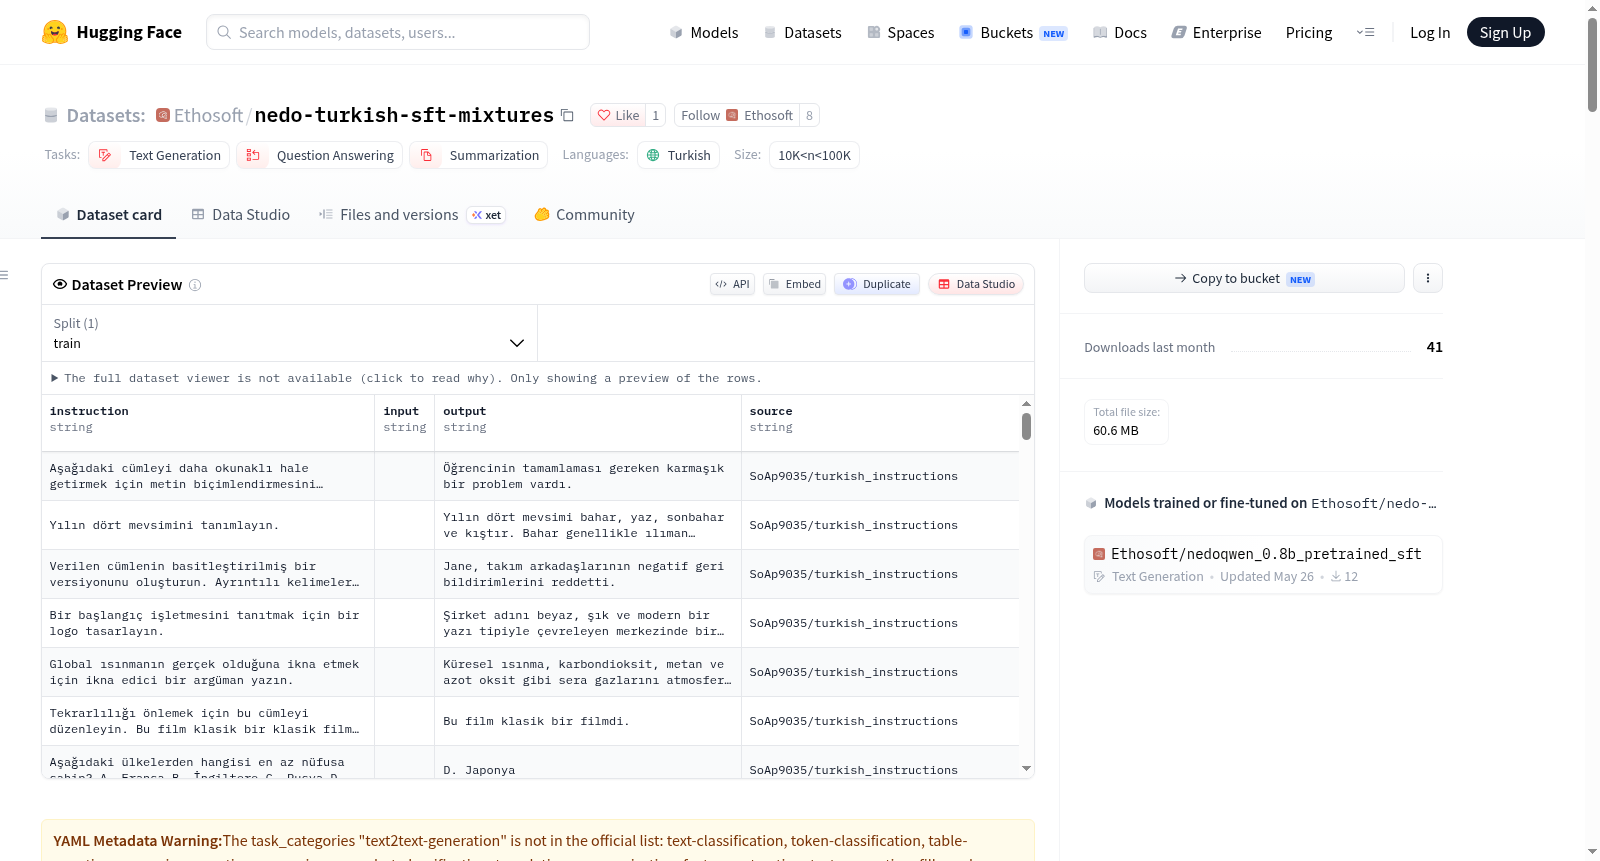
NEDO Turkish SFT Mixtures是一个土耳其语监督微调数据集,专为NEDO Turkish SLM项目设计。该数据集用于在NEDO Turkish 65K标记化网络语料库基础预训练后,微调NEDOQwen风格的土耳其语仅解码器语言模型。数据集包含两个主要文件:tr_sft_clean_20k.jsonl(20,000个示例,推荐使用,为更干净的土耳其语指令子集)和tr_sft_hf_mix.jsonl(104,078个示例,实验性,为更大但更嘈杂的土耳其语指令混合集)。数据格式为JSONL,每条记录包含instruction(用户指令)、input(可选额外上下文)、output(目标助手响应)和source(上游数据源标识)字段。数据集支持多种任务类型,如文本生成、问答、摘要和文本到文本生成,主要用于土耳其语监督微调、小型语言模型对齐实验、指令跟随研究以及土耳其SLM评估和消融研究。数据集基于上游土耳其语指令数据集(如NovusResearch/turkish_instructions、SoAp9035/turkish_instructions等)构建,用户需遵守上游许可条款。

NEDO Turkish SFT Mixtures is a Turkish supervised fine-tuning dataset prepared for the NEDO Turkish SLM project. It is designed to fine-tune NEDOQwen-style Turkish decoder-only language models after base pretraining on the NEDO Turkish 65K tokenized web corpus. The dataset includes two main files: tr_sft_clean_20k.jsonl (20,000 examples, recommended as a cleaner Turkish instruction subset) and tr_sft_hf_mix.jsonl (104,078 examples, experimental, as a larger but noisier Turkish instruction mixture). The data format is JSONL, with each record containing fields: instruction (user instruction), input (optional extra context), output (target assistant response), and source (upstream dataset identifier). It supports multiple task categories such as text generation, question answering, summarization, and text2text generation. The dataset is intended for Turkish supervised fine-tuning, small language model alignment experiments, instruction-following research, and Turkish SLM evaluation and ablation studies. It is derived from upstream Turkish instruction datasets (e.g., NovusResearch/turkish_instructions, SoAp9035/turkish_instructions), and users are responsible for complying with upstream licenses.
提供机构:
Ethosoft
搜集汇总
数据集介绍
Ethosoft/nedo-turkish-sft-mixtures 数据集图片
构建方式
在土耳其语小规模语言模型研发的背景下,该数据集面向NEDOQwen系列解码器模型的有监督微调需求而构建。其数据源自多个上游土耳其语指令数据集,包括NovusResearch与SoAp9035的指令语料以及Dbmaxwell的金融指令数据。构建过程中,通过脚本从更广泛的混合语料中过滤掉噪声较高的翻译风格数据,从而提炼出较为纯净的2万条指令子集;同时保留一个未经深度清洗的十万余条混合版本,以支持后续的实验与数据筛选研究。
特点
该数据集呈现出两种规模与质量层次的变体。精炼版包含2万条样本,字段涵盖指令、输入、输出与来源,经内部实验验证在基础问答与指令格式遵循方面表现更优。混合版则扩展至104078条,任务类型更为多样,涉及改写、问答、解释、分类、摘要及金融领域指令,但其中可能夹杂翻译痕迹、事实偏差或措辞不畅之处。整体而言,该数据集以土耳其语指令跟随为核心,定位于有监督微调的研究性产物,不宜作为事实基准使用。
使用方法
使用该数据集时,可依据JSONL格式逐行读取,每行包含指令、可选输入、目标输出及来源标识。在训练阶段,依据输入是否为空,采用不同的提示模板拼接用户指令与助手回复;若存在额外信息,则插入相应段落。训练损失仅计算在助手回答部分,提示部分被掩码为-100。推荐从精炼的2万条样本入手,以获取更稳定的指令跟随行为;混合版本可用于实验性探索或进一步筛选。使用者需自行确认上游数据集的许可条款,并注意避免将其直接用于高风险部署或事实性评测。
背景与挑战
背景概述
土耳其语作为低资源语言,长期缺乏高质量指令微调数据集,制约了小型语言模型的指令遵循能力。NEDO土耳其语SLM项目团队针对此瓶颈,在完成65K词元化网络语料预训练后,构建了nedo-turkish-sft-mixtures监督微调混合数据集,包含2万条清洁子集与10.4万条实验性混合子集,用于微调NEDOQwen 0.8B解码器模型。该数据集通过整合多个上游土耳其语指令资源并过滤翻译噪声,探索了指令格式行为与基础问答能力的提升路径,为土耳其语小模型对齐研究提供了可复现的微调管线范本。
当前挑战
该数据集面临的核心挑战在于土耳其语指令微调数据稀缺且噪声显著,上游翻译式数据常含事实错误与措辞生硬问题,导致模型结构化提示行为弱化。构建中需在数据规模与质量间权衡:较大混合集虽覆盖任务类型广泛,却因未充分清洗而降低指令遵循稳定性;清洁子集虽表现更优,但领域覆盖有限,难以支撑智能体等复杂场景。此外,上游许可证合规与数据溯源问题亦增加了下游使用的法律风险,而现有数据尚不足以作为事实基准或高 stakes 部署。
常用场景
经典使用场景
在土耳其语小规模语言模型的对齐训练中,该数据集充当监督微调的核心资源。研究者通常选取推荐使用的干净子集tr_sft_clean_20k.jsonl,按照NEDO项目约定的提示模板,将指令与输入拼接后输入解码器模型,并以助手回答部分计算损失。这一流程常见于基础预训练完成后的轻量级指令遵循训练,用以激活模型对土耳其语任务指令的理解与响应能力,例如事实问答、文本改写与摘要生成。
实际应用
在实际部署中,该数据集用于训练面向土耳其语的轻量级对话助手与任务型生成系统。其干净子集能够支撑基础问答与指令格式化输出,适用于客服自动回复、教育问答及金融领域文本处理等场景。开发者可借助混合子集进行数据筛选与持续治理,为构建低延迟、低成本的土耳其语智能代理提供训练起点,同时需注意对上游许可的合规审查。
衍生相关工作
围绕该数据集衍生了一系列与NEDO土耳其语小模型项目相关的工作,包括基于65K词元化网络语料的预训练数据集Ethosoft/nedo-turkish-65k-tokenized-60b,以及计划发布的NEDOQwen 0.8B基础模型与干净监督微调模型。这些工作共同构成了从预训练到指令对齐的完整流水线,并为后续领域特定微调与智能体行为研究提供了可扩展的基线。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务