
harpomaxx/jurisgpt
收藏官方服务:
资源简介:
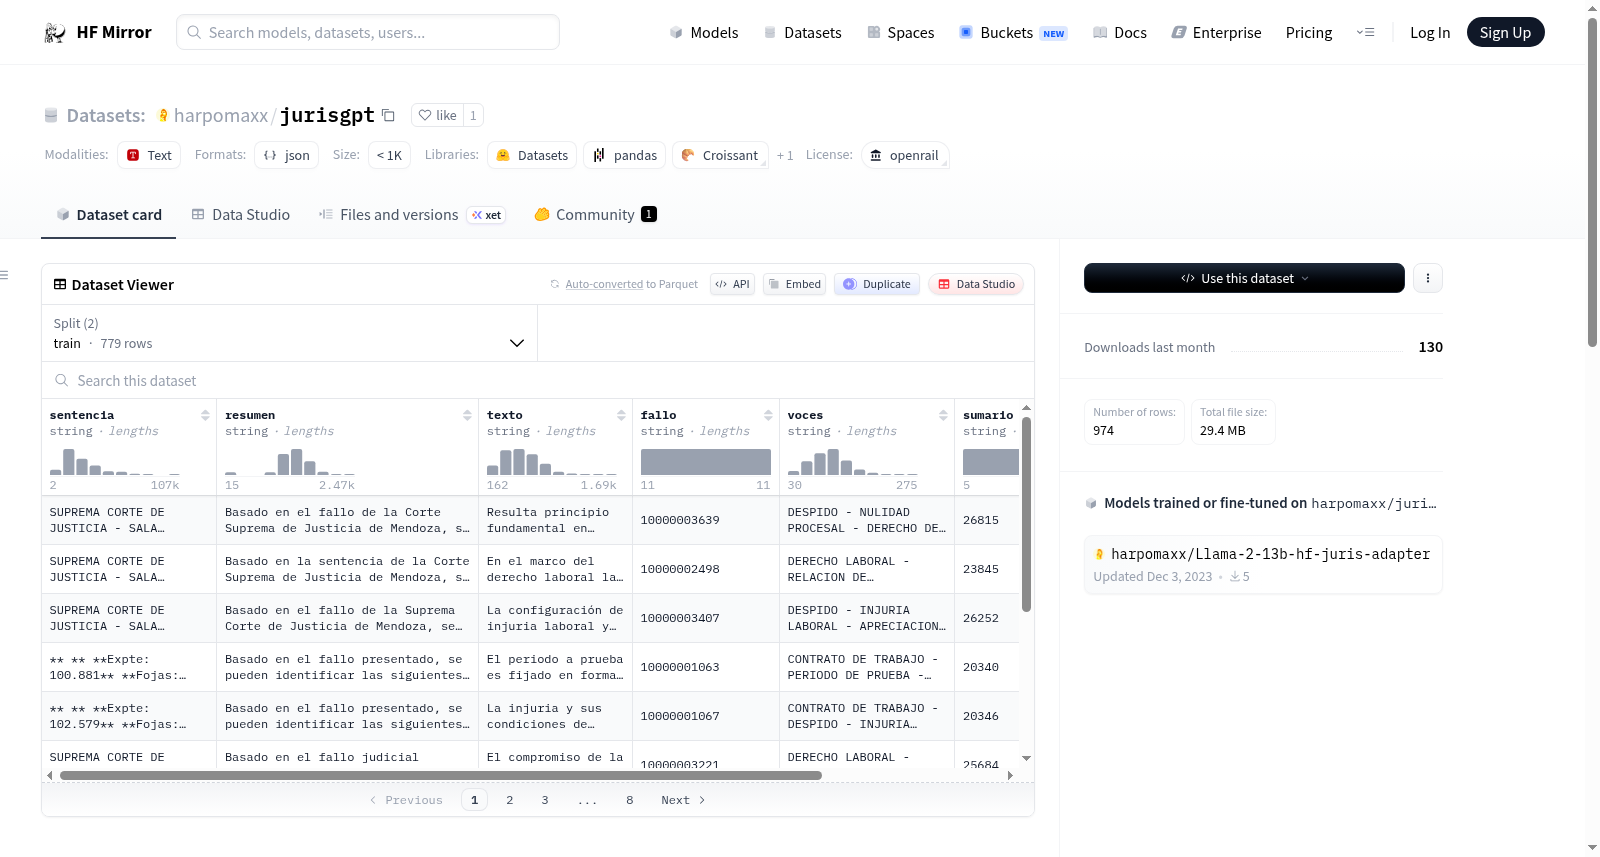
该数据集是法律文档及其相关摘要、主题(materia)和关键词(voces)的集合,主要关注劳动法领域,特别是阿根廷的法律程序、劳动权利和工人赔偿法。每个条目包含唯一标识符、主题、关键词、法律文档文本及其摘要。数据集对法律研究,尤其是劳动法领域的研究具有重要价值,可用于法律文本摘要、关键词提取和法律文档分类等模型的训练。数据集以JSON格式提供,内容主要为西班牙语,数据来源于阿根廷的官方法律文档和摘要。
该数据集是法律文档及其相关摘要、主题(materia)和关键词(voces)的集合,主要关注劳动法领域,特别是阿根廷的法律程序、劳动权利和工人赔偿法。每个条目包含唯一标识符、主题、关键词、法律文档文本及其摘要。数据集对法律研究,尤其是劳动法领域的研究具有重要价值,可用于法律文本摘要、关键词提取和法律文档分类等模型的训练。数据集以JSON格式提供,内容主要为西班牙语,数据来源于阿根廷的官方法律文档和摘要。
提供机构:
harpomaxx原始信息汇总
数据集描述
标题
法律文本与摘要数据集
描述
该数据集包含法律文档及其相关摘要、主题(materia)和关键词(voces)。主要关注劳动法领域,特别是阿根廷的法律程序、劳动权利和工人赔偿法。
结构
每个条目包含以下字段:
sumario:法律文档的唯一标识符。materia:法律文档的主题,即“DERECHO DEL TRABAJO”(劳动法)。voces:总结文档主要主题的关键词或短语,如“FALLO PLENARIO”、“DERECHO LABORAL”、“LEY SOBRE RIESGOS DEL TRABAJO”等。sentencia:法律文档的文本,包括法律、先例和详细分析的引用。文本由Claude v2 LLM总结。texto:法律摘要。
应用
该数据集对法律研究特别有价值,尤其是在劳动法领域。可用于训练法律文本摘要、关键词提取和法律文档分类模型。此外,它对法律研究领域的学术研究也很有用,特别是关于阿根廷的劳动法和工人赔偿。
格式
数据集以JSON格式提供,便于与大多数数据处理和机器学习工具集成。
语言
内容主要为西班牙语,反映其对阿根廷法律的关注。
来源和真实性
数据来自阿根廷的官方法律文档和摘要。用户需验证法律文本的真实性和当前相关性,因为它们可能已经过修订或可能不反映最新的法律立场。
搜集汇总
数据集介绍
背景与挑战
背景概述
该数据集是一个专注于阿根廷劳动法领域的法律文件和摘要集合,包含974条记录,每条记录包含法律文件文本、摘要、主题和关键词等字段。数据集以JSON格式提供,适用于法律研究和自然语言处理任务。
以上内容由遇见数据集搜集并总结生成


