遇见数据集

lance-format/trivia-qa-lance

收藏
Hugging Face2026-05-18 更新2026-05-31 收录
官方服务:

资源简介:

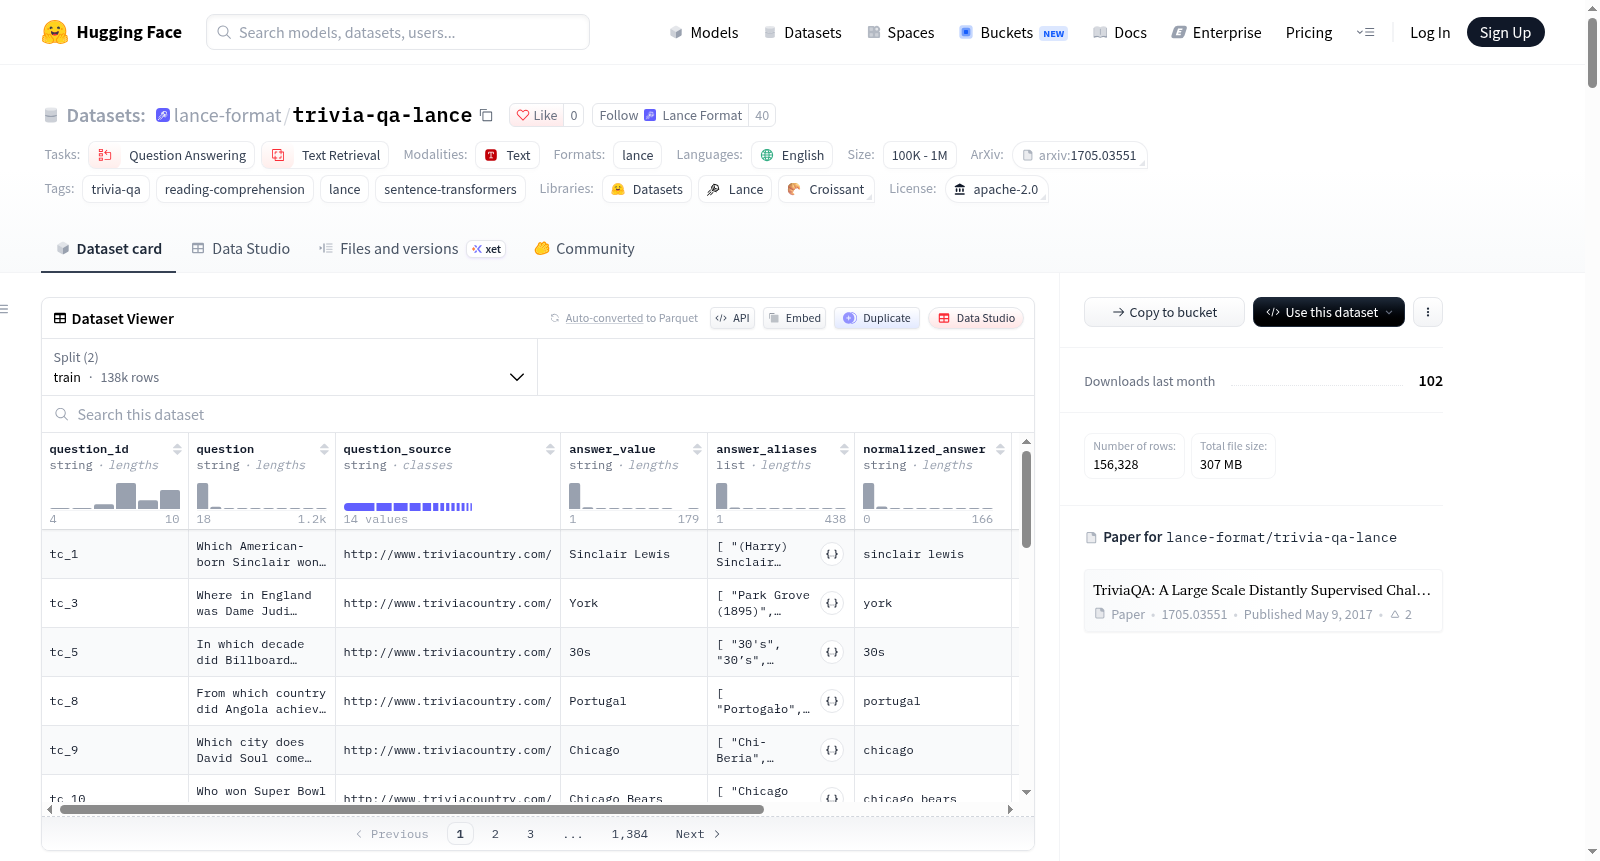
TriviaQA(Lance格式)是TriviaQA数据集(rc.nocontext配置)的Lance格式版本,这是一个大规模的阅读理解数据集,包含琐事问题及其标准答案、可接受的别名列表和实体类型元数据。该版本去除了原始数据集中的多GB上下文数据(如entity_pages和search_results),以保持数据集紧凑,同时保留了闭卷问答、检索研究和作为搜索目标所需的一切内容。数据集包含超过138,000个问题,预计算了384维问题嵌入(使用sentence-transformers/all-MiniLM-L6-v2模型,余弦归一化),并内置了IVF_PQ索引以支持语义检索。此外,还包含全文倒排索引、B树索引和位图索引,支持多种查询方式。数据集适用于机器学习研究、问答系统开发和信息检索任务。

A Lance-formatted version of TriviaQA (rc.nocontext config) — a large reading-comprehension dataset of trivia questions paired with a canonical answer, accepted aliases, and entity-type metadata — with MiniLM question embeddings stored inline and ready for retrieval at hf://datasets/lance-format/trivia-qa-lance/data. The rc.nocontext slice is the standard reading-comprehension form without the multi-gigabyte entity_pages / search_results payloads, which keeps the dataset compact while preserving everything needed for closed-book QA, retrieval research, and as a search target.
提供机构:
lance-format
搜集汇总
数据集介绍
lance-format/trivia-qa-lance 数据集图片
构建方式
在开放域问答与机器阅读理解研究中,TriviaQA 常被用作检验模型事实记忆与检索能力的大规模基准。trivia-qa-lance 的构建取径于原始 TriviaQA 的 rc.nocontext 配置,该切片剥离了体积庞大的 entity_pages 与 search_results 载荷,仅保留问题、规范答案、可接受别名、标准化答案与实体类型等核心字段。转换过程将上述字段组织为 Lance 列式格式,并以内联方式写入经 sentence-transformers/all-MiniLM-L6-v2 编码、余弦归一化的 384 维问题嵌入。数据划分为 138,384 条训练样本与 17,944 条验证样本,同时配套 IVF_PQ、倒排、B 树与位图索引,使文本、向量与元数据得以在同一数据文件中协同存储。
特点
作为面向检索与封闭式问答的语料,trivia-qa-lance 的显著特征在于语义检索资源与原始问答标注的紧密耦合。数据集涵盖 138k 以上 trivia 问题,每条均配有 canonical answer_value、accepted answer_aliases、normalized_answer 及 answer_type,可直接服务精确匹配评估、别名监督与实体类别筛选。预计算的问题嵌入与 IVF_PQ 索引使余弦相似度检索无需重新编码即可展开,倒排索引则支持关键词与混合检索。Lance 的列式底座带来高效随机访问、按列投影、惰性读取与版本化演进能力,并允许向量、全文和 SQL 风格过滤在单次查询中合并,兼顾研究探索与在线服务。
使用方法
面向不同工作流,trivia-qa-lance 提供多层级接口。研究者可通过 HuggingFace datasets.load_dataset 以流式方式快速抽样,也可借助 LanceDB 连接 hf://datasets/lance-format/trivia-qa-lance/data 并打开 train 表,执行向量、全文或混合检索;若需检查模式、片段与索引,则可使用 pylance 直接读取底层 Lance 数据集。生产环境宜先 hf download 至本地,以提升随机访问与 ANN 搜索效率。下游可基于 question_id 合并外部评分,利用 add_columns 派生字段,通过列投影接入 PyTorch DataLoader 训练封闭式问答或重排序模型,并以版本标签固定可复现的数据快照;过滤后的子集亦可物化为本地可写数据库。
背景与挑战
背景概述
在开放域问答与机器阅读理解研究脉络中,TriviaQA源数据集于2017年由Mandar Joshi、Eunsol Choi、Daniel S. Weld与Luke Zettlemoyer等学者提出,隶属华盛顿大学等研究机构,旨在以远程监督方式检验大规模琐碎问题与证据文档间的阅读理解能力。其核心问题在于模型能否跨越长尾实体、复杂事实与多源证据,形成稳健问答推理。trivia-qa-lance承袭TriviaQA的rc.nocontext配置,由lance-format以Apache 2.0许可转换为Lance列式格式,将问题、标准答案、可接受别名、实体类型与MiniLM问句嵌入共置存储,并预建向量、全文与标量索引,为闭卷问答、开放域检索与混合搜索提供紧凑而可复现的基准资源。
当前挑战
面向真实开放域问答与语义检索,该数据集需应对琐碎知识覆盖广、问题表述多样、答案别名丰富、实体类型异质与精确匹配归一化等难题;闭卷设定更要求模型不依赖证据文档即完成事实召回,检索系统则须在稠密语义与关键词信号间取得平衡。构建过程中,转换者需从原TriviaQA的rc.nocontext切面剔除多GB的entity_pages与search_results负载,同时完整保留问答监督信号;为138,384条训练样本与17,944条验证样本生成384维余弦归一化MiniLM嵌入,并构建IVF_PQ、INVERTED、BTREE与BITMAP索引。Hub只读挂载、写入本地化、ANN召回率与延迟权衡、版本固化及惰性列读取亦构成工程挑战。
常用场景
经典使用场景
在开放域问答与稠密检索交汇的研究脉络中,TriviaQA以远程监督构建的大规模琐事问答语料成为检验机器阅读理解的重要基准。trivia-qa-lance承袭其rc.nocontext配置,将十三万余条问题与规范答案、可接受别名及实体类型元数据整合为Lance列式数据,并内嵌MiniLM问题向量与倒排、向量索引。其最经典使用场景在于闭卷问答与语义问题检索:研究者可依托预计算嵌入执行余弦相似度搜索,亦可结合全文索引开展混合检索,从而在无需外部证据页面的条件下评估模型对事实性知识的记忆、匹配与排序能力。
实际应用
在实际应用层面,trivia-qa-lance可作为问答机器人、智能助手与教育测评系统的知识检索与答案核验资源。借助内建IVF_PQ向量索引与全文倒排索引,工程系统能够对用户提问进行语义召回、实体过滤与混合排序,并直接返回规范答案及可接受别名,减少同义表述造成的误判。其Lance格式支持按列投影、随机访问与本地物化,便于在生产环境中构建低延迟检索服务,或以子集方式嵌入检索增强生成管线。版本标签机制亦使线上服务与离线评测可锁定同一数据快照,提升结果可追溯性。
衍生相关工作
围绕TriviaQA形成的经典工作谱系涵盖远程监督阅读理解、开放域问答与稠密检索等方向。原始TriviaQA论文提出大规模琐事问答基准,后续研究常将其用于训练和评测DrQA式检索器、阅读器以及端到端开放域QA系统。随着神经检索兴起,TriviaQA又成为DPR等密集段落检索方法的重要评测集,并广泛出现在检索增强生成、句子嵌入与重排模型的对比实验中。trivia-qa-lance以Lance格式沉淀问题嵌入与索引,延续了这一脉络,使Sentence-Transformers、LanceDB等工具可直接复用数据资产,促进可复现的检索与问答研究。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务