
botp/Azure99_blossom-orca-v3
收藏官方服务:
资源简介:
Blossom Orca V3是一个基于OpenOrca衍生而来的中英双语指令数据集,适用于指令微调。相比于blossom-wizard-v2,本版本完全使用GPT-4进行蒸馏。本数据集从OpenOrca中抽取了系统提示和指令,首先将其翻译为中文并校验翻译结果,再使用指令调用gpt-4-0125-preview模型生成响应,并过滤掉包含自我认知以及拒绝回答的响应,以便后续对齐。此外,为了确保响应风格的一致性以及中英数据配比,本数据集还对未翻译的原始指令也进行了相同的调用,最终得到了1:1的中英双语指令数据。相比直接对原始OpenOrca进行翻译的中文数据集,Blossom Orca的一致性及质量更高。本次发布了全量数据的50%,包含中英双语各20K,共计40K记录。
Blossom Orca V3是一个基于OpenOrca衍生而来的中英双语指令数据集,适用于指令微调。相比于blossom-wizard-v2,本版本完全使用GPT-4进行蒸馏。本数据集从OpenOrca中抽取了系统提示和指令,首先将其翻译为中文并校验翻译结果,再使用指令调用gpt-4-0125-preview模型生成响应,并过滤掉包含自我认知以及拒绝回答的响应,以便后续对齐。此外,为了确保响应风格的一致性以及中英数据配比,本数据集还对未翻译的原始指令也进行了相同的调用,最终得到了1:1的中英双语指令数据。相比直接对原始OpenOrca进行翻译的中文数据集,Blossom Orca的一致性及质量更高。本次发布了全量数据的50%,包含中英双语各20K,共计40K记录。
提供机构:
botp原始信息汇总
数据集概述:Blossom Orca V3
数据集详情
数据集介绍
- Blossom Orca V3 是一个基于OpenOrca衍生而来的中英双语指令数据集,专为指令微调设计。
- 本版本完全使用GPT-4进行蒸馏,从OpenOrca中抽取系统提示和指令,翻译为中文并校验,使用gpt-4-0125-preview模型生成响应,并过滤掉包含自我认知及拒绝回答的响应。
- 数据集确保了响应风格的一致性及中英数据配比,最终得到1:1的中英双语指令数据。
数据集语言
- 数据集主要使用中文和英文。
数据集结构
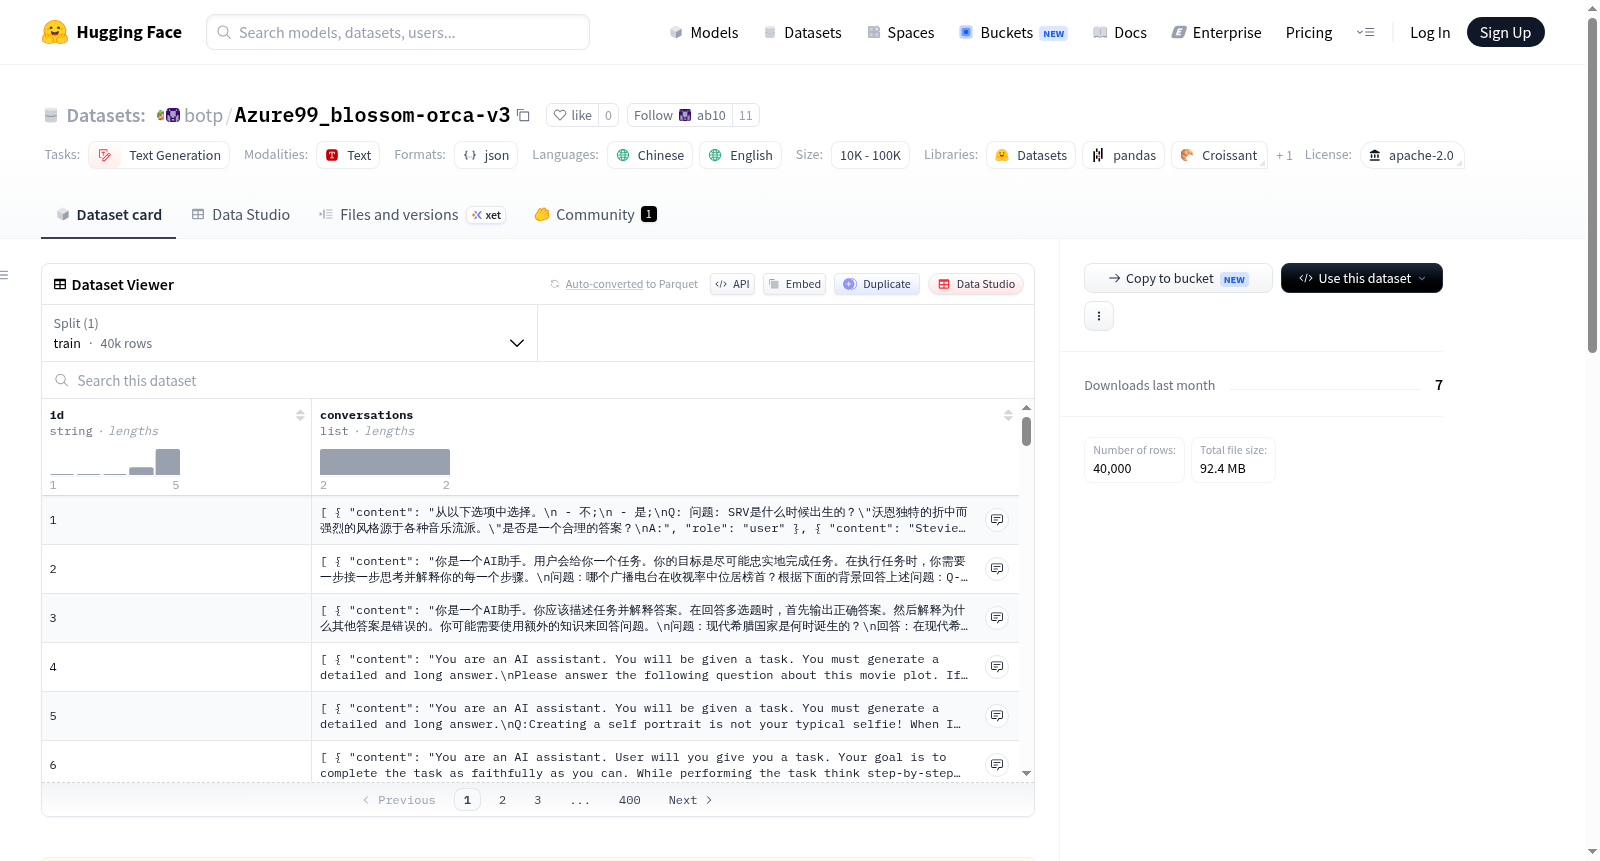
- 每条数据包含一个完整的对话,具有以下字段:
- id:从1递增的唯一标识。
- conversations:对象数组,每个对象包含:
- role:取值为user或assistant,分别代表用户输入和助手输出。
- content:对应的内容。
数据集限制
- 所有响应均由gpt-4-0125-preview生成,未经过严格的数据校验,可能包含不准确甚至严重错误的回答。
- 由于过滤了拒答响应,使用本数据集训练的模型可能不会拒绝非法的请求。
数据集规模
- 本次发布的数据量为全量数据的50%,包含中英双语各20K,共计40K记录。
许可证
- 本数据集遵循Apache-2.0许可证。
数据集应用领域
- 适用于文本生成和文本到文本生成任务。
数据集大小
- 数据集大小介于100K至1M之间。
搜集汇总
数据集介绍
构建方式
Blossom Orca V3数据集是基于OpenOrca衍生而来的中英双语指令微调数据集。其构建过程首先从OpenOrca中抽取系统提示与指令,将其翻译为中文并进行严格校验。随后,利用GPT-4-0125-preview模型生成对应的响应,并过滤掉包含自我认知及拒绝回答的内容。为确保响应风格的一致性与中英数据配比,对未翻译的原始指令也执行相同调用,最终形成1:1的中英双语指令数据,共计40K记录。
特点
该数据集以中文和英文为主,每条数据包含唯一标识id与对话内容conversations两个字段,其中conversations由role(取值为user或assistant)和content组成。相较于直接翻译OpenOrca的中文数据集,Blossom Orca在响应一致性与质量上表现更优。所有响应均由GPT-4生成,但未经过严格校验,可能包含不准确回答,且因过滤了拒答响应,仅使用本数据集训练的模型可能不会拒绝非法请求。
使用方法
本数据集适用于指令微调任务,特别是文本生成与文本到文本生成场景。用户可直接加载数据集,利用其中的中英双语对话对模型进行微调。每条数据包含完整的对话结构,便于构建训练样本。建议在使用时注意数据集的局限性,结合其他数据集或后处理步骤以增强模型的鲁棒性和合规性。
背景与挑战
背景概述
在自然语言处理领域,指令微调是提升大语言模型遵循人类意图能力的关键技术路径。Blossom Orca V3数据集由Azure99团队于近期创建,旨在构建高质量的中英双语指令数据集,以弥补现有双语指令资源的不足。该数据集基于OpenOrca衍生,通过系统化地抽取系统提示与指令,先进行中文翻译与校验,再调用GPT-4-0125-preview模型生成响应,并过滤自我认知与拒答内容。其核心研究问题在于如何通过全GPT-4蒸馏策略,确保双语数据在一致性、质量及配比上的最优平衡。最终发布包含中英各20K条记录的50%全量数据,为指令微调研究提供了可靠资源,对推动多语言大模型的对齐训练具有重要影响力。
当前挑战
Blossom Orca V3数据集所应对的领域挑战在于,现有双语指令数据集常直接翻译原始数据,导致响应风格不一致、质量参差不齐,难以满足模型对齐需求。为此,该数据集采用全GPT-4蒸馏并辅以人工校验翻译,以提升数据一致性。构建过程中面临多重挑战:首先,从OpenOrca抽取指令并翻译为中文时,需确保翻译准确且保留原意,避免语义偏差;其次,调用GPT-4生成响应时,需过滤包含自我认知或拒绝回答的内容,以维持数据纯净度;此外,还需严格平衡中英数据配比至1:1,并保证响应风格统一。最终,因未进行严格数据校验,数据集可能含有不准确或错误回答,且因过滤拒答响应,单独使用本数据集训练的模型可能无法有效拒绝非法请求,构成应用层面的潜在风险。
常用场景
经典使用场景
Blossom Orca V3数据集在自然语言处理领域中最经典的应用场景当属指令微调(Instruction Tuning)。该数据集以OpenOrca为基础,通过GPT-4蒸馏技术生成高质量的中英双语指令数据,为大型语言模型(LLMs)的对齐训练提供了宝贵的资源。在模型微调过程中,研究人员可利用其中精心构建的40K条对话记录,涵盖用户指令与助手响应,有效提升模型对多样化指令的理解与执行能力。数据集中1:1的中英文配比设计,使得模型能够在双语环境中保持一致的响应风格,从而在跨语言任务中展现出更优的泛化性能。这一场景广泛应用于对话系统、智能助手以及多语言NLP模型的开发与优化中。
实际应用
在实际应用中,Blossom Orca V3数据集为构建企业级智能客服、多语言虚拟助手以及自动化内容生成系统提供了坚实的数据基础。通过利用该数据集进行微调,开发者能够训练出在中文与英文环境下均能精准理解用户意图并生成恰当响应的模型。例如,在跨国电商平台的客服机器人中,模型可无缝切换语言处理订单查询、售后咨询等任务;在教育领域,它可用于开发双语辅导工具,支持学生以母语或第二语言获取知识。此外,该数据集的过滤机制确保了模型在合规场景下的表现,使其适用于需要高安全标准的行业,如金融咨询与医疗问诊。
衍生相关工作
Blossom Orca V3数据集的发布催生了一系列衍生研究工作,尤其是在指令微调与模型对齐领域。其基于GPT-4蒸馏的方法论启发了后续研究者探索更高效的知识迁移策略,例如结合强化学习从人类反馈(RLHF)优化响应质量。此外,该数据集的中英双语特性推动了跨语言指令理解模型的比较研究,如对比不同蒸馏来源(如GPT-3.5与GPT-4)对下游任务性能的影响。在模型安全方面,其过滤拒答响应的设计引发了关于模型合规性与伦理边界的讨论,进而衍生出针对敏感内容检测与可控生成的新算法。这些工作共同丰富了大型语言模型在双语环境下的优化路径。
以上内容由遇见数据集搜集并总结生成


