遇见数据集

B-XAIC

收藏
arXiv2025-05-28 更新2025-11-28 收录
官方服务:

资源简介:

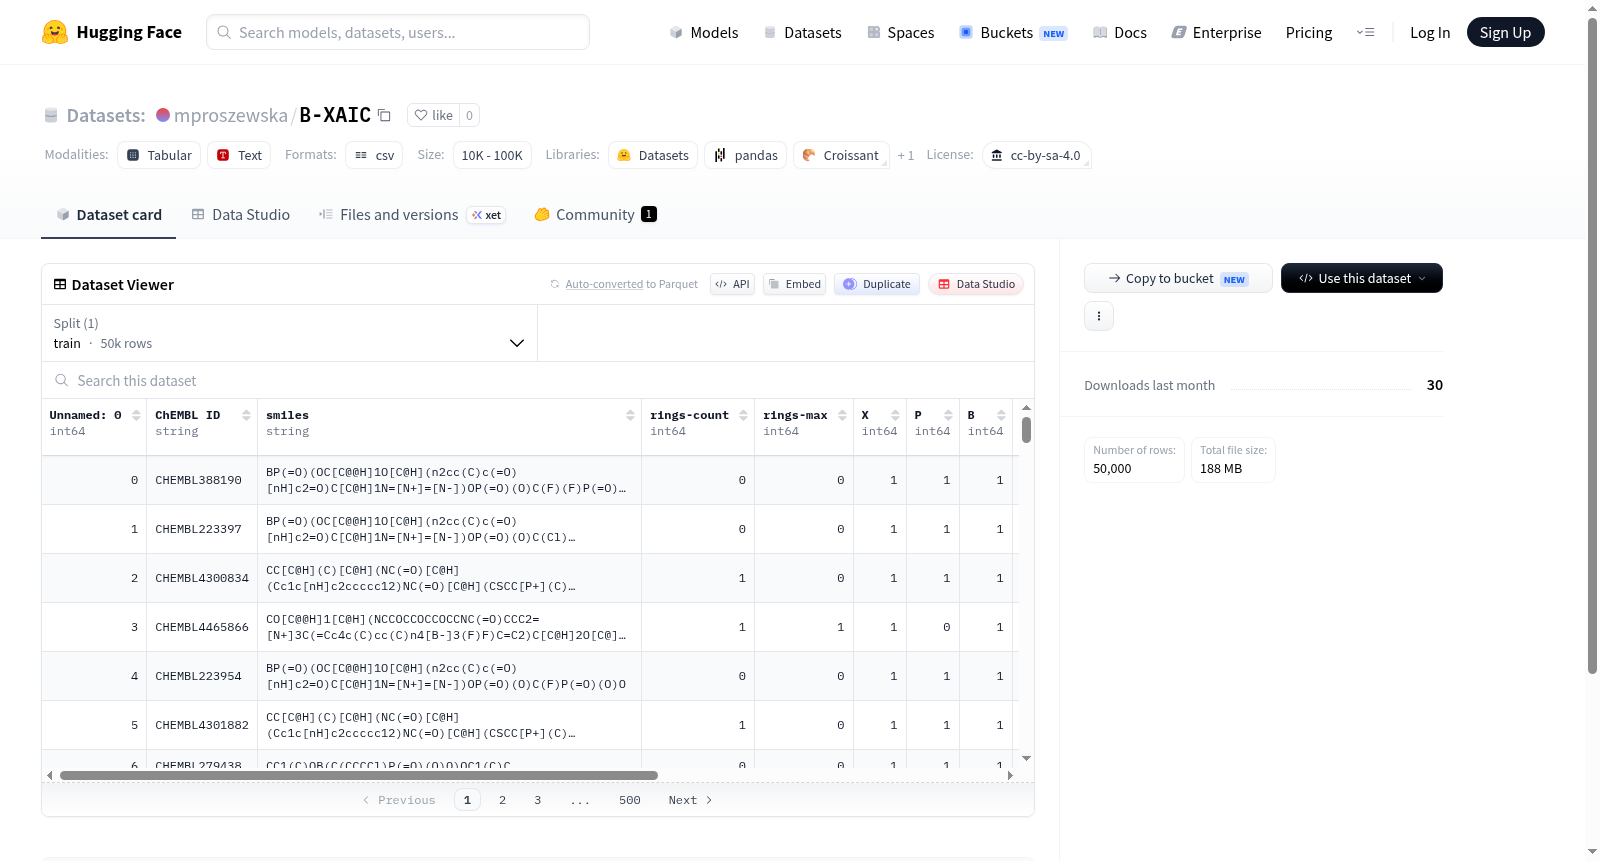
B-XAIC数据集由爱丁堡大学和雅盖隆大学数学与计算机科学学院的研究人员创建,旨在为图神经网络的可解释人工智能(XAI)提供基准。该数据集包含5万个小分子和7个不同的任务,每个任务都配有真实标签和相应的解释,使得基于准确性的度量方法可以直接应用并可靠地评估。数据集来源于ChEMBL 35数据库,通过加权采样方法避免了巨大的类不平衡问题,平均图大小为34.56。数据被随机分为训练、验证和测试集,使用8-1-1的比例。数据集包含每个化合物的二进制任务标签和两个解释标签集,一个用于检测到的模式中的原子,一个用于边缘。B-XAIC数据集提供了对XAI方法进行评估的宝贵资源,有助于深入了解XAI的可靠性,并促进更可靠和可解释模型的发展。

The B-XAIC dataset was created by researchers from the University of Edinburgh and the Faculty of Mathematics and Computer Science of Jagiellonian University, with the goal of providing a benchmark for explainable artificial intelligence (XAI) in graph neural networks. This dataset includes 50,000 small molecules and 7 distinct tasks, each paired with ground-truth labels and corresponding explanations, allowing accuracy-based evaluation metrics to be directly and reliably applied. Derived from the ChEMBL 35 database, the dataset uses weighted sampling to mitigate severe class imbalance issues, with an average graph size of 34.56. The data is randomly split into training, validation and test sets at an 8-1-1 ratio. The dataset contains binary task labels for each compound and two sets of explanation labels: one for atoms in detected patterns, and the other for edges. The B-XAIC dataset offers a valuable resource for evaluating XAI methods, enabling in-depth insights into the reliability of XAI and advancing the development of more reliable and interpretable models.
创建时间:
2025-05-28
搜集汇总
数据集介绍
B-XAIC 数据集图片
构建方式
在化学信息学与药物发现领域,图神经网络的可解释性评估常受限于人工数据集或简化任务,缺乏真实世界的复杂性与解释忠实度的直接关联。为弥补这一空白,B-XAIC数据集应运而生,其构建依托于ChEMBL 35公共数据库中约250万具有类药性的小分子。通过剔除无效或重复的SMILES字符串,并移除溶剂分子与抗衡离子,保留了纯净的分子图结构。基于化学子结构的存在与否,设计了七项难度递增的二元分类任务,涵盖单原子检测(硼、磷、卤素)、双环结构识别(吲哚)、复杂多模式预警结构(PAINS)以及环计数与环尺寸判别。采用加权采样策略以平衡各类别分布,最终从预过滤的分子池中抽取50,000个样本,并按8:1:1比例随机划分为训练、验证与测试集。每个分子均附带原子与边的解释标签,精准标注了与任务相关的子结构。
特点
B-XAIC数据集的核心特点在于其兼具真实世界的分子复杂性与结构衍生的真实解释标注,从而实现了对可解释性方法忠实度的直接量化评估。与依赖阈值或top-k选择的传统评价范式不同,该数据集创新性地引入两类解释场景:空解释(Null Explanations),即当分子中不含目标子结构时,所有节点与边的重要性应均匀分布;子图解释(Subgraph Explanations),即当目标子结构存在时,需精准定位相关节点与边。这种二元划分有效规避了任意阈值选择带来的偏差,使得基于AUROC与平均精度的度量天然适用。此外,数据集涵盖从简单原子到复杂环系的七种化学模式,难度梯度清晰,且分子多样性通过Tanimoto相似性分布得到验证,平均图大小为34.56个节点,确保了评估的全面性与挑战性。
使用方法
使用B-XAIC数据集进行可解释性评估时,研究者需首先训练图神经网络模型(如GCN、GAT、GIN或原型网络ProtGNN)完成七项分类任务,并记录其预测性能。随后,针对训练好的模型应用各类事后解释方法(如GNNExplainer、Saliency、IntegratedGradients等)或内在可解释模型,获取每个样本的节点与边重要性分数。评估过程分为两个独立分支:对于空解释样本,采用四分位距法检测解释分数中是否存在异常离群值,若不存在则判定为合格;对于子图解释样本,则直接计算AUROC以衡量模型对相关子结构的优先级排序能力。最终,通过汇总各任务上的空解释与子图解释得分,可全面对比不同可解释性方法在忠实度与定位精度上的表现,为开发更可靠的分子图可解释AI提供基准参照。
背景与挑战
背景概述
在化学信息学与药物发现领域,图神经网络(GNN)已成为小分子性质预测与虚拟筛选的标准工具,其卓越的预测能力已得到广泛验证。然而,模型的决策过程往往缺乏透明度,这严重制约了研究者的信任建立与潜在科学洞察的挖掘。为应对可解释人工智能(XAI)评估中普遍存在的人造数据集依赖、任务简化及指标与解释忠实度脱节等问题,Magdalena Proszewska、Tomasz Danel及Dawid Rymarczyk等研究人员于2025年构建了B-XAIC基准数据集。该数据集基于ChEMBL 35数据库,精选5万个小分子及7项结构检测任务,每个样本均配备基于化学亚结构的地面真理解释,旨在为GNN的XAI方法提供真实、可量化的评估平台,对推动可解释性与模型可靠性研究具有重要影响力。
当前挑战
B-XAIC数据集所应对的核心挑战在于现有XAI评估框架的局限性。领域问题层面,当前方法在处理分子图时,常面临阈值化重要性图或选择top-k元素导致的解释不准确问题,尤其当任务依赖亚结构的存在与否时,无单一元素可被认定为更重要,使得AUROC等指标失效。构建过程中,研究者需克服从真实分子数据中获取地面真理解释的固有困难,通过设计基于化学亚结构(如卤素、吲哚、PAINS模式)的多样化任务,并引入空解释与子图解释两类场景,分别评估解释的均匀性与局部化能力,从而实现对XAI方法忠实度的严格检验。这一挑战的解决为开发更可靠、可解释的GNN模型奠定了关键基础。
常用场景
经典使用场景
在化学信息学与药物发现领域,图神经网络(GNN)已成为小分子性质预测的核心工具,然而其决策过程的可解释性始终是制约模型可信度的关键瓶颈。B-XAIC数据集应运而生,它从ChEMBL数据库中精心筛选了5万个小分子,并设计了七项涵盖原子检测、子结构识别及环计数等不同难度的化学任务。该数据集最经典的使用场景在于为GNN的可解释性方法提供标准化的评估基准,通过提供原子和边级别的真实解释标签,使得研究者能够直接量化各类解释方法的忠实度与准确性。
解决学术问题
B-XAIC数据集有效解决了当前GNN可解释性评估中依赖合成数据或简化任务而缺乏真实世界复杂性的学术困境。传统评估方法常受限于阈值选取或top-k元素选择的主观性,导致解释质量度量失真。该数据集通过引入空解释与子图解释的双轨评估机制,分别针对无显著子结构和有特定子结构两种情形,采用AUROC与四分位距法进行客观评价,从而为比较事后解释器与内在可解释模型提供了公平且可靠的学术研究平台。这一基准的建立深刻揭示了现有XAI方法在分子图上的系统性局限,推动了更忠实、更鲁棒的解释方法的发展。
衍生相关工作
B-XAIC数据集的发布催生了一系列重要的衍生研究工作。受其双轨评估框架启发,研究者进一步探索了活动悬崖场景下的解释方法,推动了解释技术从静态子图定位向动态化学差异识别的演进。该基准促进了基于原型的内在可解释GNN架构(如ProtGNN)的改进,并推动了梯度类与掩码类解释器在分子图上的适应性优化。此外,B-XAIC为图核方法、信息瓶颈理论等前沿方向提供了验证平台,其关于模型性能与解释质量相关性的发现,直接引导了后续关于消息传递机制对解释准确性影响的深入分析,形成了可解释GNN领域的重要知识体系。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务